 Newshot
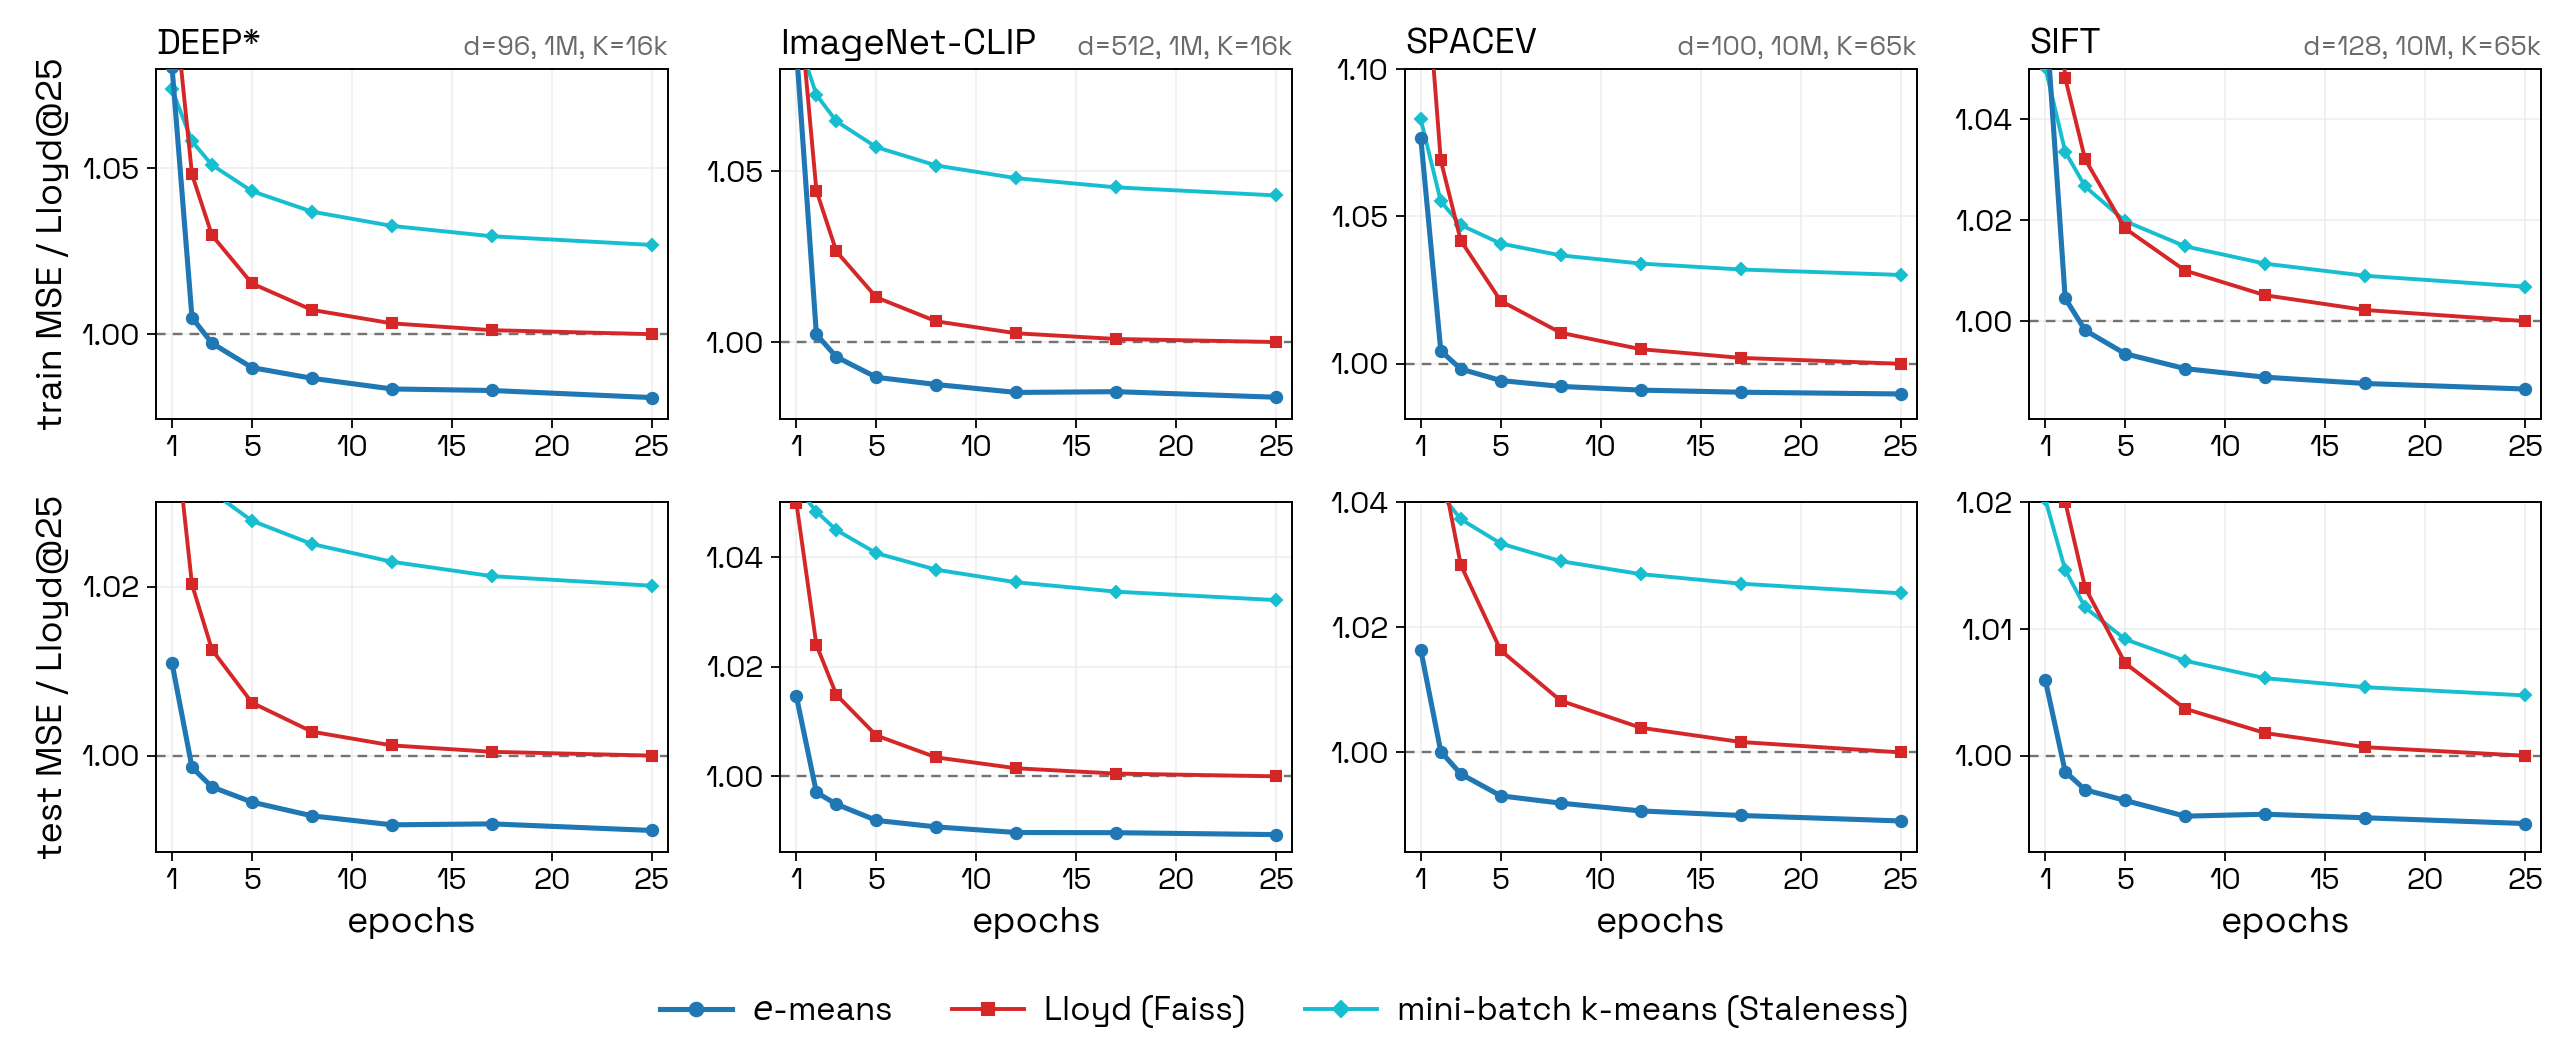
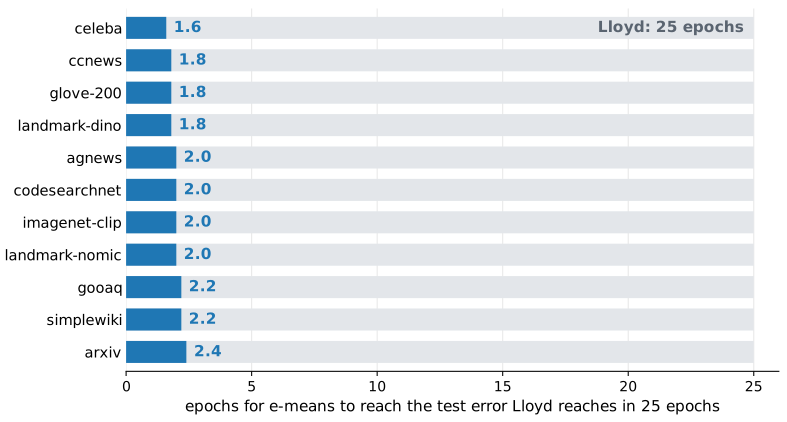
少一个数量级的轮次
在大量规模和数据集上,e-means 在 1.2 到 3 个轮次内达到的测试损失,低于 Lloyd's
文章标题:e-means:损失相同的情况下,k-means 快 10 倍
正文: e-means 在小批量上工作,并用指数移动平均替代这个求和:
于是较旧的分配以 α 的速率被遗忘,质心跟踪的是最近的分配,而非整个历史。这种更新规则通常用于移动分布,因此被采用于训练 VQ-VAE[6]。我们发现,如果将其与 e-means 的其他组件结合,并适当调优超参数,它对静态数据集也极其高效。
e-means 项目始于 Meta FAIR 此前由 Hugo Touvron 和 Hervé Jégou 所做的工作,他们发现通过梯度下降的小批量 k-means 可以胜过 Lloyd 算法。虽然我能复现这些结果,但我发现基于梯度下降的质心更新在大学习率下性能不稳定,而指数移动平均更新则不然。我怀疑这是因为 EMA 更新保证质心始终处于分配给它的点的凸包内,而梯度下降更新可能越过该凸包。
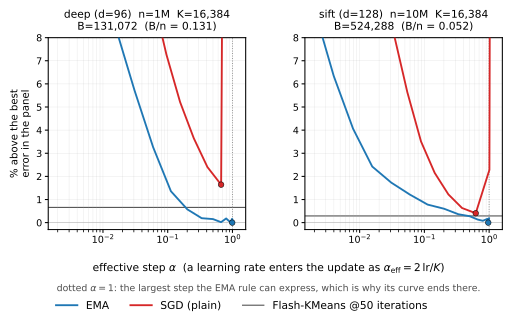
为了在固定轮数下达到最低损失,我们选择了指数移动平均更新,因此我们的方法得名 e-means。
如果将批量设为整个数据集,B = n,且 α = 1,那么 Nj 和 Sj 就恰好成为整个簇的计数与求和,因此一次 e-means 迭代就恰好等于一次 Lloyd 迭代。Lloyd 是 e-means 在没有对学习率做余弦调度时的极端情形。然而,我们的超参数搜索发现,这种极端设置是高度次优的,这解释了为什么 e-means 在很大程度上优于 Lloyd。下图针对每个批量大小 B 和步长 α 测量了损失:Lloyd 落在角落里,远在损失最低的区域之外。
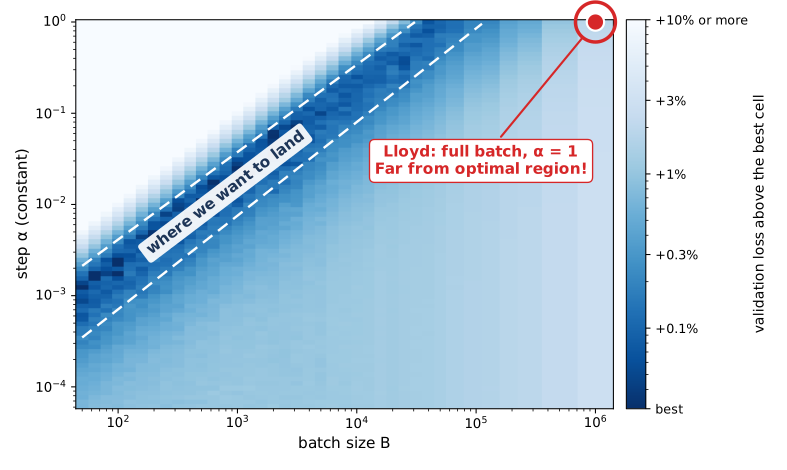
这项超参数研究促使我们推导出缩放定律,以自动选取最优的批量大小 B 和步长 α。
e-means 更能逃离局部极小值
为了更好地理解为什么 e-means 在收敛时比 Lloyd 达到更好的损失,我们在玩具数据集上绘制了几次训练,以评估它们逃离局部极小值的能力。在 200 个种子上重复训练,我们发现与 Lloyd 相比,e-means 落入病态配置的可能性要小得多。
我们对此的解释是,小批量提供了更多带噪声的更新,更有可能探索优化景观并逃离局部极小值。而 Lloyd 由于其损失始终下降,更有可能利用已找到的局部极小值而永不逃离。
用缩放定律自动调优超参数
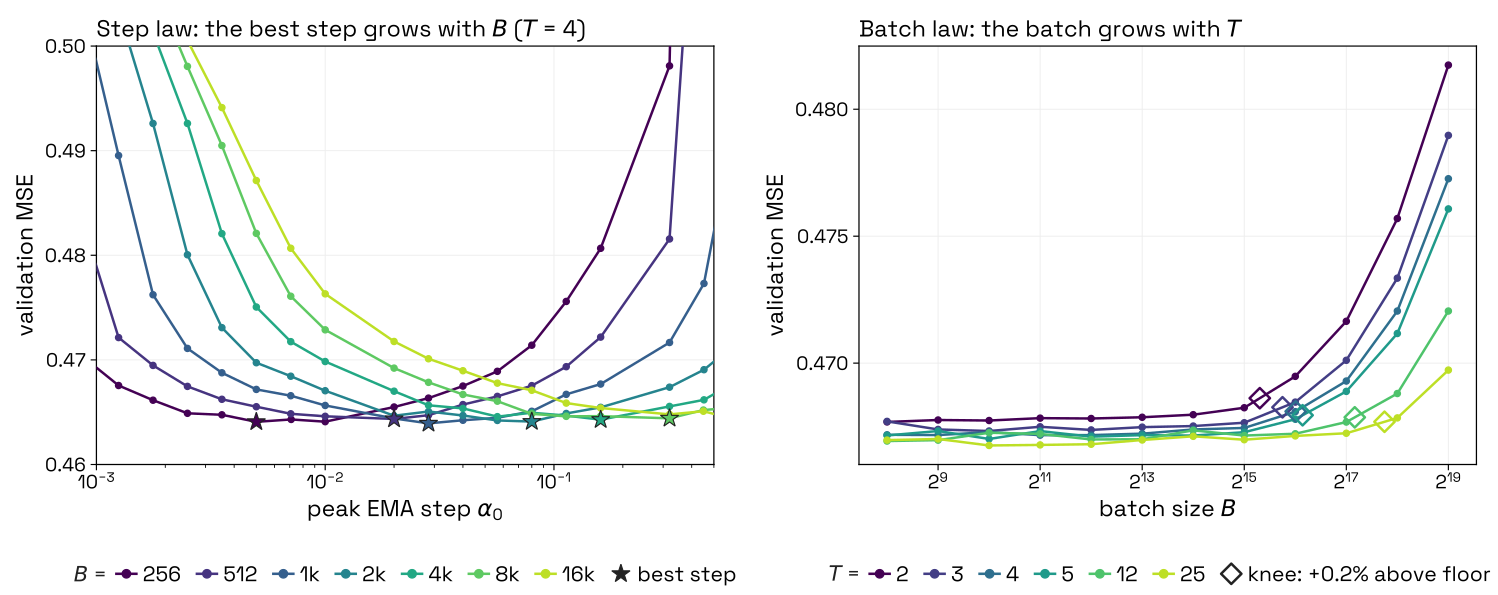
e-means 的一个关键特性是,与 Lloyd 算法相比,实践者无需设置任何额外的超参数。我们拟合了两条缩放定律,以从任何问题的特征(n、k、T)设定批量大小 B 和步长 α0,并发现它们在未见过的数据集和问题规模上表现出很强的泛化能力。
| 定律 | 常数 | 指数 | 留出数据集上的 regret | 留出规模上的 regret | R² | |||||
|---|---|---|---|---|---|---|---|---|---|---|
| k | B | n | T | |||||||
| 步长 α 0 | 0.824 | −0.46 | 0.90 | −0.45 | −0.11 | 0.07% | 0.07% | 0.95 | ||
| 批量 B ,默认 | 0.035 | 0.13 | n/a | 0.88 | 0.81 | 0.19% | 0.20% | 0.96 | ||
| 批量 B ,质量定律 | 0.0044 | 0.13 | n/a | 0.88 | 0.81 | 0.07% | 0.06% | n/a |
Regret = (使用定律的 MSE − 网格上的最佳 MSE)/ 最佳 MSE,取各配置的中位数。留出数据集:SIFT、SPACEV,以及 VIBE[9] 数据集 arXiv 和 AG-News。留出规模:从拟合中留出一个 n 值并进行预测。
我们提出两个公式来选择批次:默认法则与质量法则。“质量法则”相较“默认”法则,会牺牲吞吐量来换取更好的聚类质量。下面我们绘制了缩放定律的训练数据:验证 MSE 随步长 α0(左)和批量大小 B(右)的变化。
死簇复活的重要性
展示死簇复活重要性的玩具示例。
小批量 k-means 的主要问题是它容易产生“死”簇,即在优化过程中最终没有任何点被分配到的质心。这会缩小码本的有效规模,而对于当今越来越多使用的大码本来说,这一问题尤为严重。
一种常见的缓解方法是重新初始化低于某个规模阈值的簇,正如 EnCodec[10] 所做的那样:死质心直接被替换为从传入批次中随机抽取的样本。这虽然有所帮助,但并未完全解决问题。我们不是从批次中采样任意点,而是通过拆分已有的大簇来复活死簇:我们按与簇大小成比例的概率采样一个活跃簇,并将其一分为二。我们发现,这种改编自 Faiss k-means 的方法在消除死簇和保留码本容量方面明显更为有效。
| 数据集 | 复活策略 | 死簇数 | 占码本比例 | 不平衡度 | 测试 MSE |
|---|---|---|---|---|---|
| DEEP | 按比例拆分 | 47 | 0.3% | 1.194 | 0.38762 |
| 从批次重采样(EnCodec) | 2,343 | 14.3% | 1.423 | 0.39124 | |
| 关闭 | 4,313 | 26.3% | 1.647 | 0.39448 | |
| SIFT | 按比例拆分 | 10 | 0.1% | 1.186 | 0.19623 |
| 从批次重采样(EnCodec) | 750 | 4.6% | 1.233 | 0.19684 | |
| 关闭 | 2,080 | 12.7% | 1.404 | 0.19797 |
100 万向量,k = 16,384,5 个 epoch,5 个随机种子的均值;仅复活策略不同。若某个簇在结束时被分配到的向量少于十个(即平均簇大小的千分之一),则该簇计为死簇。不平衡度:簇大小的不均衡程度(1 = 完全相等)。摘自论文的复活消融表。
广泛的实验验证
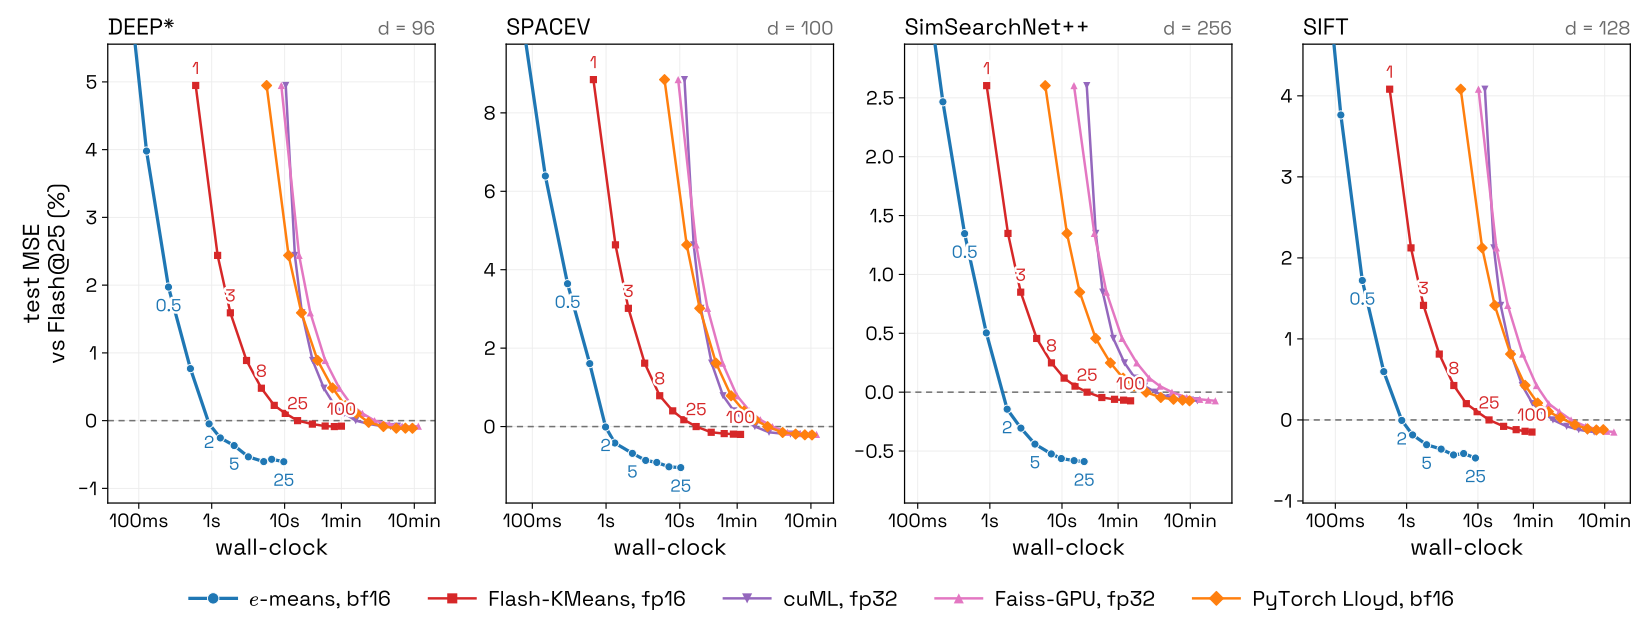
我们在 24 个不同的嵌入数据集和合成数据集及配置上验证了 e-means(见论文)。为制作视频,我们针对 k-means 运行了 234 种 e-means 配置(16 个数据集,10 万到 1 亿个点):在结果映射中探索每一条曲线。
库与代码
仓库:faiss/contrib/e_means。
引用本工作
如果你使用 e-means,请引用论文(arXiv:2611.09501):
参考文献
- M. Douze, A. Guzhva, C. Deng, J. Johnson, G. Szilvasy, P.-E. Mazaré, M. Lomeli, L. Hosseini, H. Jégou. "The Faiss library." arXiv:2401.08281, 2024. ↑
- S. Yang, H. Xi, Y. Zhao, M. Li, X. Fan, J. Zhang, H. Cai, Y. Lin, X. Li, K. Keutzer, S. Han, C. Xu, I. Stoica. "Flash-KMeans: Fast and Memory-Efficient Exact K-Means." arXiv:2603.09229, 2026. ↑
- J. MacQueen. "Some Methods for Classification and Analysis of Multivariate Observations." Proceedings of the Fifth Berkeley Symposium on Mathematical Statistics and Probability, 1:281–297, 1967. ↑
- D. Sculley. "Web-Scale K-Means Clustering." WWW, 2010. ↑
- J. Newling, F. Fleuret. "Nested Mini-Batch K-Means." NeurIPS, 2016. ↑
- A. van den Oord, O. Vinyals, K. Kavukcuoglu. "Neural Discrete Representation Learning." NeurIPS, 2017. ↑
- S. Lloyd. "Least squares quantization in PCM." IEEE Transactions on Information Theory, 28(2):129–137, 1982 (circulated as a Bell Labs technical note since 1957). ↑
- X. Zhu, J. Sun, Z. He, J. Jiang, Z. Wang. “Staleness-Reduction Mini-Batch K-Means.” IEEE Transactions on Neural Networks and Learning Systems, 35(10):14424–14436, 2024. ↑
- E. Jääsaari, V. Hyvönen, M. Ceccarello, T. Roos, M. Aumüller. “VIBE: Vector Index Benchmark for Embeddings.” arXiv:2505.17810, 2025. ↑
- A. Défossez, J. Copet, G. Synnaeve, Y. Adi. “High Fidelity Neural Audio Compression.” Transactions on Machine Learning Research, 2023. arXiv:2210.13438. ↑
像 {{NAME_ab12cd34}} 这样写出的值是真实值的占位符。请完全按原样使用它们,在回复和工具调用中都是如此:它们会在任何内容运行之前被填入真实值。不要要求验证它们,也不要用示例替换它们。