 Newshot
为什么我们需要一个以数据为中心的 AI 操作系统
任何人自称是 AI 操作系统的创造者,都是相当大胆的说法。很多人都这么做过,但由于架构重心正从原始计算转向复杂的数据——不只是存储——最终只有一两家会获得市场关注,并成功卖出 AI 操作系统。
Jensen Huang,Nvidia 的联合创始人兼首席执行官,在 3 月的主题演讲中开始将其 Dynamo AI 推理栈称为 AI 操作系统——严格来说,他称其为 AI 工厂的操作系统——我们把这个想法先搁置起来,留待进一步思考。但上周,Vast Data,这家新锐闪存存储厂商,在其之上叠加各种软件,把它变成迄今为止所称的“数据平台”,宣称它实际上已经创造了 Vast AI Operating System。这让我们又多想了一些。
Nvidia 和 Vast Data 所谈论的,与我们同样预期会看到的东西——一个由 AI 驱动的操作系统——不同,但也许最终会交织在一起。我们现在不是在谈这个。需要明确这一点。
我们谈论的是运行在我们假定将是商用硬件的之上的一层软件,它允许公司运行已有的 AI 应用,或自行创建应用,或两者混合。
计算作为宇宙的中心
要说“数据中心”尽管名字如此,过去六十年却一直痴迷于计算,这还算是轻描淡写。
1964 年最初的 IBM System/360“中央处理器”——其架构自那时起几乎定义了计算——被安置在“主机架”中,并配有一堆外设,用于在屏幕上显示数据、在磁带驱动器和磁盘盘片上存储和读取数据,以及把数据打印成报告和其他类型的文档,比如发票或物料清单。这些大型机被放进“玻璃房”,以便高管们展示自己的技术实力。
大型机中的这些 CPU 实际上处于系统的核心,数据在这里被处理,应用程序也在这里与外部世界交互。这整套东西早在被称为“信息技术”之前就被称为“数据处理”,这或许是最恰当的说法,因为就像 Einstein 的统一时空概念——物质告诉时空如何弯曲,时空告诉物质如何运动——最初“数据”和“处理”的地位是相等的。
但是,存储历来比计算容易得多,也更便宜。但近几十年来,随着更多种类的数据变得可用,而这种多样性又是驱动业务所必需的——更复杂的关系型和 NoSQL 数据库、Hadoop 以及其他用于海量非结构化数据的存储——有很多公司收集了海量数据宝藏,先把它变成“大数据”来驱动我们的互联网体验,然后通过生成式 AI 算法,在人类自己创造和处理的所有媒介中教互联网“思考”并展示其“想法”,除了触觉、嗅觉和味觉。静态图像(视觉)、文本(一种伴随内心听觉的视觉)、声音和视频(运动的图像,通常还有声音)。嗅觉和味觉密切相关,所以也许人类实际上只有四种感官。最终,我们估计会有人更好地让人形机器人也体验并传递这些感官。
这让我们不禁去想:如果从一开始计算就更便宜、更容易,而数据是流程的中心——正如 Vast Data 暗示其面向 AI 的操作系统应该做到的那样——会发生什么。
我们需要一个以数据为中心的 AI 操作系统(2025)
在深入讨论之前,我们所说的操作系统究竟指什么?我们与它们相伴已久,它们的安装和更新如此自动化,以至于它们有点像我们呼吸的空气一样无形。
早在时间之初——20 世纪 90 年代末——我们把“Linux”称为“操作系统”,结果遭到了 Richard Stallman 的训斥,他不是别人,正是 GNU 项目的守护圣徒、许多可在各种 Unix 内核上运行的系统软件组件和编译器的创造者。他解释说,Linux 只是一个操作系统内核,是 GNU 和其他代码片段把 Linux 变成了一个操作系统。我们听了这个论点并表示同意,但继续把 Linux 称为操作系统,因为世界就是这么谈论它的。无论如何,Linux 是最后一个进入市场的主流以计算为中心的操作系统,并且可能将是我们有生之年创造的最后一个。Linux 将以多种形式继续存在于各种设备上——用于笔记本电脑和智能手机的 Android、用于服务器的 RHEL 和 SUSE,等等。
所以,你从一个内核开始,然后在它周围包装设备驱动程序和其他服务(存储、网络等等)来创建一个操作系统。在数据中心,这个操作系统运行在服务器、存储和网络设备上。一台服务器或一组服务器,连同分布式计算软件和用于加速它的硬件(NIC 和 DPU),再加上交换和存储(用于在服务器之间移动数据以及存储数据供服务器处理使用的设备),构成一个基础系统。
一个完整的系统包括系统软件——数据库、中间件和其他更高层级的程序,包括编程语言运行时——它允许系统运行应用程序,这些应用程序由客户自己创建,或由第三方专家创建,或由两者混合创建。应用程序以下的所有东西我们称为平台,而正如本出版物的名称所暗示的,我们一直在寻找它们。
并非
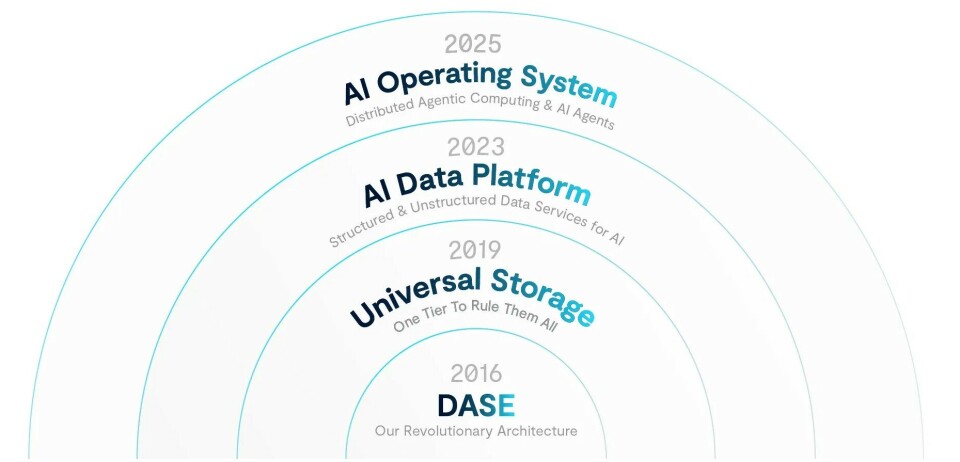
但我们认为 Vast Data 的不同之处在于,它首先聚焦于数据,以及数据为了对 AI 智能体有用而需要被存放、格式化、访问、操作和分发的多种方式。老式计算架构采用自上而下的方法,为了把多种数据源送入单一计算范式而制造了复杂性。Vast Data 通过其面向 AI 的操作系统所做的,是用其针对闪存调优的元素存储和分离式共享一切(DASE)存储架构,掩盖各类数据的底层复杂性,以扩展到大量数据,并以 AI 应用可能需要的几乎任何形式呈现这些数据。这是一种自下而上的方法,把数据做对才是真正的差异化。任何人都能做计算。好吧,至少任何叫 Nvidia 和 AMD 的人都能,可能还有 HiSilicon。
或许这是为 AI 打造操作系统的唯一方式
鉴于所有这些关于操作系统和平台的讨论,我们询问了公司联合创始人兼首席执行官 Renen Hallak,为什么 Vast Data Platform——一种被架构为文件、块或对象存储的闪存存储,最近又成为关系型和向量数据库以及虚拟 Kafka 流集群——会进一步扩展为面向 AI 的操作系统。而且重要的是,为什么它不被称为 AI 平台。
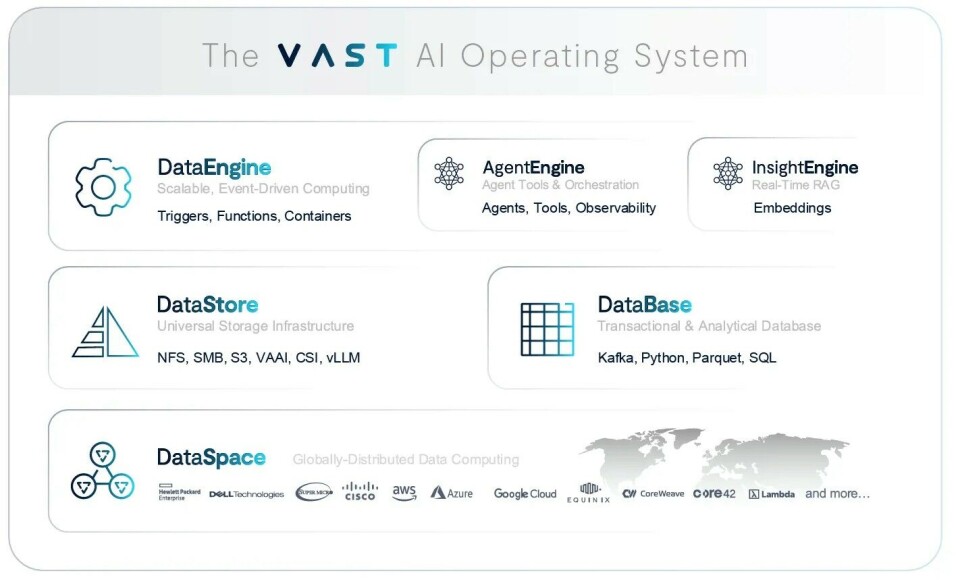
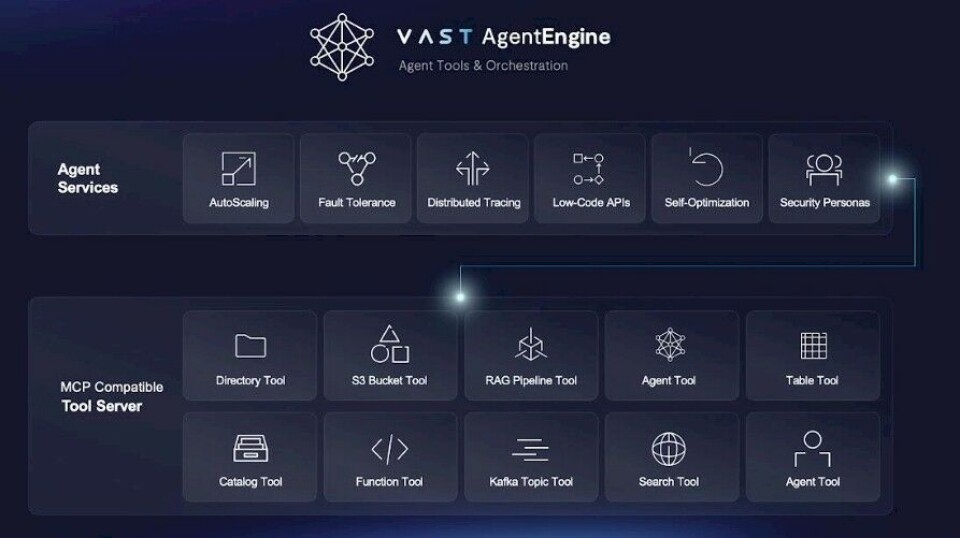
“我认为这个想法是要强调这样一个事实:它是所有软件基础设施部分,”Hallak 对 The Next Platform 表示。“它不只是存储解决方案,也不只是数据库——它还包括运行时,也包括安全。但面向 AI 的操作系统也是你管理和观测 AI 的方式,所以当你想知道 Agent A 三年前和 Agent B 谈了什么时,你可以进入持久化的 Kafka 流并审计它,准确知道发生了什么。面向 AI 的操作系统还关乎在这个栈内实现智能体之间的通信,以及人与智能体之间的通信。这是智能体与自然世界之间的通信。但更重要的是,它不只是存储,也不只是数据库。存储是非结构化部分——所有信息通过传感器流入时的样子。它也是随着时间累积的所有记忆、历史数据,数据库从中提炼意义并生成洞察,理解流入的所有这些图片、声音和文字中有什么。但现在我们需要其他一切。我们需要能够发现和识别新的智能体,管理它们彼此交互的能力,并根据它们在和谁对话来限制它们能做什么和不能做什么。所有这些操作都应该被编排和调度,并成为这个面向 AI 的操作系统的一部分。”
而你还以为 Vast Data 只是要把磁盘赶出数据中心,或者让闪存更快更便宜,或者让 NFS 再次变酷并让其他文件系统变得不再必要,或者模糊存储与数据库之间的界限。
无论如何,我们认为每个人总是会被拉向价值链上游,因为利润就在那里。这就是为什么很少有现代存储厂商自己制造硬件,也是为什么 Vast Data 多年前就停止了制造硬件设备。仍有一些存储厂商确实还在制造硬件。但大多数只是把存储运行在标准硬件上,然后在集群存储内的计算上运行服务。Vast Data 有各种硬件合作伙伴关系,为其软件提供可运行的硬件,其中包括用于存储数据的 D-Node 和用于执行各种计算的 C-Node,它们都接入一个单一分布式但分离式的命名空间,将数据和管理数据所需的工作分散到大量设备上,以提高吞吐量并降低延迟。C-Node 还支持 Kubernetes 容器,使应用可以直接在 DASE 集群中数据旁边运行。
我们需要一个以数据为中心的 AI 操作系统(2025)
Hallak 表示,Vast Data 现在有一大批研发人员在创建智能体,并把它们串联起来形成工作流——也就是我们可能称之为应用的东西。几周前在 Computex 上,Huang 的主题演讲中就展示了一个这样的智能体应用。Vast Data 并不想成为应用供应商,但它必须创建一些应用,来展示其“面向 AI 的操作系统”的强大与易用,并理解客户将会遇到的问题。
据我们所知,这个面向 AI 的 OS 将作为完整 Vast Data 栈的一部分打包提供,但我们完全有理由相信,该公司最终会允许用兼容但不同的模块替换 OS 框图中的不同模块,这很像 Linux 发行版允许在其发行版内使用多种文件系统和数据库。作为一家相对年轻且规模较小的公司(成立六年、拥有近 1,000 名员工、估值 100 亿美元),Vast Data 不得不在一段时间内限制其支持矩阵。
随着公司推进这个面向 AI 的 OS,我们要提醒它:客户想选择的“同类最佳”组件与 Vast Data 构建其栈时采取的一体化方式之间,始终存在张力。到了某个时候,面向 AI 的 OS 会像 Linux 一样扩大其支持矩阵。此外,我们要指出,一体化并不意味着默认包含、默认计费。你可以集成一个平台或操作系统,而不对每个组件收费,甚至不捆绑每个组件。一个一体化的平台或操作系统应该允许单点选配,而不应像法国人说的 table d’hôte 那样——字面意思是“主人的餐桌”,大致等同于 prix fixe,即固定菜单固定价格。灵活性越大越好。
但显然,Vast Data 希望在企业客户如今进行分析和 AI 工作时使用的众多硬件设备和软件栈中,获得更大的钱包份额。
“随着时间的推移,我们业务对应的预算正更多地转向软件,更少地转向硬件,”Hallak 解释道。“原因在于,我们提供着越来越多的栈组件,因此我们正在取代越来越多旧的软件系统。我们看到的另一个效应是,硬件的单位容量价格持续下降,但硬件容量的增长如此之快,以至于包括软件在内的平均交易规模增长得更快,因为我们正在从栈中越来越多的部分夺取钱包份额。它不再只是取代存储系统、数据库、编排层或用于 Kafka 的流式系统。现在它是所有这些。因此我们的软件相应地增长,硬件则相应地收缩。”
最后一点。操作系统往往诞生于奇怪的地方。C 编程语言及其第一个应用——Unix 操作系统——之所以出现,是因为 AT&T 需要一种更高效的方式来生成电话账单。Windows,以及由此而来的 Windows Server,来自西雅图一个毛头小子,他编写了一个 BASIC 编译器,并且在 IBM 懒得为自己的 PC 产品线开发操作系统时,恰好在正确的时间出现在了正确的地点。那么,为什么一家存储和数据管理厂商不能创建一个面向 AI 的操作系统呢?这和我们见过的其他事情一样合理。而且显然,我们需要一个这样的系统。