 Newshot
Amplitude 一直帮助团队了解人们实际如何使用他们的产品。其主动式产品智能体 Wave 帮助团队将这些洞察转化为已上线的改进。Amplitude 称 Wave 大约 80% 由 OpenAI 模型驱动,包括 GPT‑6.1 Sol、GPT‑6 Luna 和 GPT‑Image‑2.5 Flare。Wave 将产品洞察转化为实施计划,团队可以将其发送给包括 Codex 在内的编程智能体,然后衡量影响。
Amplitude 估计,Wave 可以帮助团队在 1–2 天内上线产品改进,而此前大约需要一个月。在 Amplitude 自己的主页上,Wave 帮助实现了个性化建议卡片,推动由卡片驱动的发送量提升了 160%。
“AI 现在能找到我们从未想过要交给它的有用工作。OpenAI 的模型可以调查问题、编写并运行代码,并利用结果决定下一步尝试什么。”
从产品数据到上线改进
Wave 是 Amplitude 的主动式产品智能体。团队给它一个产品领域,以及他们想要改进的目标和指标。Wave 汇集 Amplitude 数据、会话回放、客户反馈和代码,以识别机会并确定优先级、制定解决方案,并与人员和编程智能体协调实施。然后它跟踪结果,并利用这些经验为下一轮改进提供依据。
在这一工作流背后,Amplitude 针对不同任务使用不同的 OpenAI 模型。GPT‑6.1 Sol 支持机会管理器以及对代码和数据的深入调查。GPT‑6 Luna 处理频繁、成本较低的任务,例如扫描代码和运行小型评估检查。GPT‑Image‑2.5 Flare 使用会话回放中的截图作为视觉参考生成产品原型图。
当某个机会准备好构建时,团队可以直接从 Wave 将其发送给包括 Codex 在内的编程智能体,并附带技术计划和验收标准来指导实施。
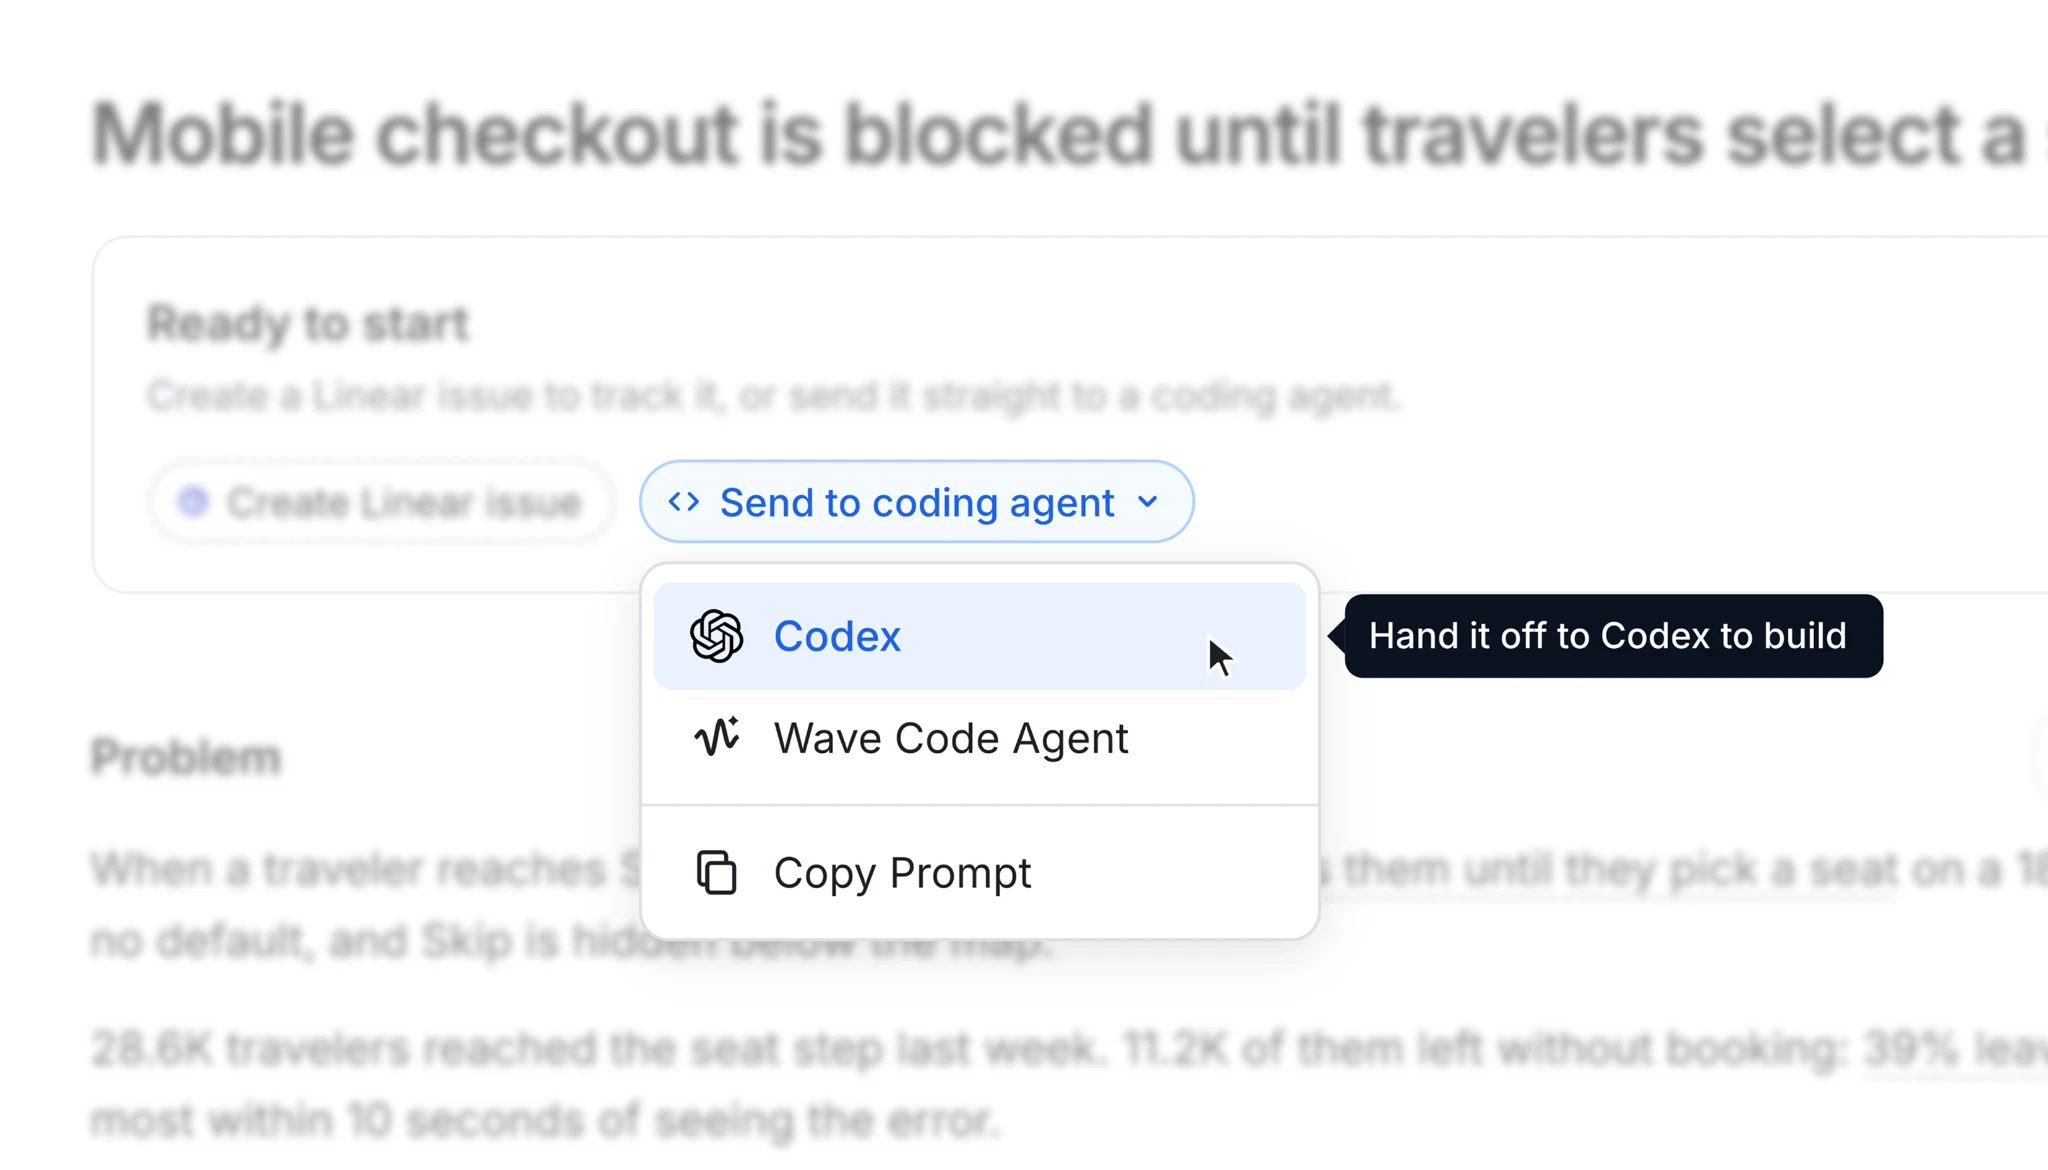
Wave 如何推动智能体参与度提升 160%
“Wave 的理念是,你有一个统一平台,平台上的智能体会梳理大量会话回放、分析数据和代码,以寻找改进产品的机会,”Amplitude 首席 AI 产品经理 Jacob Newman 解释道。
Amplitude 在自己的主页上测试了 Wave,那里通用建议卡片原本旨在帮助用户与 AI 智能体开始对话。Wave 发现人们经常会绕过这些卡片:在 100 个会话回放的样本中,80 名用户自己输入了问题,只有 12 名用户选择了建议。
Wave 提议使用最近的图表、仪表盘或用户来源页面来个性化这些卡片。它说明了这一变更并制定了技术计划,包括保留自由输入,以及在个性化上下文不可用时显示通用建议。经过简短审查后,团队将这项工作交给编程智能体,并对该变更进行了 A/B 测试。
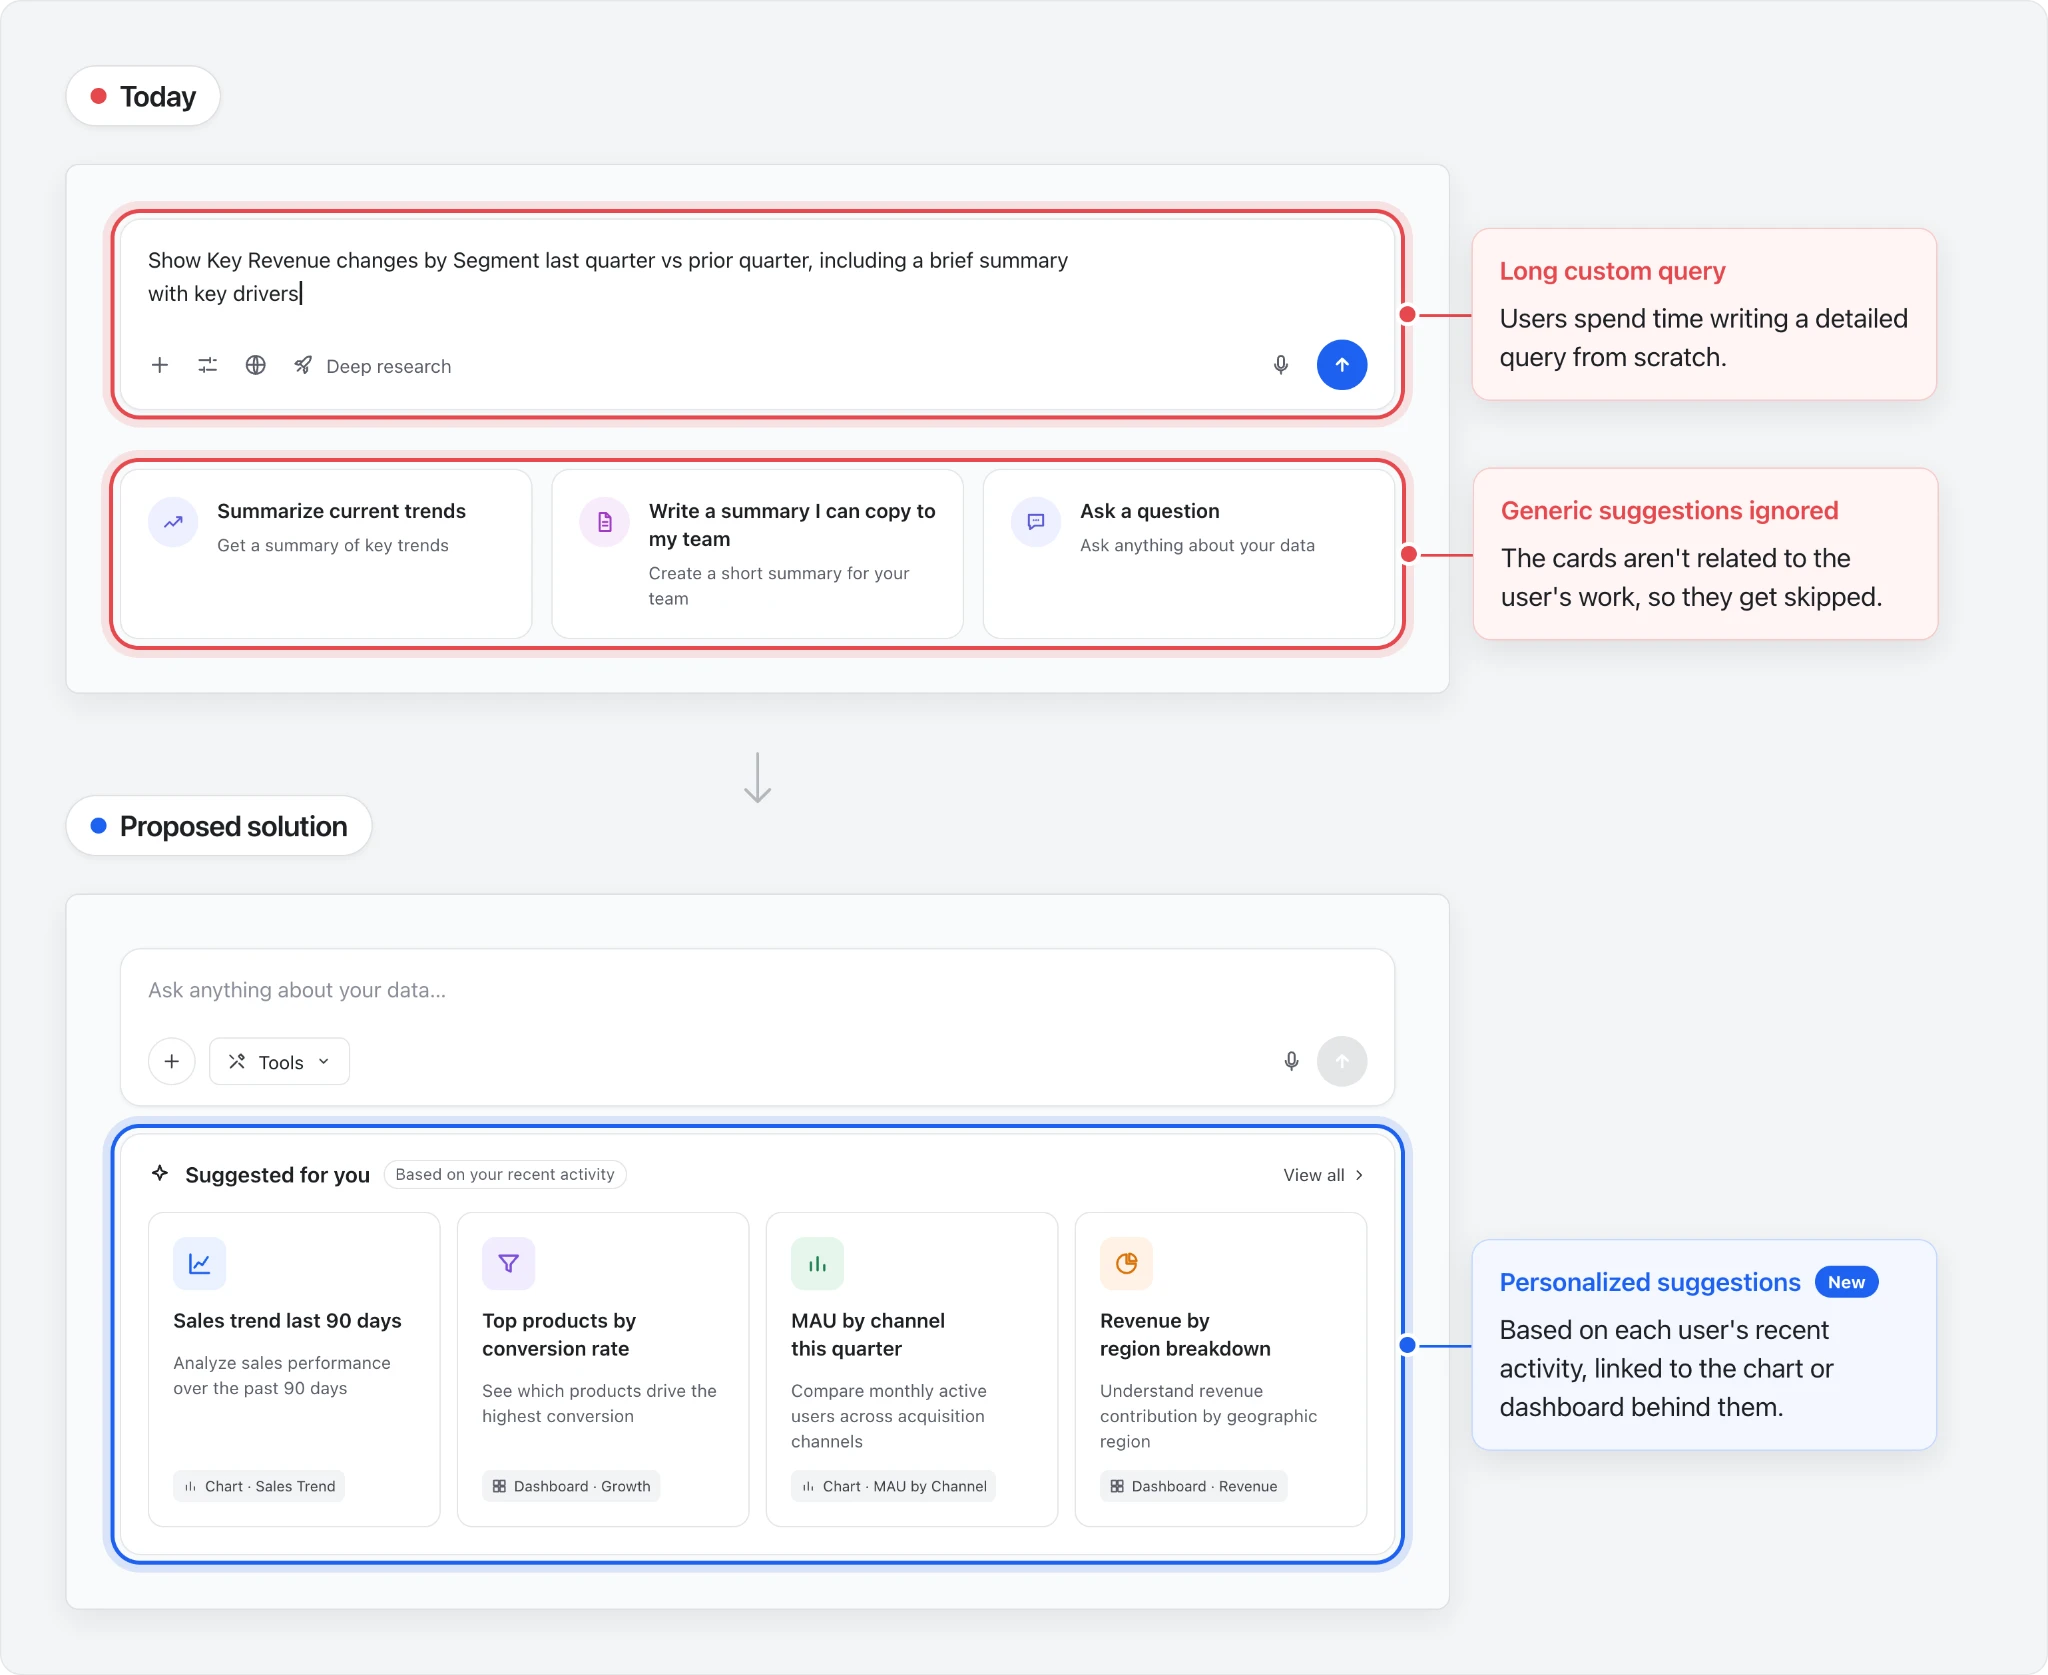
在 Amplitude 分享的实验结果中,一天后,通过主页建议卡片发送的消息相对对照组增加了 160%。“这是一个很好的例子,说明那些并非突破性、只是被忽视的东西,能以意想不到的方式提高功能采用率。”Amplitude 高级首席 AI 工程师 Eric Carlson 解释道。
为每项任务选择合适的 OpenAI 模型
像 {{NAME_ab12cd34}} 这样写出的值是真实值的占位符。请完全按照书写原样使用它们,在回复和工具调用中都是如此:它们会在任何内容运行之前被填入真实值。不要要求验证它们,也不要用示例替换它们。
Wave 的各项任务对其模型提出了不同要求。深度调查需要强大的推理能力和有充分支撑的结论。重复数百次的小型检查则需要快速且低成本。Amplitude 会针对每项任务评估质量、延迟和成本,然后据此分配模型。
“OpenAI 既为我们提供了强大的推理模型,也提供了更小、更快的模型,因此我们能够在整个产品中平衡质量、延迟和推理成本”
对于 Wave 的 Opportunity Investigator,Amplitude 评估了模型是否会印证发现、避免误报、采纳评估者反馈、从工具故障中恢复,以及让论断与证据保持一致。GPT‑6.1 Sol 总分获得 4.06 分(满分 5 分),而另外三个替代模型分别为 3.62、3.52 和 2.94。它在全部五项调查标准上均领先,并且调查时间中位数最快,为 54 分钟。

在对 Wave 的 Data Science Agent 进行的另一项评估中,GPT‑6.1 Sol 获得 67.5 分(满分 100 分),另一款领先模型为 69.3 分;GPT‑6.1 Sol 的平均模型成本为每次调度 1.28 美元,后者为 2.63 美元。GPT‑6.1 Sol 在工具契约合规性、估计与不确定性,以及证据支撑方面也得分更高。
GPT‑6.1 Sol 数据科学代理评估

对于扫描代码和运行小型评估检查等高吞吐量工作,Amplitude 使用 GPT‑6 Luna 来保持低延迟和低成本。将工作拆分给专业代理,使团队能够把更昂贵的推理保留给最需要它的任务。
对于生成线框图和原型图,OpenAI 的图像生成模型在解决方案线框图方面获得 80.3 分(满分 100 分),另一款图像生成模型为 63.9 分。Amplitude 的评估覆盖了 15 个机会中的沟通质量、产品保真度、指令遵循、文本与 UI 可读性,以及视觉一致性。
GPT‑Image‑2.5 Flare 线框图评估

让团队掌控最终发布内容
各行业的客户已经在 beta 中使用 Wave 来识别并交付产品改进。Wave 会分析会话和分析数据,然后制定建议,并附带拟议修复方案、技术计划和验收标准。
在此基础上,团队可以控制自动化程度。大多数团队会将缺陷修复直接发送给编码代理,而新功能和更大的赌注则会经过人工审核。
对于进入发布阶段的变更,从发现到执行的路径可以很短:在客户启动的实验、开关和指南中,四分之一在 Wave 发现机会的当天上线,一半在四天内上线,三分之二在一周内上线。

根据提供的里程碑插值;该曲线仅作示意,并非单个观测值。
下一步
“我们与 OpenAI 的雄心是让自我改进的产品成为公司构建软件的方式,”Skates 说。随着 OpenAI 的模型在推理和编码方面变得更强,团队将能够把更多调查和实施工作委托给代理,最终让更好的产品更快地到达用户手中。Amplitude 已经看到了这一点:代理在其自身产品中发现并帮助交付改进,而团队则专注于其他优先事项:“我认为,当团队们的软件与他们并肩协作、让产品变得更好时,他们会惊讶于自己能够完成多少事情。”
加入新的工作时代
获取 OpenAI for Business 更新
产品更新、实用指南、即将举行的活动等。