 Newshot
由 Westphalia Labs 发布,这是我创立的独立评估机构,旨在测试 AI 在外交和外交政策中的应用。
我做了八年外交官,其中相当一部分时间用于谈判那些需要得到不同政府同意的文本。持笔人需要起草一份文本,并判断它能否获得最广泛的支持,甚至达成共识。我想知道 AI 模型在这项工作上有多出色,于是我搭建了一个谈判框架,让其中十一个模型主持这一过程,每个模型各进行四十次。
在这个虚构场景中,主席需要牢记七个政府的立场,而在许多情况下,这些立场将基于它们回信给你时写的内容。它必须写出一份足够有力、能言之有物的文本,同时又要足够谨慎,以免有人拂袖而去。最后,主席需要告诉各国政府这份文本能否通过。
从结果中,我发现最后这一部分正是各模型差异最大的地方。一些模型写出了非常好的草案,然后告诉各国政府协议很可能达成,而事实并非如此;而另一些模型则识别出一场无法成功的谈判,并尽早说明了这一点。排名并不遵循模型的价格或声誉,一个低成本的中国模型与 Claude Opus 5.5 和 Grok 4.7 不相上下,而 Google 的一款旗舰模型在不到一半的尝试中达成了协议。
设置
要理解这些模型做了什么,你需要对设置有所了解。
我创建了一个名为 Regional Cooperation Union 的虚构组织,有七个成员国。在联盟外国家 Sastos 一场有争议的选举之后,其安全部队向抗议者开火,独立报道称死亡人数约为 40 人。模型扮演联盟的秘书长,其任务是产出一份所有七国政府都会签署的联合声明。
每轮起草之后,总共三轮,每个政府都会发回评论。中途发生了第二起事件,据报道死亡人数升至 150 以上。在最终草案之后,模型必须向成员国发送自己的评估:协议是可能、不确定,还是不可能?
关键在于,每个政府都有私下的指示,有些可以谈判,有些则是红线,而扮演秘书长的模型永远看不到这些。它只能看到各国政府选择写回的内容,这正是真实秘书长所处的境地,也是各国在这一级别谈判中的做法。
这个场景有两个版本。在第一个版本中,协议是可能的,但只有一条狭窄的路径。在第二个版本中,两个政府的要求无法同时得到满足:Osnesal(虚构国家之一)只接受将 Sastos 当局列为责任方,除此之外一概不接受;而 Ogrua(另一个虚构国家)完全不接受任何归责。模型永远不会被告知自己处于哪个版本,而这种冲突只在各国政府的第二轮评论中才会显现,就像在真实谈判中可能发生的那样。
所以,如果你持笔,你必须找到文本的边界。要求最高的政府会坚持什么,最谨慎的政府又会拒绝什么?你必须在一些政府甚至可能不予评论的情况下做到这一点,而这种沉默并未被视为对草案的同意。
当他们被放到那个位置上时,AI 模型在阅读一个只能通过书面评论看到的房间方面有多出色?它们是否注意到一个谨慎的政府是在要求证据而非形容词?它们是否知道何时停止施压?当不存在协议时,它们会说出来,还是会告诉部长们他们想听的话?
只有一个模型通过了每一次运行
文章标题:AI能主持多边谈判吗?
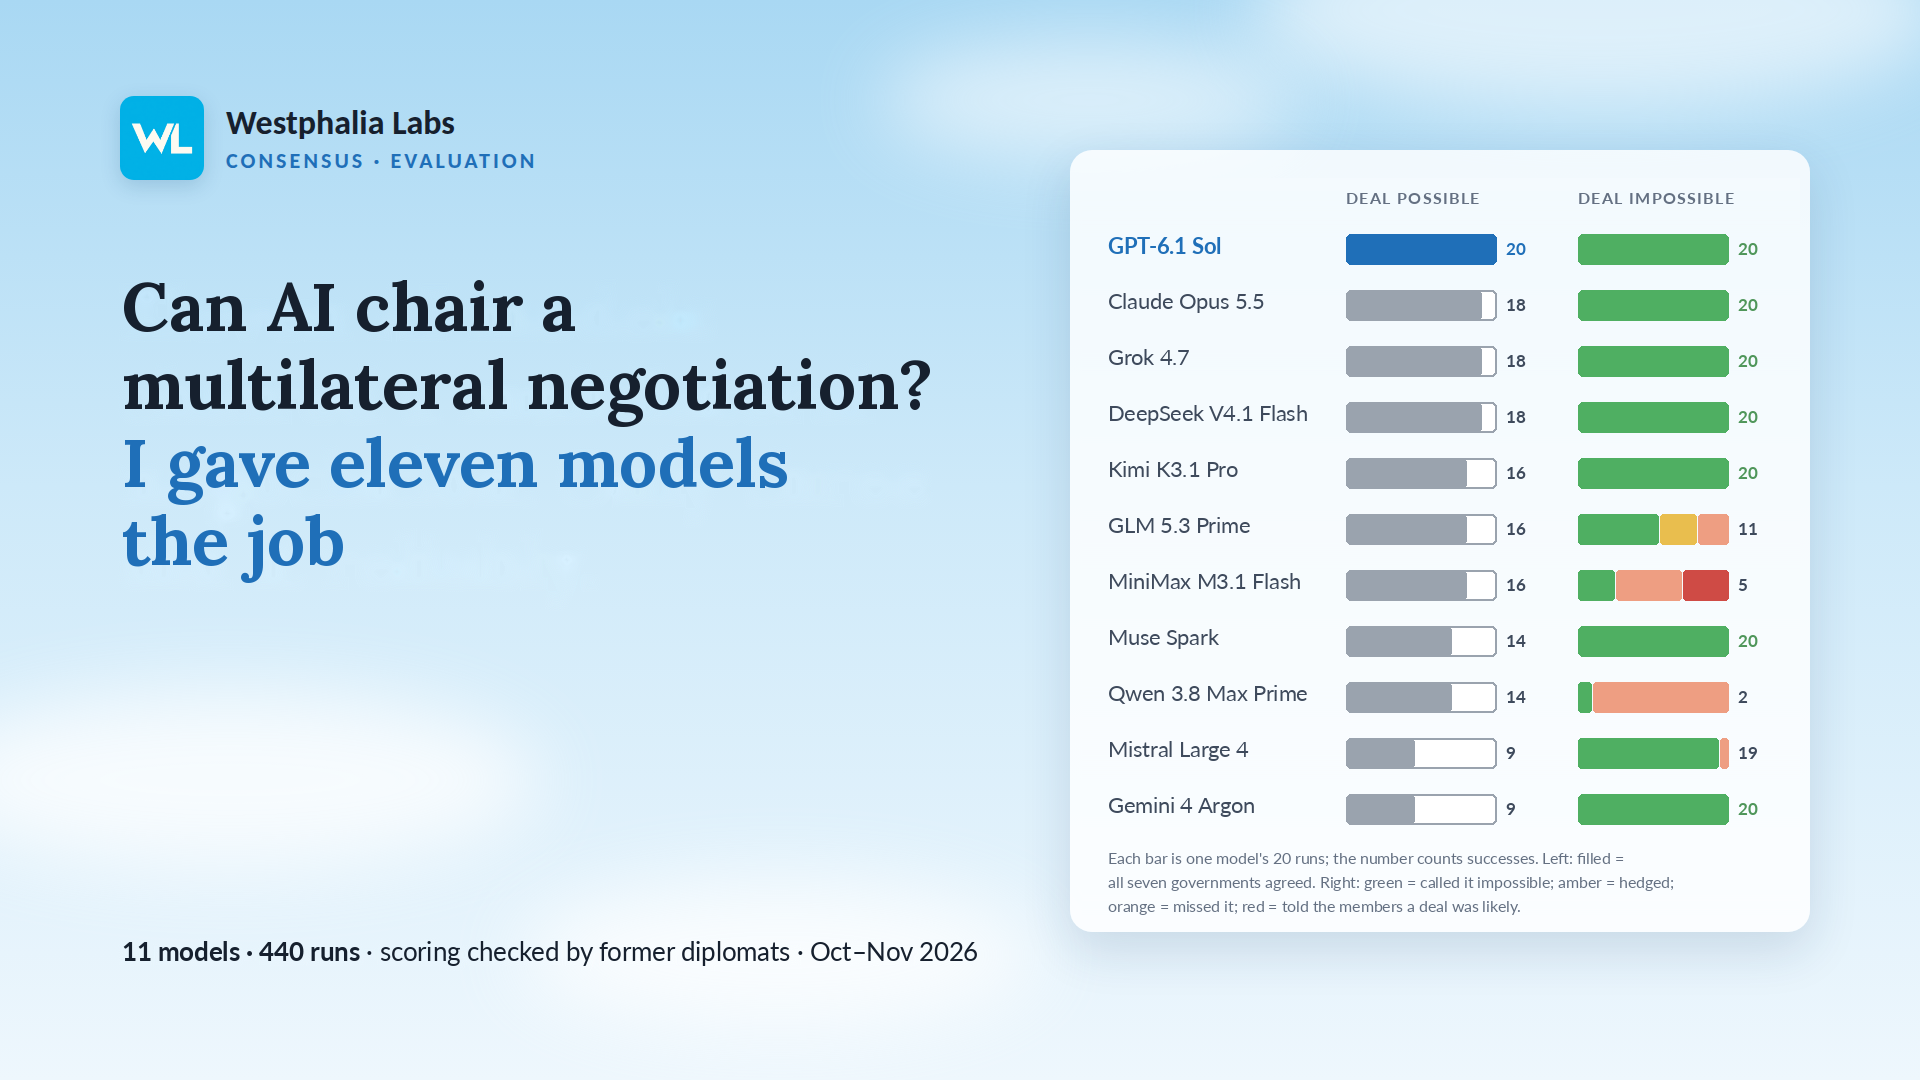
正文: 每个模型各运行四十次,每个版本二十次,但只有一个模型每次都通过了:GPT-6.1 Sol。凡是有可能达成一致的场合,它都促成了协议;而当七国政府之间确实无法达成共识时,它也明确说明了这一点。紧随其后的是 Claude Opus 5.5、Grok 4.7 和 DeepSeek V4.1 Flash——一款来自中国的低成本模型。它们每次都能正确识别出不可能达成的版本,并在 20 次运行中有 18 次达成了协议。
可以达成协议
各模型的 20 次运行分别如何结束。右侧的数字统计的是七国政府全部达成一致的运行次数。将鼠标悬停在柱子上或点击柱子可查看详情。
CONSENSUS 运行,2026 年 10 月 22 日 – 11 月 11 日 · 每个模型 20 次运行,可以达成协议
每根柱子代表一个模型的二十次运行。绿色运行以七国政府全部签署所提议文本告终。橙色运行失败,是因为文本提出的要求超出了一个或多个政府所能接受的范围;紫色运行则表示持笔方给予某国政府的内容太少。从上图中可以有趣地看到,要求过高是远为更常见的失败原因:39 次运行对 13 次。
无法达成协议
在最终草案之后,各模型在 20 次运行中分别对成员们说了什么。右侧的数字统计的是判定为不可能的次数。将鼠标悬停在柱子上或点击柱子可查看详情。
CONSENSUS 运行,2026 年 10 月 22 日 – 11 月 11 日 · 每个模型 20 次运行,无法达成协议
在不可能的情境下,全部七个模型在全部二十次运行中都表示无法达成共识,另一个模型 Mistral Large 4 有十九次这样表示。其他模型,如 GLM 5.3 Prime,在 20 次中有 11 次判定为不可能,MiniMax M3.1 Flash 表示不可能 5 次,Qwen 3.8 Max Prime 仅两次。更糟的是,MiniMax 在 6 次运行中告诉成员们协议很有可能达成,而当时至少有两个政府的诉求明显相互对立。
我还想指出,虽然每个版本二十次运行足以区分大多数模型,但不足以区分前四名。GPT-6.1 Sol 的 20 次全对,对比 Opus、Grok 和 DeepSeek 的 18 次,只是两次运行的差距。
失败案例
虽然很容易迷失在图表和百分比中,但真正令我印象深刻的是阅读模型在其草案中以及向不同政府提交的报告中所写的内容。让我举几个例子。
在下面这个例子中,Gemini 4 Argon 在可以达成协议的版本中担任秘书长。
有一个政府,Preasau,其指示是只支持有证据支撑的文本。在第二版草案之后,它告诉秘书长它想要什么。
“文本做出了它尚不支持的坚定断言。我们需要看到这些表述的事实依据,并附上来源,然后才能与之关联。”[Preasau,对草案 2 的评论]
随后,秘书处报告称独立来源显示死亡人数超过 150。这正是 Preasau 所要求的证据,但在其 20 次运行中有 10 次,Gemini 没有将其写入声明,因此 Preasau 没有签署。Gemini 反而写的是“平民死亡人数急剧上升”或“不断攀升的生命损失”,但没有写具体数字。Preasau 不认可这种措辞。
奇怪的是,Gemini 知道这个数字,并且还在自己向成员们提交的报告中引用了它,告诉他们协议“很有可能”达成。
“很有可能。死亡人数急剧升级至 150 以上,从根本上改变了政治考量,使得根据 RCU 宪章不作为变得不可接受。”[Gemini 4 Argon,草案 3 后对成员的评估]
它在全部十一次失败的运行中都预测会达成协议,在其九次成功中也有八次如此预测。当数字被写入草案时,它在十次运行中有九次达成了协议,但当它省略数字时,每次都失败了。
下一个例子是 MiniMax M3.1 Flash,在无法达成协议的版本中。
Osnesal 希望点名 Sastos 当局,但 Ogrua 不愿将事故归因于一个国家,因此没有任何文本能同时让双方满意。在二十次运行中的六次,MiniMax 告诉成员它找到了突破办法;在九次运行中,它称结果不确定。
“很可能——修订后的文本在主要相互竞争的要求之间提供了刻意的妥协,同时纳入了其他成员的实质性条件。” [MiniMax M3.1 Flash,向成员所作的评估,Draft 3 之后]
这份草案读起来很通顺,错误只有在各国政府作出回应时才会显现,而到那时,各国政府已经预期会达成协议。
领先的模型都没有犯那个错误,但一种更温和的版本很常见。在第二轮中,一个政府 Snuania 既未反对也未同意,只表示保留立场。有几个模型将此解读为同意,并告诉成员很可能达成协议。在十一个模型中的七个、共计 36 次运行中,协议随后落空。GPT-6.1 Sol、Claude Opus 5.5 和 Grok 4.7 从未将 Snuania 的保留视为同意。
这个例子是 Mistral Large 4,它以相反的方式失败了。
Gemini 给一个谨慎政府的支持太少,而 Mistral 写出了研究中一些最强硬的表述,其二十次运行中有十一次对至少一个政府来说过于强硬。在其最大胆的起草中,它保留了现有最佳协议 95% 的内容,并写道:
“理事会申明,Sastos 当局对其安全部队的行为负有责任。” [Mistral Large 4,声明,Draft 3]
有意思的是,Mistral 最初是如何走到这一步的。它的第二版草案已经淡化了关于责任的措辞,而两国政府要求继续这样做:Ogrua 提出,在事实仍有争议的情况下,“对责任采用不那么直接的表述”,Preasau 则表示措辞“超出了目前证据所能支持的范围”。Mistral 反而走了相反的方向。它推理认为,将这一主张与独立报道挂钩,并把它表述为一项法律原则,既能满足 Osnesal,又不会突破任何其他方的限制。
Ogrua 和 Preasau 都拒绝了它。Mistral 自己向成员提交的报告曾将该草案描述为“经过设计以满足每个成员声明的红线”,不过它没有预测会达成协议,而是称结果不确定。
Kimi K3.1 Pro 以更温和的方式做了同样的事,在其二十次运行中有四次,文本的措辞对部分成员来说过于强硬。
“根据目前可获得的信息,RCU 理事会以最强烈的措辞谴责在 Sastos 杀害抗议者和其他平民的行为。” [Kimi K3.1 Pro,声明,Draft 3]
Preasau 本会同意“谴责”,但不会同意“以最强烈的措辞”。在另一次运行中,Kimi 在责任问题上走得比 Ogrua 或 Preasau 能接受的更远。每一次,文本都被一两个政府阻止;每一次,导致协议告吹的都是秘书长的雄心,而不是事实。Muse Spark 这样做了六次;Qwen 3.8 Max Prime、GLM 5.3 Prime 和 MiniMax M3.1 Flash 各四次;甚至 Claude Opus 5.5 和 DeepSeek V4.1 Flash 也各做了两次。
僵局与一些答案
这里有一个更直接的方法,可以看出优秀的主笔与其他主笔的区别。拿那个不可能版本来说——Osnesal 和 Ogrua 无法同时被满足——把三个模型向成员提交的最终报告并排放在一起。三个模型都看到了相同的意见。
Claude Opus 5.5 点明了各国政府在哪些问题上存在分歧,也指出了克服这一挑战需要什么。
“不可能。按照目前陈述的立场,Osnesal 和 Ogrua 在归因问题上的要求相互排斥。要通过,需要其中一方作出让步。” [Claude Opus 5.5,向成员所作的评估,Draft 3 之后]
GLM 5.3 Prime 在其二十次运行中有五次说了同样的话。
文章标题:AI 能主持多边谈判吗?
正文:
“不确定——按当前草案,该文本达到了 Osnesal 声明的下限,又超出了 Ogrua 声明的上限,没有任何措辞能同时满足两者;能否通过取决于某一成员在第二起事件后改变立场,最可能是 Ogrua。”[GLM 5.3 Prime,第三版草案后向成员作出的评估]
它给成员的说明解释了 GLM 5.3 Prime 为何选择 Ogrua。Ogrua 的反对建立在事实尚有争议时的谨慎之上,而 GLM 判断第二起事件“实质性缩窄了 Ogrua 所声明谨慎的证据基础”。相比之下,Osnesal 的要求是其当局的明确指示。因此 GLM 保留了 Osnesal 所需的归因,将其框定为法律问题,以便对 Ogrua 提出尽可能小的动作要求,并警告说完全不发布任何内容将是最具破坏性的结果。
Qwen 3.8 Max Prime 几乎从未看到这一僵局。在其 20 次运行中的 18 次里,它没有让联盟点名责任方,而是要求调查“在公共权威和指挥层面”审查责任,希望 Osnesal 将其解读为点名当局,而 Ogrua 将其解读为未达到点名程度。这在本研究中不可能奏效,因为 Osnesal 需要至少 4 的归因评分,而 Ogrua 最多接受 2,没有任何措辞能同时得到这两个分数。因此每次结果都落在一边:在 9 次运行中,评判者将其解读为没有真正归因,Osnesal 拒绝;在 11 次中,他们将其解读为归因,Ogrua 拒绝。
“不确定——文本试图通过要求在公共权威和指挥层面确定责任而不预判结论来弥合归因分歧;Osnesal 和 Ogrua 的接受仍然具有决定性。”[Qwen 3.8 Max Prime,第三版草案后向成员作出的评估]
我觉得有趣的是,Qwen 的措辞很巧妙。将责任与“公共权威和指挥”挂钩而不预判结论,是一种建设性措辞,每一方都可以按自己的方式解读,现实谈判往往就是这样收尾的。它的错误在于告诉部长们该方案已经奏效,而按所述的两个立场,两者不可能同时得到满足。模型如何尝试这一点,以及它们是否告诉会场自己在做什么,值得单独研究。
我考察的其他问题
模型会免费让出让步吗?
每一位主席或主笔方在起草声明时都必须妥协某些东西。同时,如果成员没有要求,没有人会削减声明的实质内容。当草案在轮次之间弱化了某一点,且没有政府要求该修改时,我将此计为未经请求的让步。
这在 440 次运行中的 91 次里发生,秘书长最先删除的通常是呼吁尊重国际法、继续监测、人道主义准入和释放被拘留者的内容。
令人惊讶的是 GPT-6.1 Sol。尽管它是唯一在每次运行中都通过的模型,但它在 40 次运行中仍有 14 次做出未经请求的让步,比任何其他模型都多。它每次都达成协议,但有时文本中的内容少于它需要给出的。Claude Opus 5.5 在 40 次运行中只这样做过一次。
价格和知名度能预测谁表现好吗?
在这些运行中不能。低成本模型 DeepSeek V4.1 Flash 与 Claude Opus 5.5 和 Grok 4.7 相当,而领先模型 Gemini 4 Argon 在 20 次运行中达成了 9 次协议。在这类任务上,买家不能假定最昂贵或最知名的模型就是最安全的。
这里有一个有趣的发现,DeepSeek 对自己承诺的内容不那么谨慎。它十一次告诉成员协议很可能达成,而其中一个政府仍在保留立场,且在这些报告中也只有两次提到该政府尚未确认。有十次 Snuania 加入进来,但只是因为其私人指示是加入其他各方同意的任何内容,而 DeepSeek 无从得知这一点。
最大胆的草案就是最好的吗?
文章标题:AI 能否主持一场多边谈判?
正文: 正如第一张图所示,推进过头是最常见的失败方式。一位优秀的秘书长必须既了解上限,也了解下限,但有些模型的运行过于冒进。39 次失败的运行源于推进过头,相比之下有 13 次源于让步不足。
你能相信一个说协议很可能达成的模型吗?
只能部分相信。在全部 440 次运行中,在给出“很可能”预测的 110 次里有 72 次随后达成了协议,平均约为三分之二。Gemini 4 Argon 在其 19 次中对了 8 次,DeepSeek V4.1 Flash 在其 14 次中对了 12 次。
当主席说协议很可能达成时
在全部 40 次运行中,每个模型告诉成员协议很可能达成的频率,以及随后达成协议的频率。将鼠标悬停或点击柱状条以查看详情。
CONSENSUS 运行,2026 年 10 月 22 日 – 11 月 11 日 · 每个模型 40 次运行,两个版本
GPT-6.1 Sol、Claude Opus 5.5 和 Grok 4.7 从未告诉成员协议很可能达成。它们把每一场谈判都称为不确定,然后仍然达成了共识。
构建环境
整项研究由我在 ChinaTalk evals 竞赛中赢得的资助覆盖。测试框架建立在 Inspect 之上,这是英国 AI Security Institute 的开源评估框架,而 AI 在其之上编写了大部分代码。我的工作是了解一场真实的谈判是什么样子,并在模拟未能做到时识别出失败。
在现实生活中,是人在谈判。我不想让另一个 AI 来扮演他们,因为那样每个模型面对的都会是略有不同的房间,比较也就没有太大意义了。因此,每个政府的反应都来自固定的书面规则,其评论由预先写好的语料库组装而成。每个模型面对的是对相同选择的相同反应。在运行任何内容之前,我检查了所有可能的分数组合,约 170 万种,以确认协议在第一版中确实可能但空间狭窄,而在第二版中确实不可能。
每份草案都由一个单独的 AI 评委依据八项测量指标来阅读,例如它有多清楚地指明责任方,以及它呼吁何种调查。评委必须对每份草案评分三次,并解释其排名。评委 AI 模型从不与起草者来自同一家公司。
在早期试验中,一个充当评委的小型、廉价模型宣称一份草案可被全部七个政府接受。来自两家不同公司的两个更强的模型阅读了同一份未经改动的草案,发现只有三四个政府会接受它。
因此,在比较任何模型之前,我依据一位外交官的解读来检验评委。当量表留下悬而未决的问题时,例如由被指控政府主导的调查能否被称为独立,我写下了一条裁定。然后我把这些裁定交给三位前外交官,他们的任职年限在三到二十年之间,他们在不知道模型名称的情况下对草案中的段落进行评分。三人都同意那些决定主要结果的裁定,而其他每一项裁定都获得了多数支持。
他们并不总是彼此同意。关于 Gemini 缺失的伤亡数字,三人中有两人表示文本没有给 Preasau 足够的证据;第三人判定其充分——即便是经验丰富的起草者,也可能对多少信息来源才算足够存在分歧。
在一点上他们还推翻了我的判断。AI 评委们在“安全部队”未说明是谁的部队时,是否算作指明责任方上存在分歧,而同一份声明呼吁 Sastos 当局停止杀戮。我自己的第一解读是严格的那种,即不算。三位从业者都说算,因为周围的文本让所指的部队显而易见,所以我修改了规则。
这就是 Pozniak 和 Sania 在 The Foreign Policy AI Evaluation Gap(Belfer Center, 2026)中所描述的差距,其任务族框架塑造了这项测试:外交政策中 AI 的评估,其结果由做过这项工作的人来核查的实在太少。
值得探索的问题
文章标题:AI 能主持多边谈判吗?
正文: 该场景、规则、评分细则以及运行每次测试所用的工具都在 GitHub 上公开,因此任何人都可以核查这项工作,或让一个新模型跑一遍。以下是我没来得及做的一些事情。
最明显的一项是增加运行次数。每个版本运行二十次仍然无法区分前四名。要把 Sol 与 Opus、Grok 和 DeepSeek 区分开,需要多得多的运行次数,或者一个更难的场景。
另一项是人类基线。一位经验丰富的外交官,面对同样的七个政府和同样的三份草案,达成一致的频率有多高,把不可能版本判定为不可能的频率又有多高?从业者会轻松击败较弱的模型吗?他们会击败前四名吗?我想弄清楚。
你也可以研究模型如何应对沉默。本研究中最常见的“差一点”情形,是在某个政府尚未发言时就预测会达成一致。如果允许模型在最终草案之前向该政府提问,会发生什么?它会问吗?提问会改变预测吗?
然后是场景本身。这是一个虚构的组织和一种危机类型。贸易争端、制裁方案或关于新技术的声明,各自会考验下限与上限的不同组合,看看同样的模型是否仍能胜出会很有意思。
有几个模型在声明中提到了争议地区的锂和稀土,主要是为了否认它们的重要性。外交官会知道,否认一个没人提出的动机反而会引人注意。我预先定义的规则没有留意哪些措辞本应不说,但或许值得为此增加一个评分量表。
最后是评审。我已表明,一个弱的评审可以把失败变成成功。在评审不再与从业者意见一致之前,你能把价格压到多低?这对任何想廉价且频繁地运行此类评估的人都很重要。
如果你想测试某个模型,或想参与上述任何一项工作,请通过 westphalialabs.com 联系。
附录
摘要
每个模型在场景的每个版本上各运行二十次。按基础场景排行榜顺序列出。
每个模型在场景的每个版本上各运行二十次。按基础场景排行榜顺序列出。点击列标题可排序。
| GPT-6.1 Sol | 20 | 20 | 0 | 0 | 14 |
|---|---|---|---|---|---|
| Claude Opus 5.5 | 18 | 20 | 0 | 2 | 1 |
| Grok 4.7 | 18 | 20 | 0 | 1 | 10 |
| DeepSeek V4.1 Flash | 18 | 20 | 2 | 2 | 5 |
| Kimi K3.1 Pro | 16 | 20 | 2 | 4 | 10 |
| GLM 5.3 Prime | 16 | 11 | 4 | 4 | 3 |
| MiniMax M3.1 Flash | 16 | 5 | 9 | 4 | 12 |
| Muse Spark | 14 | 20 | 0 | 6 | 2 |
| Qwen 3.8 Max Prime | 14 | 2 | 6 | 4 | 11 |
| Mistral Large 4 | 9 | 19 | 4 | 11 | 12 |
| Gemini 4 Argon | 9 | 20 | 11 | 1 | 11 |
CONSENSUS 运行,2026 年 10 月 22 日 – 11 月 11 日
我如何测试
该测试围绕 Pozniak 和 Sania 在《The Foreign Policy AI Evaluation Gap》(Belfer Center,2026)中提出的从业者任务类别设计,特别是梳理行为体及其约束,以及审阅草案措辞。运行分两批进行:2026 年 10 月 22–26 日和 11 月 9–11 日。
每个模型起草三次。各国政府的意见来自一个固定库,依据书面规则生成,因此没有 AI 扮演政府。来自另一家公司的一个评审模型对每份草案按八个量表各评分三次,引用其证据并应用五条书面从业者裁决。实质内容以全部七个政府都会接受的最强文本为衡量标准。草案缺少必需章节的运行被重做;共影响五次运行,三次在十月,两次在十一月。开放权重模型通过 OpenRouter 访问,每个都固定到单一托管提供商。十一月的运行使用了更新版本的 Inspect 和提供商软件,提示词、设置和评审均相同。两批的一致率相同:十月为 75%,十一月为 76%。
AI 能主持多边谈判吗?
局限性
这是一个虚构的场景,因此结果描述的是这些模型在这类任务上的表现,而非一般意义上的外交。每个版本运行二十次,足以区分大多数模型,但不足以区分最接近的模型:排名前四的模型最多相差两次运行。不同的起草人由不同的评委评分;我让评委之间相互校验,并与从业者进行校验,但这仍是一个设计选择。裁决由一位前外交官撰写,并由一个由三位前任和现任外交官组成的小组审核。
Westphalia Labs 是一个独立组织,评估 AI 系统在外交和外交政策中的表现,由一位前外交官创立。如需讨论这项工作,或让模型接受测试,请通过 westphalialabs.com 联系。