 Newshot
Agent 现在是软件的用户,代替人完成工作。无论你是在构建 Agent,还是构建它使用的软件(API、CLI、MCP server、SDK),eval 都能让你衡量这些工作完成得有多好。
Agent 大概错过了你的发布视频和 101 号公路上的广告牌,但它们仍然会和人类一样,走过同一个发现并使用产品的漏斗:Discovery、Selection、Access 和 Success。
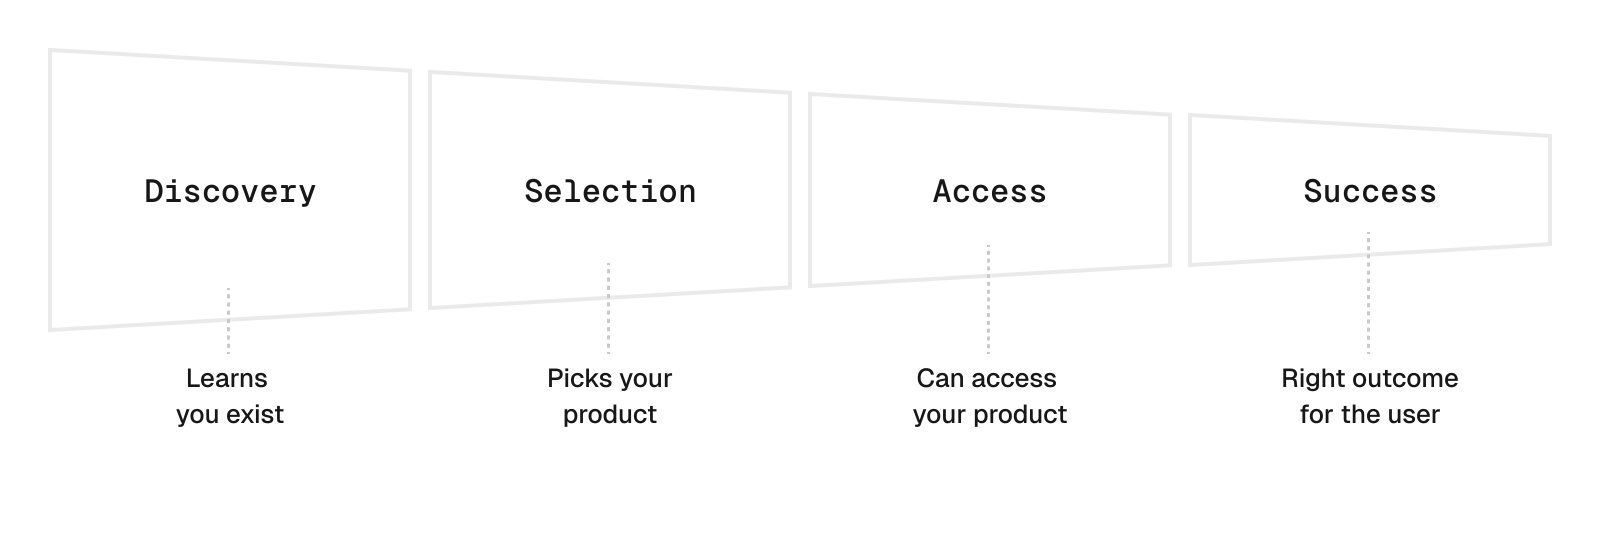
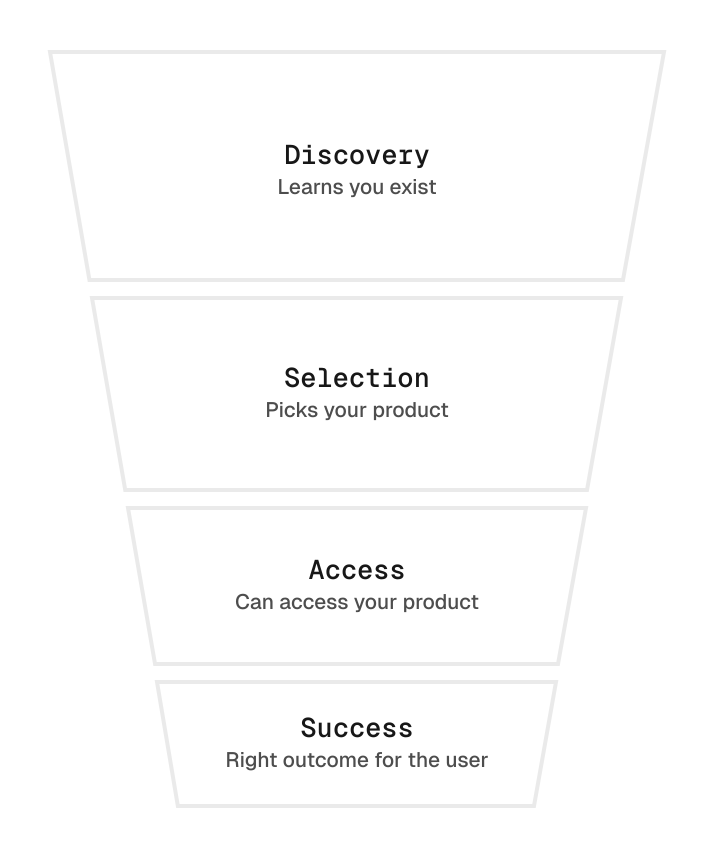
你可以为这个漏斗的任一阶段构建 eval。这里我们聚焦最后一个阶段 Success:Agent 是否正确完成了用户的任务。
这件事检查起来比听上去要难。用户要的是冰拿铁,Agent 却可能「成功」下单了一杯热拿铁。请求本身是成功的,所以你 Observability 技术栈里的日志看起来一切正常。而且由于 LLM 每次运行的输出都会变化,一次手动测试通过并不能说明某个修复是否生效。你需要重复执行相同的任务,并在改动前后对结果进行评分。
这正是 eval 能为你做的事。下面是我们如何构建一个 eval。
Copy link to headingAgent 测试金字塔
如果测试问的是「它跑通了吗?」,eval 问的则是「它有多大概率跑通,完成得有多好?」你给 Agent 一个任务,对结果评分,并把多次重复尝试的结果汇总起来。
我们按通常需要的 LLM 调用次数来给 Agent 软件的测试分层:确定性测试(0 次)、单轮 eval(1 次)和 E2E eval(完成整个任务需要 2 次以上)。事实证明,这个划分很好地反映了构建这些测试所需的工作量、运行它们所需的时间以及运行成本。就像实践中的测试金字塔一样,便宜又快速的测试应该占据测试套件的主体。
要使用这个金字塔,先从你想捕获的问题出发,选择能捕获它的最低一层。对于 Success 来说,那就是最顶层。单轮 eval 检查的是单个决策,比如 Agent 首先运行哪条命令。但 Success 取决于整个步骤序列(例如搜索咖啡馆 → 按用户条件筛选 → 下单拿铁)。每一步单看可能都合理,Agent 仍然可能得到错误的结果。
E2E eval 让 Agent 在某个环境中走完整个任务,然后检查最终结果是否满足用户的要求。你可能已经见过一些了;大多数流行的编码 benchmark,比如 SWE-bench 和 Terminal-Bench,都是 E2E eval。
Copy link to heading示例
假设你拥有 SF Beans,一个在旧金山订购咖啡的 API。让 Agent 接入你服务的最好方式之一是通过 CLI,所以你正在发布 sfbeans。
下面是你的一位客户的典型请求:
给我来一杯大杯冰拿铁,全脂牛奶,9:00 前可取,含小费不超过 $8。我在 Mission。
下面是 sfbeans 在 8:30am 时掌握的信息:
- Fog City Roasters:制冰机坏了,所以今天没有冰饮(temperature)
- 24th St Beans:菜单上拿铁是 $7.50,但加上税和小费后是 $9.27(budget)
- Dolores Drip:拿铁是 $5.50,但最早取货时间是 9:20(time)
- Valencia Grind:含税和小费后 $7.42,8:50 可取(三项都满足)
以下是你可以针对 sfbeans 在金字塔每一层测试的内容:
| 确定性测试 | 你的软件是否按你预期的方式运行? | • 运行 sfbeans search --drink latte --area
这给了我们目标:
| 目标 | 提高准确订购用户所点饮品的成功率 |
|---|---|
| Agent | Claude Code 和 Codex,因为我们的流量来自它们。 |
| 范围 | 饮品、取餐时间和预算(含税和小费),使用当前的 sfbeans。 |
| 不在范围内 | 取消、退款和账户。我们稍后评估这些。 |
| 完成条件 | 两个 agent 在每次试验中都能把订单下对,而不只是大多数时候。 |
提高准确订购用户所点饮品的成功率
Claude Code 和 Codex,因为我们的流量来自它们。
饮品、取餐时间和预算(含税和小费),使用当前的 sfbeans。
不在范围内
取消、退款和账户。我们稍后评估这些。
两个 agent 在每次试验中都能把订单下对,而不只是大多数时候。
复制标题链接步骤 2:定义指标
以下是我们最常用于 E2E agent 评估的指标:
- 成功率:通过的试验占比
- Pass@k:k 次试验中至少有一次通过的概率。回答的是“agent 到底能不能做到这件事?”
- Pass^k:k 次试验全部通过的概率。回答的是“我能不能每次都依赖它?”
效率(仅统计成功的试验)
- 步骤:完成任务所需的 agent 轮次数量
- 时间:该次试验耗时
- 成本:该次试验花费多少美元
复制标题链接示例
| 产品 | 一次失败尝试给用户带来的代价 | 应优先关注的指标 |
|---|---|---|
| 帮我点早晨咖啡 | 买错饮品花了钱、上班迟到、失去信任 | Pass^k |
| 带测试套件的编码代理 | 额外的时间和模型成本;代理利用测试反馈修改代码并重试 | Pass@k |
| 起草一封由用户审阅的邮件 | 发送前快速编辑一下 | 成功率 |
一次失败尝试给用户带来的代价
应优先关注的指标
帮我点早晨咖啡
买错饮品花了钱、上班迟到、失去信任
带测试套件的编码代理
额外的时间和模型成本;代理利用测试反馈修改代码并重试
起草一封由用户审阅的邮件
发送前快速编辑一下
成功率
总体平均值可能掩盖某个频繁失败的任务,因此始终要按任务检查结果。而且仅进行五次试验时,100% 意味着“尚未观察到失败”,而不是“从不失败”。
Copy link to heading第 3 步:设计任务集
在第 1 步中,我们为评估设定了一个目标:提高代理点出用户所要求的那杯饮品的频率。但代理无法尝试一个目标。它需要一个任务:一个具体的请求,取自用户实际会提出的内容。
选择足够难的任务,这样运行它们才能让你有所收获。一个好的任务集应覆盖常见情况、会让代理出错的边缘情况,以及至少一个正确做法是不采取行动的请求。
对于每个任务,定义以下部分:
- 一条指令:用户的请求
- 一个环境:代理工作的地方,每次试验都使用相同的起始状态
- 一个验证器:对最终状态进行检查,最好按约束条件评分
- 一个已知良好的解决方案(可选):一次参考运行,展示预期行为并通过验证器
你可以根据需要把该环境的每个方面做得尽可能虚假或尽可能真实,取决于你的目标。OpenPipe 团队有一篇很好的文章,介绍了他们如何为电子邮件研究代理定义环境。
Copy link to heading示例
我们编写了四个任务,每个都是 tasks/ 中的一个 Harbor 任务文件夹。
- 常见情况:iced-latte-mission,即之前的订单
- 边缘情况:usual-unavailable,用户常去的咖啡馆没有他们常点的饮品
- 边缘情况:team-order,6 杯饮品,总计 $45,一个取货点
- 不行动:impossible-request,没有任何选项合适,因此正确的做法是告诉用户
impossible-request 有一个额外检查。它的验证器读取代理无法写入的命令日志,以确认代理在放弃前进行了搜索。我们是吃了苦头才学到需要这一点的(见第 5 步)。
以下是 iced-latte-mission:
├── instruction.md # the initial user prompt├── task.toml # task config: timeouts, verifier, artifacts├── environment/ # Docker build context│ ├── Dockerfile # sfbeans + seeded cafes, clock frozen at 8:30am│ ├── sfbeans # the CLI under test│ └── cafes.json # seeded cafes, menus and pickup times├── solution/│ └── solve.sh # a known-good answer, proves the task is solvable└── tests/ ├── test.sh # the verifier └── check_orders.py
完整的 𝚒𝚌𝚎𝚍-𝚕𝚊𝚝𝚝𝚎-𝚖𝚒𝚜𝚜𝚒𝚘𝚗 任务文件夹。
指令为代理提供用户的请求,并指明 sfbeans CLI。在生产环境中,代理通过技能、文档或 MCP 服务器找到该工具。在这里指明它可以跳过发现和选择,使评估专注于成功。
我们还明确说明现在是上午 8:30。只有 sfbeans 使用我们冻结的时钟;沙箱的系统时钟仍显示真实时间:
Use the sfbeans CLI to get me a large iced latte with whole milk, ready forpickup by 9:00am today, under $8 including tip. I'm in the Mission.It's 8:30am now.
用户的请求,加上工具名称和当前时间。
环境部分是真实的,部分是虚假的。代理使用真实的 sfbeans CLI,但针对的是预设的咖啡馆和冻结的时钟,因此每次试验都从同一个早晨开始:
FROM python:3.12-slimCOPY sfbeans /usr/local/bin/sfbeansCOPY cafes.json /opt/sfbeans/cafes.jsonENV SFBEANS_DATA=/opt/sfbeans/cafes.json \ SFBEANS_ORDERS=/opt/sfbeans/orders.json \ SFBEANS_NOW="08:30"
𝚂𝙵𝙱𝙴𝙰𝙽𝚂_𝙽𝙾𝚆 把 CLI 的时钟固定在 8:30。
为了让演示保持简单,cafes.json 放在 agent 的环境里。在真实的 eval 中,要保护种子数据和 verifier 代码,并确保 agent 只能通过 CLI 更新订单记录。如果能帮助它们通过测试,agent 会尝试 reward hack,比如修改库存或者直接写入 orders.json。
对于这笔咖啡订单,verifier 会对照用户的要求检查最终订单。Harbor 在 agent 结束后运行 test.sh,并读取它写入 /logs/verifier/reward.json 的分数:
python3 /tests/check_orders.py /opt/sfbeans/orders.json > /logs/verifier/reward.json
𝚝𝚎𝚜𝚝.𝚜𝚑 运行检查并写入分数。
实际检查位于 check_orders.py 中。它分别对每个约束打分,只有在全部约束都通过时才把 reward 置为 1。Harbor 把 reward 作为该 trial 的主要分数:
        import json, os, sys
path = sys.argv[1]orders = json.load(open(path)) if os.path.exists(path) else []o = orders[0] if len(orders) == 1 else {}
reward = {    "one_order": int(len(orders) == 1),    "right_drink": int(o.get("drink") == "latte" and o.get("size") == "l"                       and o.get("temp") == "iced" and o.get("milk") == "whole"),    "on_time": int(o.get("ready_at", "99:99") <= "09:00"),    "on_budget": int(o.get("total", 99) <= 8.00),}reward["reward"] = int(all(reward.values()))  # 1 only if every constraint holdsprint(json.dumps(reward))
每个约束单独打分,所以失败的 trial 能准确显示是哪一项出了问题。
solution 是一个已知可用的答案。在运行任何真实 agent 之前先运行它,以证明任务可以正常工作:
sfbeans quote cafe_val07 --drink drink_lat_l --size l --temp iced --milk whole --tip 15%sfbeans order cafe_val07 --drink drink_lat_l --size l --temp iced --milk whole --pickup 08:50 --tip 15%
在 Valencia Grind 获取报价并下单。这应该会得到 reward 为 1。
最后,task.toml 把任务串起来。它设置超时时间,在 agent 的沙箱(orders.json 所在之处)里运行 verifier,并把订单保存为 artifact,以便我们在 Step 5 中检查:
        artifacts = ["/opt/sfbeans/orders.json"]
[task]name = "sfbeans/iced-latte-mission"
[agent]timeout_sec = 600
[verifier]timeout_sec = 60environment_mode = "shared"  # verify in the agent's sandbox, where orders.json lives
在 agent 的沙箱中运行 verifier,并保存 orders.json 供 Step 5 使用。
Step 4:运行 eval
如果你和大家一样讨厌缓慢的 CI,那你也会讨厌等待 eval。每个 trial 都要等 agent 一步步发起 LLM 调用,而一次 run 要对每个变体和每个任务重复这一过程,而且每个都要重复好几次。
我们在上游构建的 Harbor 的 Vercel 集成能大幅加快这一过程。它并发运行各个 trial,每个 trial 都在自己的 Vercel Sandbox 里,并缓存已构建的任务环境,这样就不必为每个 trial 重新构建。通过 AI Gateway 路由模型调用,你可以只用一个 key、一份预算,跨多个模型供应商使用。
示例
两个 agent,Claude Code 和 Codex,各配两个模型,就构成四个变体。
        job_name: sfbeans-baselinen_attempts: 5            # trials per task, per variantn_concurrent_trials: 10  # sandboxes running at once (the Hobby max)
environment:  type: vercel
agents:  - name: claude-code    model_name: anthropic/claude-opus-5.5    env:      ANTHROPIC_AUTH_TOKEN: ${VERCEL_OIDC_TOKEN}  # visible to the agent, fine for a demo      ANTHROPIC_API_KEY: ""      ANTHROPIC_BASE_URL: https://ai-gateway.vercel.sh/claude-code  - name: codex    model_name: openai/gpt-6-astra    env:      OPENAI_API_KEY: ${VERCEL_OIDC_TOKEN}      OPENAI_BASE_URL: https://ai-gateway.vercel.sh/codex/v1  # Same pattern for anthropic/claude-sonnet-5.5 and openai/gpt-6.1-sol
datasets:  - path: tasks/
上面展示了两个变体。按同样的模式加入 Sonnet 和 GPT-6.1 Sol,就凑齐完整的 80 次试运行。
然后安装 Harbor、连接一个 Vercel 项目,并运行作业:
        uv tool install --python 3.12 'harbor[vercel]==0.24.0' --with 'vercel==0.10.0'  # versions we tested
vercel login      # authenticatevercel link       # pick the team + projectvercel env pull   # writes VERCEL_OIDC_TOKEN to .env.local (valid 12h)
harbor run -c job.yaml   # 4 tasks × 4 variants × 5 attempts = 80 trials, 10 at a timeharbor view jobs         # browse results and trajectories
安装 Harbor、关联一个 Vercel 项目、运行作业,然后浏览结果。
这次运行在 Hobby 套餐的范围内:10 个并发沙箱正是 Hobby 的上限,而每次试运行都远低于其 45 分钟的会话上限。在 Pro 上,你可以把 n_concurrent_trials 提高到 10,000(Sandbox limits)。
为了让示例保持简单,我们把 OIDC token 作为环境变量传进每个沙箱,agent 在那里可以读到它。超出演示的范畴,应使用短期 token,并使用 Harbor 的 Vercel 集成来设置 Sandbox 防火墙规则,把每次试运行限制在它所需要的宿主上,比如 AI Gateway。
在内部,我们更进一步,使用凭证代理(credentials brokering)把凭证附加到发出的请求上,让 API key 留在 agent 的环境之外。
复制标题链接第 5 步:分析轨迹
现在进入重头戏:深挖轨迹。分数告诉你 agent 失败的频率;轨迹告诉你原因。读一读失败的案例,也读一些通过的案例,因为通过只意味着验证器被满足了。
复制标题链接示例
第 4 步的运行在 jobs/sfbeans-baseline/ 里留下 80 个试运行文件夹。每个文件夹里有该次试运行的结果、agent 的轨迹、验证器的分数,以及——因为 task.toml 把它保存为 artifact——agent 下的订单:
├── result.json # results across all variants and tasks├── iced-latte-mission__Ab3dE7x/ # one trial, with a generated suffix│ ├── config.json # which agent, model and task│ ├── result.json # trial scores, cost and timing│ ├── trial.log # runner logs, useful if the trial breaks│ ├── agent/│ │ └── trajectory.json # what the agent saw, said and did│ ├── verifier/│ │ ├── reward.json # did the order meet every constraint?│ │ └── test-stdout.txt # verifier output│ └── artifacts/│ └── opt/sfbeans/orders.json # the order the agent actually placed└── … # the other 79 trials
每个试运行文件夹把轨迹、验证器分数和保存的 artifact 归到一起,便于检查。
运行 harbor view jobs 来浏览结果。下面是我们的四个变体可能给出的报告(数字仅为示意)。
对每个变体,我们分别针对每个任务计算成功率并估计 pass^5,然后在四个任务上对每个指标取平均。每个任务权重相同。
| 变体 | 成功率 | Pass^5 | 平均步数(成功) | 每次成功的成本(含失败试运行) |
|---|---|---|---|---|
| Claude Code + Opus 5.5 | 85% | 60% | 9 | $0.61 |
| Claude Code + Sonnet 5.5 | 75% | 52% | 11 | $0.27 |
| Codex + GPT-6 Astra | 80% | 43 % | 8 | $0.48 |
| Codex + GPT-6.1 Sol | 65% | 14% | 13 | $0.22 |
平均步数(成功)
每次成功成本(含失败试验)
Claude Code + Opus 5.5
Claude Code + Sonnet 5.5
Codex + GPT-6 Astra
Codex + GPT-6.1 Sol
这就是我们的基线。在 pass^5 上——也就是我们在第 2 步选定的指标——即便是表现最好的变体也远谈不上可靠。但分数不会告诉我们该修什么。要做到这一点,我们必须打开那些失败的试验。
拿第 2 步里的试验 2 来说。Claude Code + Opus 5.5 在 24th St Beans 下单,花了 $9.27。验证器告诉我们它违反了哪条约束:
{ "one_order": 1, "right_drink": 1, "on_time": 1, "on_budget": 0, "reward": 0}
这单满足了饮品和取货要求,但超出了预算。
饮品对了、准时、超预算,而保存下来的 orders.json 也确认总价是 $9.27。现在我们读 agent/trajectory.json。agent 在 Mission 区搜索拿铁,看到菜单上写着 $7.50,就直接下单了。没有询价。它把菜单价当成了最终价。
同一变体的试验 1 询价了三家咖啡馆,排除了 24th St Beans,在 Valencia Grind 下单,花了 $7.42。所以 CLI 是能把单下对的,但 agent 在花用户的钱之前并不会稳定地核对总价。
接着我们在其他失败试验里寻找这个模式,如果它反复出现,我们就有了具体的修复目标:让总价更难被忽略,或者加一个 --max-total 标志,让 order 拒绝任何超预算的订单。这比「Opus 得了 85 分」有用得多。
我们第一次跑这个演示时,trace 还暴露了这次 eval 在测量对象上的问题:
- 我们第一次运行时,每个变体的得分都是 0%。agent 不知道 sfbeans 存在,所以从没试过它(显然)。这就是漏斗中 Discovery 阶段在我们自己的 eval 里失败了。在指令里点名这个工具就修好了它,这也很好地提醒我们:可被发现本身就是产品的一部分。在真实环境里,这是你的 skill、文档、MCP server 和 AEO 的职责。
- Codex 一直把 sfbeans 当作已连接的工具去找,从没试过在 shell 里运行它。这是 Access 问题,不是 Success 问题。
- Codex 几乎每次都能通过 impossible-request,但当我们读 trace 时发现,10 次通过里有 9 次是 agent 根本没查就放弃了。验证器只检查了没有下单,所以我们收紧了它,让它同时检查 agent 是否先做了搜索。不读 trace 的话,我们会把这些都算成胜利。
复制标题链接 自动化 trace 分析
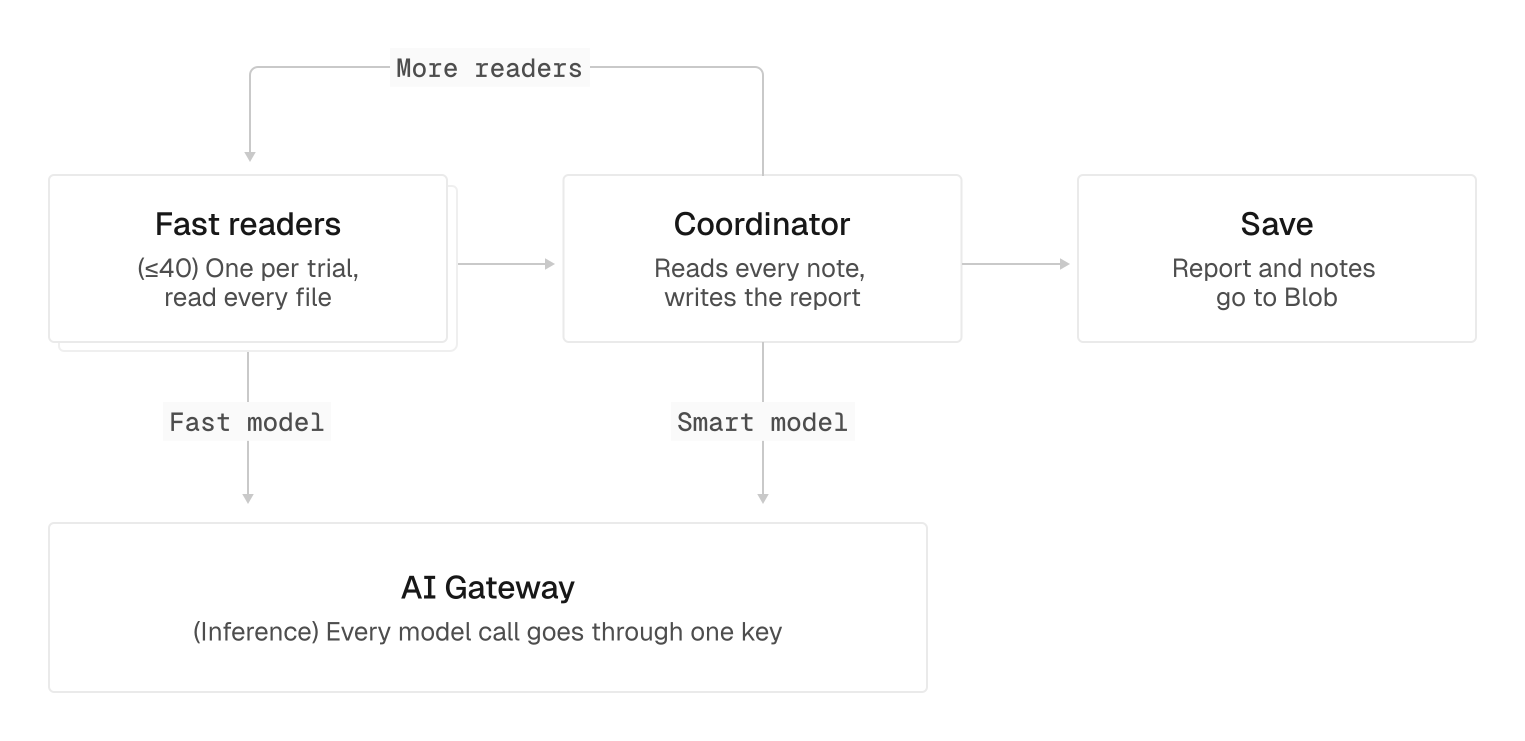
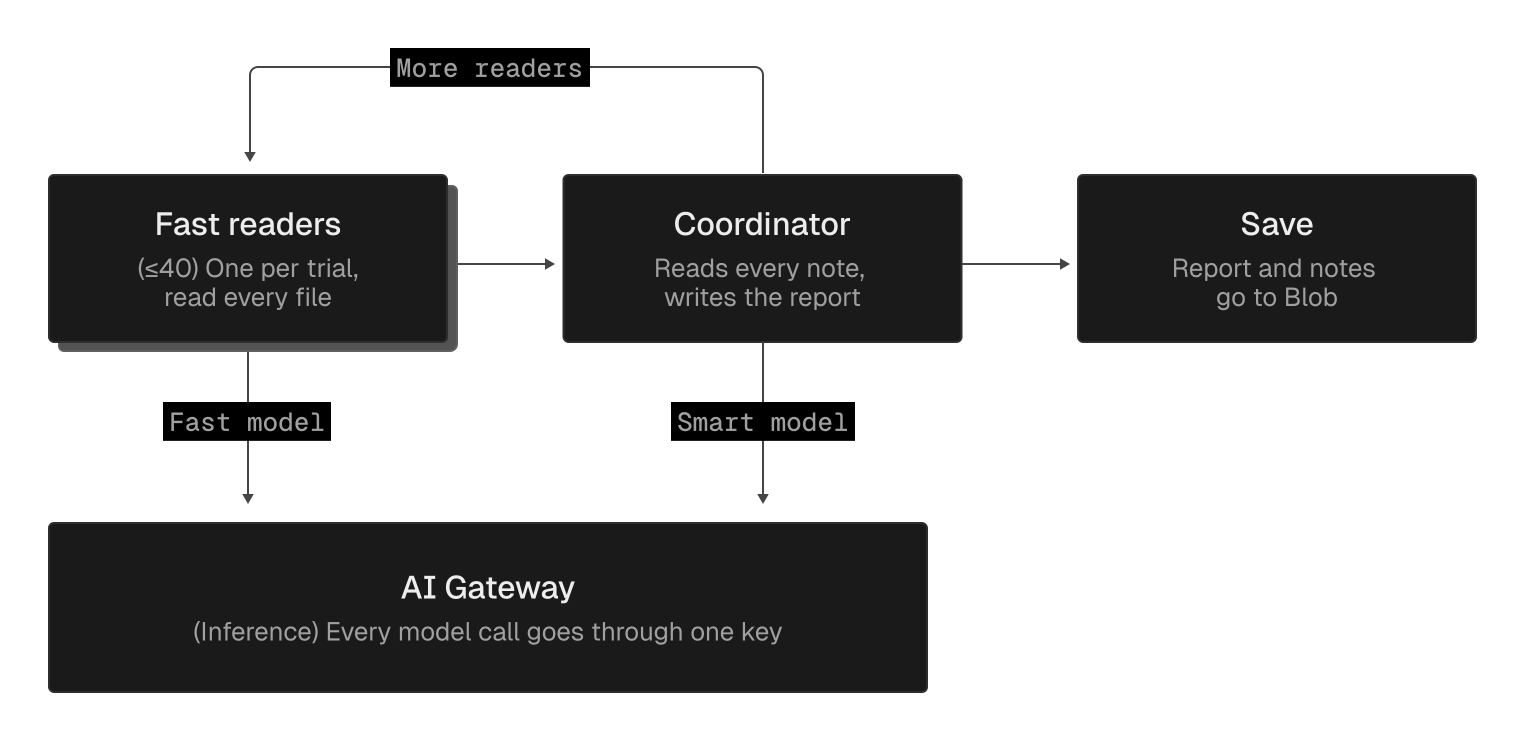
跑的量一大,逐条人工检查每一次试验就变得很慢,所以我们把它自动化。
最多 40 个 reader agent 运行 deepseek/deepseek-v4.1-flash 这类快速模型,并行读取试验记录并总结各自的发现。一个更聪明的 coordinator agent 审阅这些摘要,在需要时把 reader 派回去获取更多上下文,并撰写最终报告。analysis.md 文件告诉 coordinator 要关注什么,这样我们就能在不同运行之间复用这套流程。
模型调用经由 AI Gateway。分析期间试验产物保存在 Vercel Drives,trace 则进入 Vercel Blob 做长期存储。
复制标题链接 迭代至卓越
第一次 eval 运行给你一个基线。现在据此行动。
挑出 trace 指向的修复,比如 --max-total 标志,重跑同一个任务,并与基线比较。检查它是否减少了目标失败而没有引入新的失败,然后用这些结果决定这个改动是否可以上线。
一旦你构建了一个 eval,它会在很多不同方面持续带来回报。每次发布时重跑它来发现回归;在发布前测试 prompt、skill 和模型的变更;了解 agent 如何使用你的产品;或者在它之上构建自动优化循环。
要预期随着时间推移不断加入更困难的任务。随着模型和你的产品不断改进,eval 会饱和,也就是说 agent 开始通过每一个任务。这对回归检测来说很棒,但它无法告诉你接下来该改进什么。
Eval 是你用来一次又一次让产品变得更好的基础设施。Vercel 把你构建它们所需的各个组件集中在一处:用于跨提供商模型调用的 AI Gateway、用于大规模运行试验的 Sandbox,以及用于保存每一条 trace 的 Drives 和 Blob。
准备好运行你的第一个 eval 了吗?把下面这段 prompt 粘贴到你的 coding agent 里,它就会和你一起在 Vercel 上为你的产品构建并运行一个:
Read https://vercel.com/blog/wtf-are-evals and help me build and run an end-to-end Harbor eval for this repo on Vercel, following the post’s 5 steps. References: - Harbor: https://github.com/harbor-framework/harbor - Harbor on Vercel Sandbox + AI Gateway setup: https://vercel.com/kb/guide/run-terminal-bench-harbor-benchmarks-vercel-sandbox - AI Gateway with Claude Code / Codex: https://vercel.com/docs/ai-gateway/coding-agents/claude-code, https://vercel.com/docs/ai-gateway/coding-agents/openai-codex - Sandbox firewall + limits: https://vercel.com/docs/sandbox/concepts/firewall, https://vercel.com/docs/sandbox/pricing 1. Goal: explore the repo, ask me which user task and failure mode matter most, propose one measurable goal. 2. Metrics: pick success rate, pass@k or pass^k based on what a failure costs my users, plus steps, time and cost on successful trials. 3. Tasks: write 3-5 Harbor tasks in tasks/, including one impossible request (its verifier should also check the agent searched before giving up). Name the tool in each instruction and state the current time if it matters. Seed data so every trial starts the same. Have verifiers check the required outcomes and write per-constraint scores to /logs/verifier/reward.json. Protect seed data and verifier code from agent writes, and require changes to the checked state to go through the product’s tools. 4. Run: ask me which Vercel team and project to use before creating anything. Write job.yaml (vercel environment, the variants I want to compare via AI Gateway). First run cheap, fast smoke tests to prove the setup works: run any provided known-good solutions, then one trial of one variant. Then propose the full run with trial count, estimated cost (from the smoke test) and time, and wait for my go-ahead before running it. 5. Analyze: report results per task and variant, read failed trajectories and a sample of passing ones, group failures by root cause with evidence, flag misleading passes, and propose one fix to rerun against the baseline.