 Newshot
摘要
我在 GA100 裸片上发现了一个电压故障注入漏洞,允许操作者烧写任意熔丝。利用这个漏洞,我把自己的 CMP 170HX 8GB 显卡改造成了实际上相当于一块 A100-80G 的卡!此外,我解锁的卡实际运行速度比零售版 A100 快约 1.2 倍,因为所有功能正常的 SM 都被启用了(约 120-126 个,取决于裸片批次),而不是 NVIDIA 为所有量产 A100 卡选择的、为保证良率而设定的 108 个 SM。最后,CMP 被禁用的功能如 NVLink、PCIe Gen4、NVJPG、NVDEC、MIG 都可以通过这种方法解锁,不过我没有专门测试 NVJPG/NVDEC/MIG。
以下是我的“A100-80G”的显示状态和运行表现。
图表:GPU 清单与拓扑
        $ nvidia-smi --query-gpu=index,pci.bus_id,pci.device_id,name,memory.total; nvidia-smi topo -m
index, pci.bus_id, pci.device_id, name, memory.total [MiB]
0, 00000000:81:00.0, 0x20C210DE, NVIDIA Graphics Device, 81920 MiB
1, 00000000:C1:00.0, 0x20C210DE, NVIDIA Graphics Device, 81920 MiB
	GPU0	GPU1	CPU Affinity	NUMA Affinity	GPU NUMA ID
GPU0	 X 	NV12	0-127	0		N/A
GPU1	NV12	 X 	0-127	0		N/A
        .-----------------------------------------------------------------------------.
|----------------.------------------------------------------------------------|
| Device ID    0 | NVIDIA Graphics Device                                     |
| Device ID    1 | NVIDIA Graphics Device                                     |
|----------------'------------------------------------------------------------|
|----------------.------------------------------------------------------------|
| Device ID      | 0                                                          |
| Device Name    | NVIDIA Graphics Device                                     |
| Device Vendor  | NVIDIA Corporation                                         |
| Device Driver  | 610.43.03 (Linux)                                          |
| OpenCL Version | OpenCL C 3.0                                               |
| Compute Units  | 124 at 1410 MHz (7936 cores, 22.380 TFLOPs/s)              |
| Memory, Cache  | 81338 MB VRAM, 3472 KB global / 48 KB local                |
| Buffer Limits  | 20334 MB global, 64 KB constant                            |
| Max Workgroup  | 1024 threads                                               |
|----------------'------------------------------------------------------------|
| Info: OpenCL C code successfully compiled.                                  |
| FP64   Compute   (double, fma  )                     11.287 TFLOPs/s (1/2 ) |
| FP32   Compute   (float , fma  )                     22.781 TFLOPs/s ( 1x ) |
| FP16   Compute   (half2 , fma  )                     85.858 TFLOPs/s ( 4x ) |
| INT64  Compute   (long  , a*b+c)                      2.759  TIOPs/s (1/8 ) |
| INT32  Compute   (int   , a*b+c)                     22.769  TIOPs/s ( 1x ) |
| INT16  Compute   (short2, a*b+c)                     20.273  TIOPs/s ( 1x ) |
| INT8   Compute   (char4 , dp4a )                     81.169  TIOPs/s ( 4x ) |
| Memory Bandwidth ( coalesced read      )                       1883.17 GB/s |
| Memory Bandwidth ( coalesced      write)                       2137.93 GB/s |
| Memory Bandwidth (misaligned read      )                       1460.81 GB/s |
| Memory Bandwidth (misaligned      write)                        250.13 GB/s |
| PCIe   Bandwidth (send                 )                         13.10 GB/s |
| PCIe   Bandwidth (   receive           )                         11.69 GB/s |
| PCIe   Bandwidth (        bidirectional)            (Gen3 x16)   11.58 GB/s |
|-----------------------------------------------------------------------------|
'-----------------------------------------------------------------------------'
NVIDIA 使用熔丝进行产品分级、安全特性以及其他有趣的访问控制功能——而关键在于,在 NVIDIA 芯片上烧断熔丝在某些功能上反而会授予你更多访问权限,而非更少。在一个设计得当的安全体系中,烧断熔丝理应始终导致更受限的状态,因为烧断的熔丝无法以经济可行的方式恢复。NVIDIA 的设计却允许通过烧断更多熔丝来放宽限制!
在本文中,我将介绍 GA100 芯片、其熔丝控制器、VFI 的使用以及未来的研究方向。我决定公开部分支撑我研究的工作。
致谢
我的工作建立在 Jon Pry 以及众多其他人的先前研究之上,他们投入了大量时间来更好地理解 GA100 芯片。我在另一位安全研究员独立发现同一漏洞之后披露了我的发现;我认为将这一信息公之于众符合公众的最佳利益。这些发现在本文发表之前已披露给 NVIDIA 的产品安全团队。
GA100 版本
GA100 是 NVIDIA 的一款芯片,已被用于近 20 种不同的 SKU——其中 A100 是最广为人知的变体。我不会深入探讨每一个 SKU,但会介绍与我的工作相关的 GA100 表现形式,涵盖 CMP 170HX 和 A100 的不同版本。
制造完成时,GA100 芯片拥有 128 个 SM、12 个 FBP、5 个 NVDEC 单元、一个 PCIe Gen4 x16 控制器,并且根据帧缓冲大小,附带 4-6 层与芯片共封装的 HBM。NVIDIA 使用 eFuse 进行良率控制和产品分级——未分级的 GA100 根据缺陷测试和厂商需求转变为限制更多的变体。
在产品分级最极端的表现形式之一中,CMP 170HX——一款名义上具有 8 或 10 GB 应用可见帧缓冲容量的以太坊挖矿卡——实际上分别板载了约 80 和约 40 GB 的 HBM!本工作主要围绕如何完全解锁并使用该容量。先前的工作已通过软件方法在解锁 GA100 方面取得了巨大进展;VFI 带我们走完了最后一英里。
| SKU | 开箱状态 | 软件(cmpunlocker) | GA100VFI |
|---|---|---|---|
| 帧缓冲 | 8 GB | 64 GB | 64-80 GB 1 |
| 帧缓冲 | 10 GB | 40 GB 2 | 40-48 GB |
| SM | 70 | 70 | 120-128 |
| PCIe 代数 | 1 | 2 | 4 |
| NVLink | 否 | 否 | 是 3 |
| ECC | 否 | 否 | 是 4 |
| 多实例 GPU | 否 | 否 | 是 4 |
| NVDEC | 0 | 0 | 5 4 |
硬件限制
那么,NVIDIA 如何利用熔丝从同一芯片同时生产数据中心 A100 和挖矿 CMP 卡?要理解这一点,我们需要更仔细地观察位于 GA100 上的熔丝控制器。
熔丝控制器是一个包含 16,384 个 eFuse(512 行,每行 32 个)的模块,以及围绕该原始熔丝宏的一堆逻辑。它的职责是执行熔丝读出和编程、保护底层熔丝,并向芯片其余部分提供可用的“选项字”。这些选项字随后决定芯片如何运作以及启用哪些特性。
每个 eFuse 可以处于两种状态之一(烧断=1,未烧断=0),512 行被划分为 4 个区域:
像 {{NAME_ab12cd34}} 这样写入的值是真实值的占位符。请完全按照书写形式使用它们,在回复和工具调用中都是如此:它们会在任何内容运行之前被填入真实值。不要要求验证它们,也不要用示例替换它们。
- 常规熔丝(第 0-221 行)。这类熔丝比较直接;通常单个(成对的)熔丝会映射到一个选项字,例如 OPT_ENABLE_FUSE_PROGRAM(一个选项字,决定是否允许继续烧录熔丝)。常规熔丝带有内置冗余:例如,OPT_ENABLE_FUSE_PROGRAM 由一个 PRI 和一个 RED(主熔丝与冗余熔丝)组成,在这个例子中,主实例是第 0 行第 0 个熔丝,冗余实例是第 1 行第 0 个熔丝。有些选项字是标量,例如 OPT_X_COORDINATE,它宽 9 位,名义上保存该裸片在制造晶圆上的 x 坐标。重要的是,如果某个常规熔丝已被烧断,基本上没有办法持久地将其恢复为未烧断状态(除非后续使用 RIR)。
- 无熔丝熔丝(Fuseless fuses,第 222-487 行)。这一类比较奇怪。显然 NVIDIA 对意外烧断常规熔丝、毁掉工程样品感到恼火,于是设计了一套系统,以类似 JTAG 链的格式来编码生效的选项字(见这项专利)。可以把 FF 理解成一份脚本,描述哪些选项字应该取什么值。FF 熔丝(请原谅这里的 RAS 综合征式重复)关系到我们能用 VFI 解锁的绝大部分功能。这是因为只要写入新的 FF 行,就能轻易清除 FF 选项字!后文我们会更深入地讨论这一点。目前你只需知道,NVIDIA 也清楚这一点,因为在正常情况下,你被严格禁止执行任何 FF 熔丝烧录。
- IFF 熔丝(第 487-512 行)。它们包含的指令格式与 FF 不同。它们不在本文讨论范围内,主要用于对熔丝控制器的选项字进行即时重编程。在生产卡上通常无法访问它们。
- RIR 熔丝(8 行、每行 32 个熔丝,严格来说不属于这 512 行)。它们由熔丝宏的设计方提供(TSMC 数据手册见此),本质上是原厂设计者预设的“熔丝修复”机制。GA100 上的 RIR 区域可容纳 16 条修复指令,每条指令覆盖主 512 行中某个指定熔丝的值。对我们不幸的是,具体到 8 GB 的 170HX SKU,16 个 RIR 字中有 15 个全为 1,第 16 个字编码的是一条无用的修复指令,几乎无法用于任何有价值的解锁。10 GB SKU 的情况不同,但那是另一个话题了……
对于基于 VFI 的解锁,有两组真正值得关注的熔丝:
- “控制熔丝”。这个术语来自 NVIDIA 的 Tegra 硬件头文件,专门指第 0 行和第 1 行,它们规定了高度安全敏感的选项字的值。
- 无熔丝熔丝,它们编码了所有决定一块 GA100 生来是寒酸的矿卡还是 AI 数据中心主力卡的有趣选项字。
在列出一些由 FF 编码的选项字之前,我们需要先更详细地了解 FF 记录格式,然后再讨论掌管我们感兴趣功能的裸片模块。
无熔丝熔丝
每个 FF 行是一条 32 位记录。第 0–4 位选择一条链,第 5 位区分 FF 与 IFF(FF 为 0),第 6–15 位选择一个 16 位块,第 16–31 位提供该块的新值。专利中的 JTAG 链图在这里相当字面:控制器通过将这些记录重放进链来构建选项数据。每条链中的固定位置对应各个选项字。
如果两条记录指向同一条链和同一个块,则后一条记录生效。例如,0x0fe805c1 表示链 1、块 23、数据 0x0fe8。追加这条记录可以清除先前某条 FF 记录所设置的生效位。并没有物理熔丝被恢复为未烧断;而是新的一行替换了旧的 16 位块。这对由 FF 支持的选项有效,但对第 0 行和第 1 行中的常规控制熔丝无效。
既然我们已经知道 FF 字是如何编码的,下面列出一些有意思的字及其位置。这些是由一位特别有帮助的研究人员发现的,他交叉比对了不同 GA100 SKU 的 FF 值和有效选项字,以便通过差分方式理解 FF 链/块到选项字的映射,因为目前没有已知的官方映射。
| 命名选项 | 推断的 FF 位置 | 用途 |
|---|---|---|
| NV_FUSE_OPT_FBIO_DISABLE | 链 1 位 83–106;块 5–6 | 内存 I/O floorsweep |
| NV_FUSE_OPT_FBPA_DISABLE | 链 1 位 107–130;块 6–8 | 内存子分区 floorsweep |
| NV_FUSE_OPT_GPC_DISABLE | 链 1 位 131–138;块 8 | GPC floorsweep |
| NV_FUSE_OPT_TPC_GPC0_DISABLE 至 NV_FUSE_OPT_TPC_GPC7_DISABLE | 对于 GPC i,链 1 位 187+8i 至 194+8i;块 11–15 | 八个 TPC 掩码 |
| NV_FUSE_OPT_PES_DISABLE | 链 1 位 251–274;块 15–17 | PES floorsweep |
| NV_FUSE_OPT_FBP_DISABLE | 链 1 位 307–318;块 19 | 帧缓冲分区 floorsweep |
| NV_FUSE_OPT_ROP_L2_DISABLE | 链 1 位 319–342;块 19–21 | ROP/L2 floorsweep |
| NV_FUSE_OPT_NVLINK_DISABLE | 链 1 位 368–370;块 23 | NVLink 禁用掩码 |
| NV_FUSE_OPT_DISABLE_GEN3_SPEED | 链 2 块 39;位 1 和位 9 中哪一个尚未确定 | PCIe Gen3 速度限制 |
| NV_FUSE_OPT_PCIE_MAGIC_BITS_D[25] | 链 2 块 47 位 3 | Gen4 速度禁用标志 |
| NV_FUSE_OPT_PCIE_BOOT_GEN23_DISABLE | 链 2 块 49 位 6 | PCIe 启动策略 |
| NV_FUSE_OPT_PCIE_BOOT_GEN3_DISABLE | 链 2 块 49 位 7 | PCIe 启动策略 |
| NV_FUSE_OPT_PCIE_DEVIDA | 链 2,位 593–608;块 37–38 | 设备标识 |
| NV_FUSE_OPT_PCIE_DEVIDB | 链 2,位 609–624;块 38–39 | 设备标识 |
| NV_FUSE_OPT_SYS_PIPE_DISABLE | 链 1,位 372–379;块 23 | 多实例 GPU 启用的管道 |
缩写 FBIO/FBPA/FBP/TPC/GPC/PES/ROP 均指微架构元素,请参阅 GA100 白皮书中的这张图,以进一步理解它们之间的相互关系:
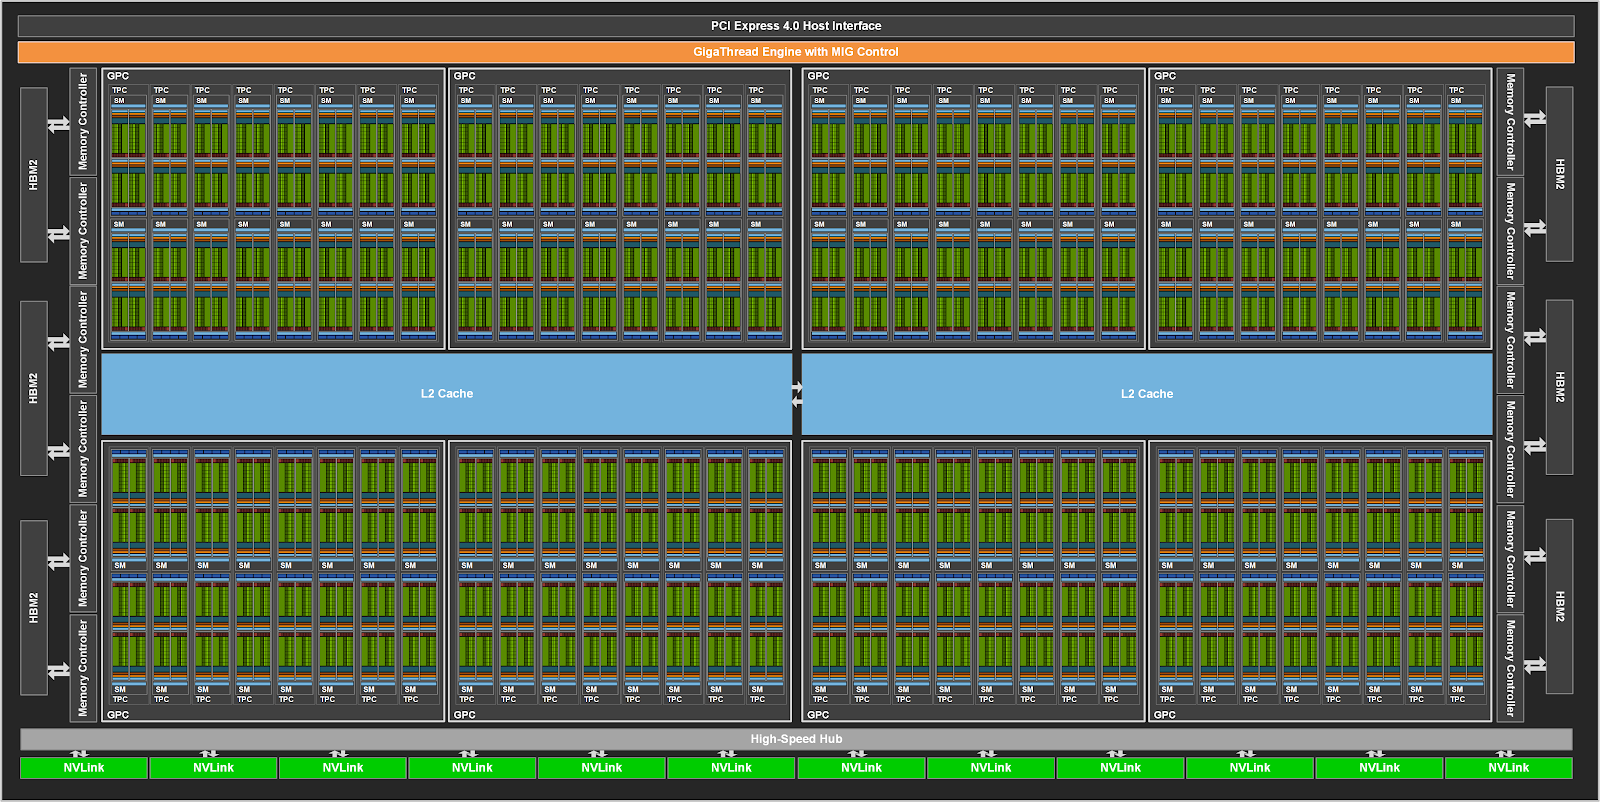
FBP 是 NVIDIA 内部对“帧缓冲分区”的称呼,2 个 FBP 对应一个 HBM 堆栈。FBPA 是子分区,2 个 FBPA 对应一个 FBP。PES/ROP 是 SM 正常工作所必需的块(似乎与图形相关)。
掌握了这些知识后,如果我们能写入新的 FF 行,将 _DISABLE 字全部置零,或者至少在芯片缺陷允许的情况下尽可能放宽,会怎样?如果我们观察 _DISABLE 选项如何与其他元素配合使用,很快就会发现这些 _DISABLE 字是我们防止芯片部分区域被“floorsweep”的主要杠杆。在阐明“如果怎样”之后,我将讨论“如何做”:电压故障注入的具体应用,以及我们可以通过 VFI 击败的熔丝控制器保护措施。
Floorsweeping
NVIDIA 让这些选项负责设置 floorsweep 信号,这会使某个芯片元素不可访问(并且很可能断电)。根据实验,我认为 floorsweep 线是在 RTL 中指定的,从熔丝控制器发出,终止于各个功能块,并控制块内某个主电源/时钟域开关。我观察到 floorsweeping 行为与熔丝控制器针对每个功能块的有效状态字值之间的延迟非常小。
以 FBP floorsweeping 为例。在我的一张 8 GB 卡上,OPT_FBP_DISABLE 为 0x852:FBP 1、4、6 和 11 被屏蔽。单独的 OPT_FBP_DEFECTIVE 掩码为 0x840,覆盖 6 和 11。在我用替换的 FF 行将 FF 支持的禁用掩码缩减为 0x840 后,1 和 4 上的额外掩码消失了,但有缺陷的 6 和 11 仍保持禁用。这样,在有效掩码中,该 die 的 12 个 FBP 中还剩下 10 个。从功能上看,当 OPT_FBP_DISABLE 为 0x852 时拒绝寄存器读写的 FBP 1 和 4,在这次 fuse 写入后变得可响应。
尽管可以通过 FF 写入将功能块“解除 floorsweep”,但这并不足以使该块完全可供最终应用程序使用——例如,默认的 framebuffer 几何配置只使用每个可用 HBM stack 的一部分。
为了绕过这一点,我们可以利用本质上是对 cmpunlocker 方法的一处小修改。通常用于 8 -> 64 GB 解锁的驱动补丁会写入一组特定的功能配置字(FBPA_CFG、SM_SPEED_SELECT 等)。默认值的选择是为了在常见的 170HX 变体上成功,该变体具有 _DISABLE FF 派生的选项字,阻止某些功能块被使用(任何使用它们的尝试都会返回 floorswept 错误)。在解锁 FF 烧录到位后,我们可以将更宽松的字写入配置寄存器,从而在功能上得到一块 A100-80G。
实现 FF 烧录
根据我们掌握的信息,似乎很直接:如果可以烧录任意 FF fuse,那么任何 GA100 都可以被完全解锁到其最大能力,这取决于 die 良率和已装配的内存 stack。但我们要如何烧录 FF fuse?让我们进一步了解 fuse 控制器的 fuse 编程功能。
要请求 fuse 烧录,必须向属于 fuse 控制器的 FUSEADDR、FUSEWDATA 和 FUSECTRL 寄存器写入。虽然名义上主机或非特权请求者无法访问,但借助 Canary in the Crypto Mine ROP,打开相应的特权级掩码是轻而易举的。因此,许多研究人员曾尝试迫使 fuse 控制器烧录 FF 区域的 fuse。我们的一些共同观察如下:
- fuse 控制器有一个内部 FSM,并通过 FUSECTRL_STATE 位指示其当前状态。
- fuse 控制器针对请求的 FUSEWDATA 值中的每个“热”位进入一次 WRITE_PROGRAM 状态。这与预期的 fuse 编程行为一致。
- 然而,除非清除某个特定的选项字,否则对 FPF 范围(第 96-221 行)之外的 fuse 地址的写入实际上不会发生。该区域内的 fuse(据信是“field programmable fuses”,指示哪些 ucode 版本已运行的水印,以及其他与 field 相关的信息)确实会生效,并且 fuse 控制器状态机在 FPF 和非 FPF 区域之间的行为完全相同。
我所指的这个特定选项字是 OPT_SECURED_BURN_FEATURE_ENABLE(“SBFE”),它在所有量产卡中都被设置为 1。当该选项字被清除时,允许在任意地址进行 fuse 编程。当它被设置时,只能烧录 FPF fuse。迄今为止,还没有人找到在 SBFE=1 时烧录 FF fuse 的任何方法,即使从 HS 上下文操作 fuse 控制器也不行。目前尚不清楚“secured burn”的真正含义,我推测一定存在一种仅靠软件的方式,即使在 SBFE=1 时也能执行非 FPF 烧录,只是我们不知道这里“secured”这个形容词到底意味着什么。
注意 PLM、HS、ucode……;随着解释的深入,我在本节中使用了大量 NVIDIA 特有的术语。关于这些术语真正深入的解释,我推荐你参考其他资料,例如 Je Ne Sais Quoi - Falcons over the Horizon。
重要的是,正如人们在限制更宽松的卡上已经发现的那样,在 SBFE=0 的情况下执行 FF 烧录是可能的!而事实证明,达成这一状态正是我们实现 GA100 解锁的方式。经过大量试错,我最终借助电压故障注入来诱发这一状态,并且成功做到了。下面再谈谈电压毛刺。
电压故障注入
关于 VFI 已有诸多论述,深入的讲解我留给其他资料。简而言之,施加短暂的供电电压低落脉冲,往往会导致集成电路出现异常行为。我让 GPT-6 Astra 设计了一块基于 STM32G4 的板子,接入 CMP PCB 上的 PWMVID 信号。PWMVID 是 NVIDIA 的电压调节器标准,我的毛刺器拦截 GA100 裸片发出的 PWM 信号,并用自己产生的波形替换它,送入 MP2888B VRM 驱动 IC。借助我的装置,我可以诱使显卡自身的 VRM 为我产生定时毛刺,这比基于 MOSFET 的方案更简单,并且比试图直接驱动 PMBus 能实现更快的毛刺。
毛刺器需要与 PCB 建立两处连接,最好使用漆包线/自粘线完成。一根线接入 NVVDD 用于电压检测,另一根线接入 PWMVID 信号。毛刺器工作所需的唯一其他步骤是移除一颗 0402 0 欧姆电阻,这会断开 GA100 输出 PWM 引脚与 VRM IC 之间的连接。通过追踪 MP2888B 的引脚定义,特别是其 PWMVID 和 VOSEN 引脚(MP2888B 与其公开的同系列芯片 MP2888A 共用封装),找到接入点并不困难。紧邻 MP2888B 的测试点使得 PWMVID 接入相对容易安装。
接入点就位后,一次毛刺尝试包含以下序列:
- 断开显卡供电
- 施加显卡供电
- 一旦 NVVDD 越过阈值就启动定时器(“毛刺定时器”)
- 按照毛刺定时器对齐,发出 PWMVID 信号以执行预设的电压波形
- 观察显卡行为,按需从第 1 步重复
我的装置通过简单的 ACPI S0 -> S3 -> S0 转换完成第 1/2 步,在现代桌面平台上这只需几秒钟。更具侵入性的改造或昂贵的测试台或许能获得更好的实验速率,但根据我的经验,使用后文所述的方法,这套装置足以在 1 小时到 48 小时的毛刺时间内解锁显卡。
对于 NVVDD 阈值,Astra 编写的固件使用 STM32 比较器检测 NVVDD 何时越过 225mV,随后一个紧凑的 DMA 循环在 PWMVID 引脚上驱动所需的占空比。进入 S0 后,主机检查显卡状态并决定下一步;如果涉及另一次毛刺,毛刺板将通过 USB 接收毛刺模式指令。然后主机通过 RTC 定时器触发 S3,在约 3 秒后唤醒(该周期由经验得出,可获得不错的稳定性)。
有时主机无法返回 S0,我用一台 SBC(Radxa Cubie A5E)来分担记录工作和毛刺活动准备,以此补救;如果毛刺目标主机无响应,它还可以通过 GPIO 驱动主板的电源/复位按钮引脚。
如果你感兴趣,更多细节分享在 GA100VFI 仓库中。现在,让我们看看可以通过 VFI 触发的各种有趣状态,以及烧录 FF 行所需的具体毛刺状态。为帮助阐明各毛刺状态之间的差异,我构建了一个经验模型,描述保险丝控制器在施加电压时如何启动。请注意,在没有实现保险丝控制器的 RTL 的情况下,我们所有的都只是猜测。以下是假设的启动阶段:
- 按保险丝宏的要求,感知 RIR
- 感知(从保险丝宏到读出寄存器)控制行
- 将控制行锁存为控制行派生的选项字
- 感知剩余行
- 将常规保险丝值锁存到各自的选项字
- 解析 FF 链
- 将 FF 链的值锁存到各自的 option word 中
这些假设的阶段基于我实际能从芯片裸片上读到的内容:控制器状态、CMD_READ 生效时的原始行、已公开的 option word,以及 PRI ring 是否仍能访问 GPU 的其余部分。通过观察几个关键值,我们可以区分不同的 glitch 结果。重要的是,glitch 模式和结果非常依赖于具体的芯片裸片,因此请将这些示例波形和响应仅视为示例。我们来看 3 个有趣的 glitch 状态。
1. 所有 fuse 均被感知为零
某些 glitch 会使几乎所有已公开的 option word 读为零。在一个捕获到的状态中,672 个有名称的 option 读取中有 669 个为零;另外三个是错误响应。控制器的 CRC 状态为 0x00(尚未解析),PCIe ID 读为 2080(基础 GA100 PCIe 产品 ID,不对应任何真实零售产品),并且 GPU 的 PRI ring 被保持在复位状态。
该状态与 fuse 控制器发生灾难性故障的情况一致。板卡启动后基本不可用,因为几乎所有启动功能都被全零状态破坏。然而有趣的是,板卡原生以 PCIe Gen4 速率训练成功!一些略有变化的变体可能展示部分 fuse 被成功锁存,或包含乱码值而非全零。我未能将任何这些状态推进到 FF 烧录;在几乎所有这些状态中,fuse 控制器都不可达或功能失常。
2. RIR 读取被破坏
读取 CMP 170HX 8GB 上的 RIR 数据揭示了其确切效果:15 条 noop 修复指令,以及一条写入,该写入改变第 18 行中某个 fuse 的值,而我们可以监控该 fuse 的 option word。此外,由于 RIR 感知是由 fuse macro 内部消耗的,而不是直接由 fuse 控制器消耗,我们可以通过尝试读取原始行来观察被破坏的 RIR 锁存——观察到的位翻转在被翻转的 option word 以及原始 fuse 行中保持一致。这为研究芯片裸片启动设定了一个有趣的时间顺序检查点(RIR 感知必须先于其他 fuse 感知发生),但本身并不是一个有用的 glitch。
3. 金发姑娘的 glitch
我第一张卡上成功的三脉冲状态似乎恰好破坏了基于 row0/1 的 option word,同时保持其他 fuse 和 option word 完好。在此状态下,所有源自 row0/1 的 option word 均为零。初始回读如下所示:
| 信号 | 初始回读 |
|---|---|
| PCI ID 和访问 | 20c2 ;BAR0 和 PRI ring 有响应 |
| FUSECTRL | 0xe0040000 ( IDLE ) |
| CRC_ STATUS | 0x55(两半均解析无错误) |
| DISABLE_ SW_ OVERRIDE | 0 |
| OPT_ SECURED_ BURN_ FEATURE_ ENABLE | 0 |
| ENABLE_ FUSE_ PROGRAM | 0 |
| FUSECTRL/FUSEOPT 权限掩码 | 两者均为 0xffffffff |
| 原始行 0 和 1 | 两者仍为 0x53557c3d ,与 glitch 前相比未改变 |
在此阶段,我们仍无法发出 FF 写入,因为 ENABLE_FUSE_PROGRAM=0。老实说,我不确定为什么 ENABLE_FUSE_PROGRAM 会为零,鉴于它在零售板卡中为 1,所以这在我看来几乎像是一种实现 glitch 检测金丝雀的方式(或者至少这样做会很优雅)。
Fuse 感知一次发生一行,所有 32 个 fuse 由一条线供电进行感知,这意味着攻击者要让单个 fuse 看起来被清除或置位要困难得多。因此,包含一个“金丝雀” fuse 是合理的,该 fuse 在被清除时禁用安全关键功能(如 fuse 烧录),因为通常攻击者最多只能在行粒度上操纵 fuse 感知。所以,当 row0/1 的 option word 全部显示为已清除时,ENABLE_FUSE_PROGRAM=0 阻止我们烧录任何 fuse。
不过,看看我们在这一状态下得到的结果:DISABLE_SW_OVERRIDE=0。这个字通常为 1,它会阻止我们将 EN_SW_OVERRIDE 寄存器置为 1,而置为 1 之后,我们就能“遮蔽”fuse 控制器所暴露的大多数 option word。具体做法是写入与 option word OPT_ 对应的寄存器 CTRL_OPT_,再由它决定有效值 STATUS_OPT_*。正是这一点让我们能够将 SBFE 遮蔽为 0。但是,尽管我们有 DSOV=0,ENABLE_FUSE_PROGRAM 却是即使 DSOV=0 也无法遮蔽的 option word 之一。所以看起来我们卡住了。
至少我当时是这么想的,并且在这个状态下撞了好一阵子墙。然后我注意到还有一条 fuse 控制器命令我尚未尝试发出:SENSE_CTRL。我之前一直克制着没有发出它,因为从表面上看,所有由 row0/1(控制 fuse)派生的 option word 似乎都会匹配其 fuse 值,这会重置 SBFE、关闭软件 option word 遮蔽,并让我们无法烧录 fuse。令我惊讶的是,当我发出这条命令时,所有由控制 fuse 派生的选项都变成了其 fuse 值,唯独 DISABLE_SW_OVERRIDE 保持为 0!
在 DSOV=0 的情况下,我们可以轻而易举地将 SBFE 置为 0,ENABLE_FUSE_PROGRAM 因为匹配其 fuse 值而为 1,于是我们就可以大干一场了!还剩一个小麻烦:FUSEWDATA 可能有一个被锁定的 PLM,但在 DSOV=0 的情况下,我们只需向 OPT_SECURE_FUSE_WDATA_WR_SECURE 写入 0,就能将 PLM 置为全 1,从而开放主机对 fuse 烧录的访问。
此时,剩下要做的就只是为我们所关心的特性计算出与 _DEFECTIVE 值相匹配的 _DISABLE 字,然后发出 FF 烧录。注意,被占用的 FF 空间和缺陷位因 die 而异,因此每次烧录都必须针对具体 die 量身定制。
最终结果
帧缓冲解锁
在 80 GB 完好的 8 GB 卡上(根据我有限的样本,这似乎约占 8 GB 卡的 ~90%),解锁后可获得完整的 80 GB 作为可用帧缓冲。多项合成测试(在整个帧缓冲中写入伪随机字,并在 L2 失效后读回)以及真实工作负载(例如 vLLM 和 SGLand)均完全正常。如前所述,我的一张卡只有 64 GB 完好。在这种情况下,硬件解锁不会带来帧缓冲方面的优势。
计算解锁
170HX 出厂时被限制为 70 个 SM。实际上,die 上几乎总是有 >120 个 SM 无缺陷,解锁后即可全部使用。这带来了显著的性能提升,相比仅靠软件解锁的 170HX 约为 ~1.7 倍,甚至相比零售版 A100 也有令人印象深刻的 ~1.2 倍。
PCIe 代际
阻止 cmpunlocker 超越 PCIe Gen2 的唯一障碍就是 FF option word。清除相关位后,Gen3/4 可以完成链路训练,并被确认完全正常。结合 PCIe 去耦电容改造,最高可达 PCIe Gen4 x16,与零售版 A100 PCIe 变体相当。
NVLink
将 OPT_NVLINK_DISABLE 字清零只是让 NVLink 真正工作所需的改造之一。由于 CMP 170HX PCB 缺少 U11 IC(它将 PCIe 3.3v 连接到 NVLink 桥接引脚),原装板卡无法启动所连接 NVLink 桥上的参考时钟发生器。只需短接 U11 封装上的两个引脚即可解决此问题,尽管这会失去 U11 所提供的任何稳压或保护。如果你要桥接由不同电源供电的 GPU,请务必小心,因为除非你在部分 GPU 上不焊接 U11,否则这会将 +3.3V 电源轨连接在一起!如果你只在一对板卡中的一块上补装 U11,NVLink 桥即可正常工作。
在 NVLink 启用的固件方面,有一个 ROM 检查需要通过额外的主机侧命令绕过。我相信你的 clanker 能搞定 ;)
在调查 NVLink 解锁的过程中,我还发现了 NVIDIA 在 GA100 上 NVLink 实现的一些有趣怪癖。我之后会再发一篇博客详细讨论,敬请关注!
未来方向
借助任意熔丝烧录,我们主要获得的是功能解锁。一些安全敏感的选项出厂时默认未烧录,烧录它们可能带来有趣的立足点。但对我来说更有趣的是更深的故障状态——许多默认已烧录的安全敏感熔丝被感知为未烧录,从而开启诸如调试 HS 执行之类的路径,这将赋予对芯片内部前所未有的访问权限。
参考文献
- Jon Pry, A Canary in the Crypto Mine: Defeating Stack Protection in a GPU Secure Coprocessor (2026).
- Amogh Munikote, cmpunlocker (2026).
- Otto Bittner et al., The Forgotten Threat of Voltage Glitching: A Case Study on Nvidia Tegra X2 SoCs (2021).
- NVIDIA, US9230678B2: Integrated circuit having an enhanced fuseless fuse structure (2016).
- TSMC, TEF07F32X32HD18_PHRM_C180518 electrical fuse datasheet, rev. 120A (2018).
- hexkyz and SciresM, Je Ne Sais Quoi - Falcons over the Horizon (2021).
- TechPowerUp, NVIDIA GA100 GPU specifications.
- GA100VFI source repository.
脚注
- 据轶事,在我检查过的 10 块 CMP 170HX 8 GB 样本中,只有一块出厂时仅有 64 GB 可用,其余的实际帧缓冲大小均为 80 GB。 ↩
- 尽管 Canary in the Crypto Mine 论文声称在 10 GB SKU 上可稳定实现 80 GB,但现实中极少有(如果有的话)显卡能够做到这一点,确凿证据也很稀缺。仍有可能一定数量的 10 GB SKU 确实出厂时板载 80 GB,但根据社区反馈,这一比例似乎非常低。大多数“不稳定”的 80 GB 解锁可以用 L2 缓存与基于真实 40 GB 帧缓冲的内存别名相结合来解释。 ↩
- 启用 NVLink 还需要一个非常小的硬件改动,因为 170HX PCB 上缺少一个元件,我稍后会详细讨论。 ↩
- 未测试。 ↩ ↩2 ↩3