 Newshot
主要
基因表达谱将乳腺癌分为 luminal A 或 luminal B(激素受体阳性(HR+))、HER2 阳性和基底样亚型。其中,基底样亚型在很大程度上与三阴性乳腺癌(TNBC)2,3 重叠。这些分类指导治疗管理和预后。Luminal HR+ 乳腺癌通常对内分泌治疗有反应,结局良好,但许多患者仍会复发8。单细胞和空间研究已揭示各亚型内部存在显著的瘤内异质性,这种异质性可能驱动治疗抵抗和复发4,5,6,7,9。
由 DNA 和组蛋白翻译后修饰(PTMs)介导的染色质组织,促进遗传上相同的细胞获得表观遗传上不同的细胞状态10,11,12。尽管单细胞 RNA 测序(scRNA-seq)和单细胞染色质可及性测序(scATAC–seq)描绘了瘤内异质性13,14,15,16,但染色质模式的贡献仍不清楚17。组蛋白标记的单细胞分析,例如组蛋白3第27位赖氨酸三甲基化(H3K27me3),表明染色质状态与乳腺肿瘤异质性和治疗抵抗有关18,19。然而,这些方法只能测量有限数量的染色质标记,这阻碍了对复杂模式和相互作用进行分析。我们开发了一种飞行时间流式细胞术(CyTOF)方法,以系统分析多种组蛋白 PTMs 并解码群体特异性染色质模式,从而考察癌细胞间的异质性20,21,22,23。
肿瘤表观遗传状态也反映在血液中。无细胞的血浆循环核小体主要由死亡中的正常细胞和癌细胞释放,保留组织来源的表观遗传模式24,25,26,27。我们的单分子成像平台——血浆分离核小体表观遗传学(EPINUC)——可捕获血浆核小体上的多种表观遗传特征28。该方法可检测结直肠癌,包括低负荷早期疾病28,并能够对儿童脑肿瘤进行微创分子分析和治疗监测29。
在此,我们展示对原发未治疗乳腺肿瘤和血液无细胞核小体的整体表观遗传分析。将反复出现的瘤内表观遗传模式与循环核小体联系起来,将肿瘤表观遗传异质性与其潜在临床意义联系起来。这项工作揭示表观遗传改变是瘤内异质性的关键介导因素,并可作为早期诊断和预后的潜在生物标志物。
乳腺肿瘤的单细胞表观遗传学
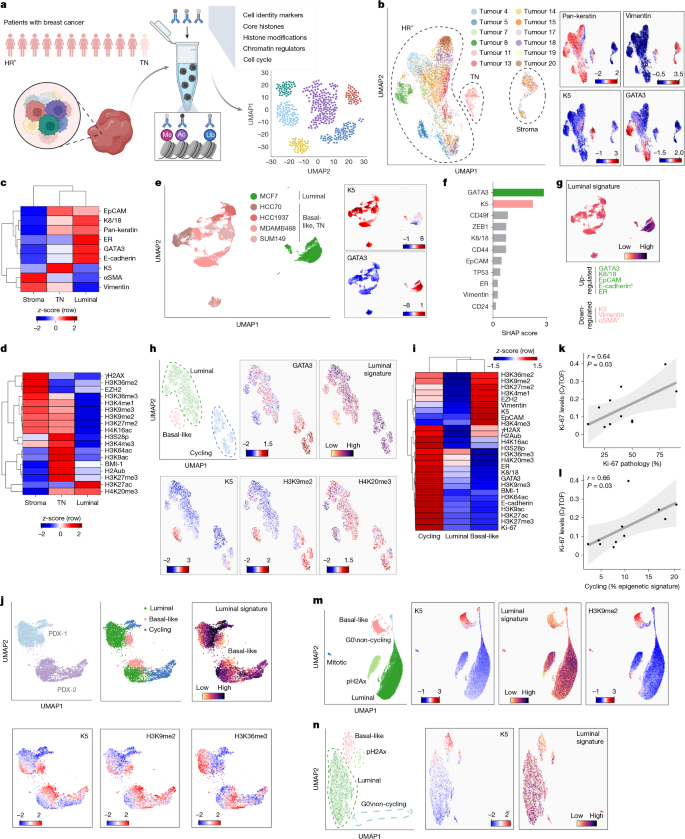
为评估乳腺肿瘤组蛋白修饰的异质性,我们对来自未接受治疗女性的新鲜手术切除肿瘤进行了表观遗传聚焦 CyTOF,并在单细胞分辨率下量化了组蛋白修饰(图 1a 和补充表 1)。该队列主要包括 luminal HR+ 肿瘤,仅有一例 basal 三阴性(TN,HR–)肿瘤(n = 12;补充表 2 和补充图 1a,b),因为标准新辅助治疗使大多数 TN 病例被排除在未接受治疗资格之外。经过批次校正和归一化后,对所有 12 个肿瘤的均匀流形近似与投影(UMAP)分析显示,肿瘤细胞主要占据患者特异性区域,而基质细胞跨患者聚集在一起。这一结果与先前测量单细胞基因组差异的研究一致13,14(图 1b、方法 和补充图 2a)。来自不同患者的 luminal 肿瘤细胞之间的部分重叠可能反映了共享的谱系特异性表观遗传程序。正如预期,基质细胞表达 vimentin 和 αSMA,而肿瘤细胞表达上皮角蛋白、EpCAM 和 E-cadherin(图 1b,c 和补充图 2b,c)。值得注意的是,basal TN 肿瘤与 HR+ 肿瘤不同,表现为 luminal 标志物 GATA3 低表达,以及 basal 标志物 cytokeratin-5(K5;也称为 KRT5)和间充质 vimentin 标志物高表达(图 1b,c 和补充图 2d)。基质和肿瘤染色质模式也不同,这一结果强调了它们在决定细胞身份中的作用(图 1d 和补充图 2e)。对 MCF7(luminal)和四种 basal-like TN 细胞系的 CyTOF 分析验证了 GATA3 和 K5 表达模式能够区分 luminal 和 basal-like 身份。此外,SHAP 分析30,31 将这两个标志物确定为肿瘤类型的最强区分因子(图 1e,f)。使用多个细胞身份标志物,我们推导出一个 PermCell luminal 特征(方法),其准确区分了这些细胞系的身份(图 1g)。
文章标题:乳腺肿瘤中的表观遗传异质性为诊断和预后提供信息
a,实验示意图。肿瘤经解离、去除 CD45+ 免疫细胞、用金属偶联抗体染色,并通过 CyTOF 分析(补充表 1)。Ac,乙酰化;Me,甲基化;Ub,泛素化。b,CyTOF 数据集的 UMAP(1,157,765 个细胞,n = 12 个肿瘤,每个肿瘤平均 96,480 个细胞;补充表 3)。图中每个样本展示约 1,000 个细胞(每个肿瘤一个重复),按样本(左)或标志物强度(右)着色。虚线轮廓表示 HR+、TN 和基质细胞区域。c,d,基质、TN 肿瘤(n = 1)和管腔型肿瘤(n = 11)中平均标志物水平的热图;行经过标准化和聚类。e,乳腺癌细胞系的 UMAP。图中每个细胞系展示 5,000 个细胞,按细胞系(左)或标志物强度(右)着色。f,XGBoost 分类器使用所有细胞身份标志物区分管腔型和基底样细胞系(补充表 1)。SHAP 分数表示特征重要性。g,与 e 相同的 UMAP,按由所示标志物(底部)得出的管腔型特征评分着色。星号表示细胞系面板中缺失的标志物。h,来自肿瘤 5 的细胞(代表 n = 11)在 DBSCAN 聚类和噪声(未分类细胞)去除后的 UMAP,按亚群、标志物强度和管腔型特征着色。i,h 中各亚群平均标志物水平的热图,行标准化为 z 分数。行和列经过聚类。j,两个管腔型 PDX 模型的 UMAP,着色方式同 h。对于 PDX-1,等量采样了六个肿瘤以匹配 PDX-2 的细胞数。k,l,CyTOF 平均 Ki-67 水平与 IHC 检测的 Ki-67+ 细胞百分比(k)或表观遗传特征推断的周期细胞百分比(l,n = 11)的关系。数据显示线性拟合(线)、95% 置信区间(CI,灰色)、Pearson's r 和双侧 P 值。肿瘤 20 的 CyTOF Ki-67 水平为离群值,已被排除。m,n,MCF7 亲本细胞(m)和单细胞衍生克隆(n,克隆 5)的 UMAP 和 DBSCAN 聚类,仅使用表观遗传特征,着色方式同 h。结果在七次独立的 MCF7 CyTOF 实验和三个独立衍生的克隆中重现(扩展数据图 2)。a 中的示意图在 BioRender 中创建;Furth, N. https://biorender.com/twf1psb (2026)。
我们接下来分别考察每个管腔型乳腺肿瘤癌细胞的瘤内异质性,重点关注癌细胞。基于所有特征的 UMAP 聚类和基于密度的噪声应用空间聚类(DBSCAN)在每个肿瘤中揭示了三个亚群,我们将其命名为周期型、管腔型和基底样(图 1h,i 和扩展数据图 1a,b)。这些亚群在两个不同的管腔型患者来源异种移植(PDX)模型中也得到保留。这一发现验证了所观察到的异质性是管腔型乳腺肿瘤的固有特征,并排除了正常细胞污染(图 1j 和扩展数据图 1c)。MCF7 细胞显示出类似的管腔型和基底样异质性,尽管大多数细胞处于周期中,这符合细胞系的预期(扩展数据图 1d)。在肿瘤中,只有管腔型亚群发生周期并表达高水平 Ki-67,这一结果与先前的免疫组织化学(IHC)和 scRNA-seq 研究一致14,32。CyTOF Ki-67 水平与病理学估计相关(图 1k)。周期细胞在原始测量和以核心组蛋白标准化后均显示多种染色质修饰的高水平(图 1i、扩展数据图 1a–c 和补充图 3)。我们通过重复两个肿瘤(14 和 18)的 CyTOF 分析,并加入已确定的细胞周期标志物磷酸化 Rb(pRb),验证了这一结果。pRb 阳性细胞显示核心组蛋白增加,符合周期细胞的预期,并且组蛋白 PTM 增加更大(补充图 3)。相应地,表观遗传推断的周期分数与 Ki-67 水平强烈相关(图 1l)。
大多数癌细胞强表达 GATA3,并在腔面型特征上得分很高,这与临床分类一致(Fig. 1h、Extended Data Fig. 1a,b 和 Supplementary Fig. 4a)。此外,在每个肿瘤、PDX 样本和 MCF7 细胞中,我们鉴定出一个少量反复出现的亚群,其获得了基底样身份,K5 高表达且腔面型特征降低(Fig. 1h–j、Extended Data Fig. 1 和 Supplementary Fig. 4a)。这种表型多样性与此前对人类和小鼠乳腺肿瘤的单细胞研究一致14,21,33,34。值得注意的是,腔面型细胞和基底样细胞也具有不同的组蛋白 PTM 特征(Fig. 1h–j 和 Extended Data Fig. 1)。因此,仅基于组蛋白修饰的 UMAP 图揭示了这些亚群的分离,验证了这种表型多样性的表观遗传基础(Supplementary Fig. 4b)。在 MCF7 细胞中,表观遗传 UMAP 和聚类同样鉴定出几个簇,包括一个 K5hi 基底样群体(Fig. 1m)。这些腔面型信号降低的基底样细胞在 UMAP 空间中更接近 TN 细胞系,这为其基底样身份提供了进一步支持(Supplementary Fig. 4c)。独立的 CyTOF 实验、额外的 MCF7 亲本细胞培养以及源自独立单细胞克隆的群体揭示了相似的亚群模式,这一结果反对这些效应具有遗传基础(Fig. 1n 和 Extended Data Fig. 2a–c)。此外,源自同一供体并在不同小鼠中独立生长的各个 PDX 肿瘤显示出相似的亚群比例,这为细胞状态之间的动态且可塑的关系提供了支持(Extended Data Fig. 2d)。总体而言,我们的数据揭示了腔面型肿瘤中固有的瘤内异质性,不同亚群之间存在表观遗传变异性。
肿瘤中表观遗传上不同的基底样细胞
我们进一步探索了增殖中、腔面型和基底样亚群的特征。无监督聚类将不同患者中对应的亚群归为一组,这证实了它们的稳健性和相似性(Fig. 2a)。在各肿瘤中,腔面型细胞表达雌激素受体(ER)、GATA3 以及细胞角蛋白-8 和细胞角蛋白-18(K8/18;分别又称 KRT8 和 KRT18),而基底样细胞下调这些腔面型标志物并高表达 K5(Fig. 2b)。由于这些亚群还表现出不同且保守的染色质模式,我们应用机器学习算法来预测瘤内分类35。在每个肿瘤中,一个在随机子集上训练的模型以 94% 的准确率预测了剩余细胞,这证实了亚群之间的稳健差异(Fig. 2c 和 Extended Data Fig. 3a)。它还将 78% 的未聚类“噪声”细胞以 >95% 的置信度进行分配,产生的分类与原始聚类和 UMAP 位置一致(Extended Data Fig. 3b)。SHAP 分析鉴定了驱动每个亚群的特征。具体而言,组蛋白 PTM,尤其是四个乙酰化标记,是增殖细胞的主要预测因素,尽管单个标记与基底样细胞存在重叠(Extended Data Fig. 3c,d)。Polycomb 相关的 H3K27me3 和 H2Aub 也对这些特征有贡献,这一发现与先前在乳腺癌中观察到的 Polycomb 失调和促增殖活性一致36,37,38。
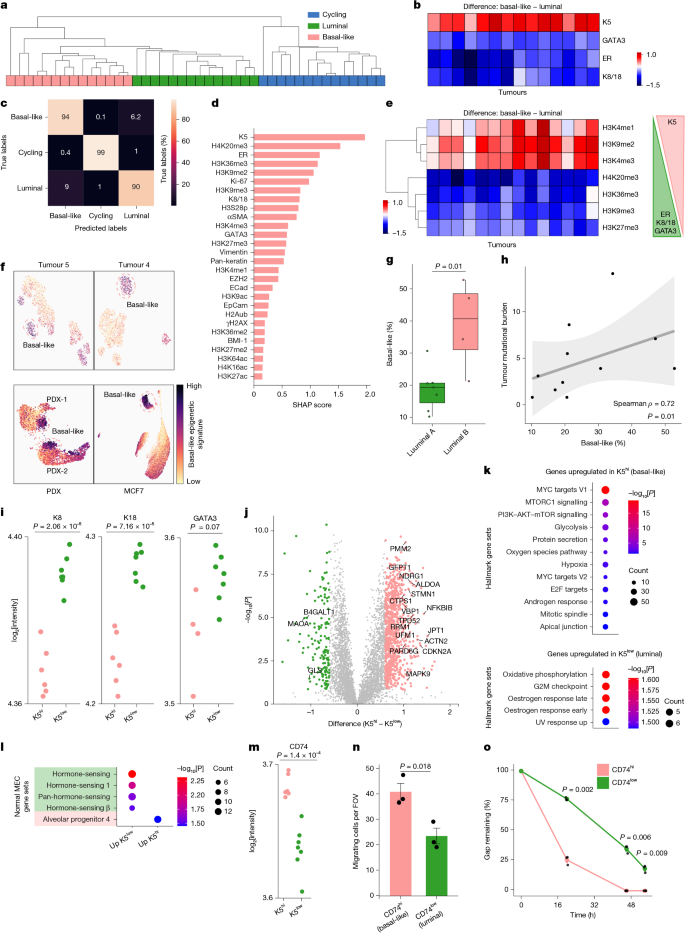
a,来自每个 HR+ 肿瘤的三个亚群(n = 14,包括 3 个锚定重复;补充表 3)按 CyTOF 特征聚类。树状图显示跨患者重复出现的模式。b,基底样与管腔样亚群之间细胞身份标志物平均差异的热图(n = 14,如 a)。c,XGBoost 对亚群预测的混淆矩阵(HR+ 肿瘤,n = 14)。行按真实类别归一化,准确率为 94%。d,特征对基底样与管腔样分类贡献的 SHAP 分数,按降序排列。XGBoost 准确率 = 92%。e,如 b 所示的热图,显示 d 中列出的最具判别力的组蛋白 PTM;行已聚类。f,肿瘤 4 和 5、管腔样 PDX 模型(n = 2)和 MCF7 细胞的 UMAP 图,按基底样表观遗传特征着色(扩展数据图 4a)。虚线表示基底样群体。g,按管腔 A(n = 7)或管腔 B(n = 4)亚型分层的 HR+ 肿瘤中基底样细胞百分比。箱体:中位数和 25–75 百分位数;须线表示 1.5× 四分位距(IQR);点为单个肿瘤。双侧 Wilcoxon 秩和检验。h,基底样细胞百分比与肿瘤突变负荷的关系(n = 11)。数据显示线性拟合(线)、95% CI(灰色阴影)、Spearman’s ρ 和双侧 P 值。i,肿瘤 19 中 K5hi 和 K5low 细胞的管腔身份标志物水平。点表示分选后的 200 个细胞的技术重复中的蛋白质强度(log2)(每个群体 6–7 个孔)。双侧 Welch t 检验,未进行多重比较校正。j,如 i 所示的 K5hi 和 K5low 细胞之间
文章标题:乳腺肿瘤中的表观遗传异质性为诊断和预后提供信息
与 CyTOF 结果一致,表观遗传学定义的基底样细胞比例较高的肿瘤中,经 IHC 测定的 ER 阳性和孕激素受体(PR)阳性细胞较少(扩展数据图 5a,b 和补充表 2)。基底样细胞在预后较差的管腔型 B 肿瘤中也比管腔型 A 肿瘤更丰富。这一结果与显示这些肿瘤具有与基底样亚型共享特征的研究一致3,41,42,43(图 2g)。尽管整个队列中肿瘤突变负荷较低,但其与 CyTOF 定义的基底样比例呈正相关,这与通常与 TNBC 相关的更高基因组不稳定性相平行44,45(图 2h 和补充表 2)。TP53 突变肿瘤同样含有更多基底样细胞(扩展数据图 5c),这一发现让人联想到胶质母细胞瘤的单细胞研究,后者显示基因突变可能影响细胞状态之间的平衡46。总体而言,这些病理学和分子特征之间的关联将表观遗传学上不同的基底样亚群与更具侵袭性的疾病表型联系起来。
为了在功能上表征这些细胞,我们对肿瘤 19 的细胞进行了 FACS 分选,随后进行低输入质谱分析。通过泛细胞角蛋白染色排除基质后,根据 K5 水平分选细胞,以相对于管腔型群体富集基底样细胞。K5low 细胞高表达管腔型标志物和与雌激素信号相关的蛋白,而基底样 K5hi 细胞表达参与致癌通路的蛋白,如 MYC–mTOR 信号(图 2i–k)。此外,这些亚群之间多种染色质调节因子存在差异,包括 H3K4me1 甲基转移酶 SETD7 和组蛋白去甲基化酶 KDM4A,这与 CyTOF 观察到的组蛋白 PTM 差异一致47,48(扩展数据图 5d)。在 K5hi 细胞中富集的 KDM4A 靶向 H3K9me3 和 H3K36me3,这可能解释其在基底样群体中水平降低以及 H3K9me2 积累49。与正常乳腺单细胞图谱50 的比较揭示了 K5low 细胞中的激素感应程序和 K5hi 细胞中的腺泡祖细胞特征(图 2l),这一结果分别与它们在管腔型和基底样 TN 肿瘤中的富集一致50。
为了从机制上理解这些发现,我们使用 K5 特异性抗体和 GATA3 特异性抗体分选 MCF7 细胞并进行转录组分析,将基底样细胞(K5hiGATA3low)与 bulk MCF7 或极端管腔型细胞(K5lowGATA3hi;扩展数据图 5e,f)进行比较。值得注意的是,基底样细胞富集上皮-间质转化(EMT)基因(P < 0.05;扩展数据图 5f)。随后我们聚焦差异表达的细胞表面标志物以实现活细胞分选,结果显示,在 MCF7 和肿瘤 19 的蛋白质组分析中,CD74 在基底样细胞中均显著上调(图 2m 和扩展数据图 5g)。活分选的 CD74hi 细胞在迁移和伤口愈合实验中表现出增强的迁移能力,这进一步支持了基底样细胞更具侵袭性的表型(图 2n,o 和扩展数据图 5h)。总之,这些单细胞和 bulk 蛋白质组学及功能实验在管腔型肿瘤中识别出表观遗传学上不同的 K5hi 基底样细胞,其与侵袭性特征相关,如管腔型信号减弱、致癌信号升高和迁移潜能增加。
DNA 甲基化揭示肿瘤内异质性
乳腺肿瘤中的表观遗传异质性为诊断和预后提供信息
基底样亚群独特的染色质和表型状态促使我们探究瘤内表观遗传异质性是否也在 DNA 甲基化模式中显现。因此,我们对队列中的三个管腔型肿瘤进行了深度全基因组亚硫酸氢盐测序(WGBS)。如 The Cancer Genome Atlas (TCGA)51 所示,DNA 甲基化模式能准确捕捉乳腺癌亚型。我们随后将 TCGA 和我们的 WGBS 数据联合解卷积为功能原型(V1–V3),每个肿瘤都定位在解卷积空间中。将数据按三种原型分层后,显示出基底(TN)肿瘤与管腔型(HR+)肿瘤的
文章标题:乳腺肿瘤中的表观遗传异质性为诊断和预后提供信息
正文: a,TCGA BRCA DNA甲基化数据集(n = 782)51 解卷积为四种原型,每个肿瘤原型组成的UMAP按PAM50亚型(左)或原型贡献(右)着色。本研究中分析的三个肿瘤(18、19和23)已标出,它们主要在V1原型上有所差异。b,根据DNA甲基化原型与匹配的TCGA BRCA表达数据之间的相关性对基因进行排序,随后针对MSigDB hallmark集合进行基因集富集分析(GSEA)。V1在EMT轴上与管腔原型(V2和V4)不同。显示了代表性的归一化富集分数(NES)。黑色轮廓表示Benjamini-Hochberg校正后P < 0.05。所有条目见补充图5b。c,上,CyTOF测量的UMAP(肿瘤18和19,排除基质),按波形蛋白表达着色,波形蛋白阳性细胞高亮显示。下,每个肿瘤的波形蛋白阳性比例。d,上,对管腔肿瘤(n = 9)13 进行scATAC–seq,分析WIP分数58和基因活性。矩阵显示了每个肿瘤中WIP分数与UCell分数之间的Pearson相关性。下,来自患者10-R的癌细胞的UMAP,按WIP分数或基底–管腔指数(z评分管腔基因集与基底基因集之间的差异59;较高值表示更基底样表达)着色。e,H3K4me1 snCUT&Tag数据的UMAP(去除基质)。细胞由反映每个基因H3K4me1相关调控活性的scTransform归一化基因活性矩阵表示,读数计数已排除。Louvain聚类和每个肿瘤的细胞数已标出。f,对e中每个簇的差异H3K4me1标记基因(双侧Wilcoxon符号秩检验,log2倍数变化 > 1,校正P < 0.01)针对MSigDB Hallmark和乳腺相关集合进行富集分析(补充表4)。显示的是在三个肿瘤中至少两个的簇2中H3K4me1增加的基因中富集的条目(单侧超几何检验,FDR < 0.05)。圆圈大小表示重叠基因;颜色表示–log10[FDR]。g,h,H3K4me1(g)和H3K4me3(h)snCUT&Tag数据的UMAP,按e和f中的方法分析,并按包含对相应富集有贡献的基因的签名的UCell分数着色(高斯平滑)。关于H3K4me3富集,见扩展数据图8h。i,每个肿瘤和组蛋白标记的snCUT&Tag读数与指示基因签名的UCell分数之间的Pearson相关性。d、f、i中显示的基因签名来源于先前发表的研究(参考文献13,59,85,86,87,88)。
为了直接将CyTOF定义的亚群与DNA甲基化模式联系起来,我们从肿瘤5和肿瘤23中分选了K5hi和K5low细胞,随后进行酶介导的甲基化测序(EM-seq)。差异甲基化启动子的功能富集显示,K5hi细胞中雌激素反应程序发生高甲基化,而与侵袭性和致癌特征相关的基因,包括KRAS信号传导和间充质或基底状态转变,则发生低甲基化(扩展数据图6c,d)。接下来,我们利用在两个肿瘤中一致差异甲基化的CGI,推导了一个CpG岛(CGI)甲基化签名来区分这两种状态。在TCGA乳腺癌数据中,该签名在基底样肿瘤中得分更高,表明K5hi甲基化程序类似于基底样肿瘤(扩展数据图6e)。在三种原型和四种原型模型中,K5hi样本对基底相关和EMT相关原型的贡献也均高于K5low样本(扩展数据图6f,g)。因此,CyTOF定义的基底样群体表现出基底样和EMT相关的甲基化程序,这揭示了肿瘤内表观遗传异质性的另一层面。
基底样细胞具有嘈杂的表观遗传景观
在鉴定出与肿瘤细胞状态相关的不同 DNA 甲基化程序后,我们接下来通过对 100-bp 基因组 bin 中的 read 级甲基化模式进行聚类,并计算经验熵作为细胞类型异质性的估计55,来评估细胞间变异性。高熵 bin 附近的基因与分化差、肿瘤侵袭性以及与管腔型身份相比的基底型身份相关的功能条目相关(Supplementary Fig. 6a)。这一结果提示,经验熵通过捕获多样的 DNA 甲基化状态,可作为细胞间异质性的替代指标,并揭示亚群之间的功能差异。我们接下来计算了每个 CGI 的平均熵(Extended Data Fig. 7a)。正如预期,大多数 CGI 在所有细胞中均未甲基化56,因此熵为零。可变 CGI(熵 > 0)在功能上富集
在每个肿瘤中,恶性细胞聚类为不同的由 H3K4me1 定义或 H3K4me3 定义的状态(图3e和扩展数据图8e,f)。对聚类
乳腺肿瘤中的表观遗传异质性为诊断和预后提供信息
抑制性标记 H3K9me2 也被鉴定为表观遗传基底样特征的重要贡献因素(图 2d,e)。因此,我们对肿瘤 8 进行了 H3K9me2 snCUT&Tag,该肿瘤也进行了 H3K4me1 分析。鉴于 H3K9me2 占据大的基因组区域,其分布与基因活动的关系不易解释,尤其是在低覆盖度的单细胞数据集中。因此,我们利用 H3K4me1 数据并训练了一个分类器,假设增强子相关的 H3K4me1 与抑制性 H3K9me2 染色质62,63 具有相反的基因组分布,以识别恶性细胞与基质细胞(扩展数据图 9f)。我们接下来根据 H3K9me2 基因组分布对肿瘤细胞进行聚类,并应用相同的基于 H3K4me1 的推断框架。该方法预测聚类 4 中基底样细胞强烈富集,这与雌激素相关基因上 H3K9me2 沉积升高一致(扩展数据图 9g–i)。该聚类还显示每个细胞核的 H3K9me2 读数计数最高,这支持其对应于 CyTOF 鉴定的 H3K9me2hi 基底样细胞(扩展数据图 9j)。总体而言,这些分析突显了一个表观遗传上独特的基底样群体,其在与 luminal-basal 身份和 EMT 相关的基因上具有全局增加且重新分布的活性和抑制性组蛋白修饰。
血液中的单分子组蛋白 PTM 分析
我们的多模态分析将染色质景观与肿瘤内细胞状态多样性联系起来。我们接下来旨在将组织层面的发现转化为基于我们单分子 EPINUC 技术的液体活检检测,该技术可分析血浆分离核小体的表观遗传
a,实验示意图。循环核小体和蛋白被捕获在显微镜盖玻片上,这有助于从<1 ml血浆中灵敏定量多种组蛋白PTMs和蛋白生物标志物28。荧光团偶联抗体能够同时测量多种标记,包括其在单个核小体上的比值和共出现情况。b,健康女性(n = 30)以及T1期(n = 42)或T2–T4期luminal乳腺癌患者(n = 30;补充表5和6)中选定的EPINUC特征。箱体显示中位数和25–75百分位数,须线延伸至1.5×IQR内最极端值。圆圈代表单个样本。P值通过双侧两样本Wilcoxon检验计算,并采用Bonferroni校正多重比较。NS,不显著。c,个体PPS分析区分健康个体与所有luminal乳腺癌患者或T1期乳腺癌患者。颜色表示PPS值,反映每个单独特征的预测能力。EPINUC特征注释见补充表5。d,使用c中所示所有有贡献特征(PPS > 0)对健康(n = 30)和luminal乳腺癌(n = 77)样本进行PCA。样本按组着色;椭圆表示组重心的95% CI。e,使用所有测量特征及其组合的XGBoost分类器区分健康个体与所有luminal乳腺癌患者或T1期乳腺癌患者。SHAP分数表示每个特征对分类器性能的贡献。f,g,随机森林模型的受试者工作特征(ROC)曲线,区分健康个体(n = 30)与所有luminal乳腺癌患者(n = 77;f)、T1期luminal乳腺癌(n = 42;g)或T2–T4期luminal乳腺癌(n = 30;g)。模型使用乘法特征组合,随后进行Boruta特征选择。AUC分别为0.95(95% CI,0.91–0.98)、0.95(95% CI,0.90–0.99)和0.96(95% CI,0.91–1.00);阴影区域表示95% CI。h,多机构队列(188个样本)25%测试集的模型预测混淆矩阵,比较健康个体(n = 13)与luminal乳腺癌患者(n = 34)样本,特异性设为0.9。行已归一化,以预测值占每个真实组样本的百分比显示。a中的示意图由BioRender创建;Furth, N. https://biorender.com/qxlshkj (2026)。
L1CAM和MST1在乳腺癌患者血浆中也升高,这一结果与ER+肿瘤69中高MST1与不良预后相关一致(图4b和补充图8d)。多个参数在健康个体与诊断为早期(T1)低负荷肿瘤的患者之间存在差异,这证明了该方法的早期检测灵敏度(图4b)。预测能力分数(PPS)揭示了新测量的H4 PTMs的贡献,这些PTMs基于CyTOF分析选择,说明了匹配组织–血浆分析的价值(图4c)。预测特征的主成分分析(PCA)将健康个体与乳腺癌患者区分开,突出了EPINUC捕获这些组之间差异的能力(图4d)。
接下来,我们应用基于机器学习的分类器,从 EPINUC 数据中诊断 luminal 型乳腺癌。对在全部患者或仅 T1 期病例上训练的 XGBoost 模型进行 SHAP 分析,识别出多个组蛋白 PTM 和蛋白质生物标志物具有信息量(图 4e)。值得注意的是,两个模型都强调了组合特征,特别是 H4K16ac 与 H4K20me3 的共现,从而凸显了 EPINUC 量化此类组合的能力。具体而言,H4K16ac 激活转座元件70 的转录,而转座元件位于 H4K20me3 异染色质71 中,并且由于转座元件在癌症中常上调,H4K16ac 和 H4K20me3 升高可能是癌症相关现象。最后,我们应用多个分类器评估扩展后的 EPINUC panel 在区分健康个体与癌症患者方面的诊断贡献。使用原始 20 项 EPINUC 参数28 产生的曲线下面积(AUC)为 0.85(补充图 9a),而扩展后的 29 参数 panel 达到 0.95,包括在早期 T1 期癌症患者中(图 4f,g)。与乳腺 X 线摄影不同——其敏感性随致密乳腺组织而下降72,73——EPINUC 的特征和性能不受不同 BI-RADS 乳腺密度评分的影响,包括异质性和极度致密乳腺评分的患者(补充图 9b,c)。为评估基于 EPINUC 的分类器的稳健性,我们将原始队列(MAYO-1;图 4f)训练的模型应用于 6–12 个月后采集、单独处理的一组独立血浆样本(MAYO-2)。经批次校正(方法)后,预训练模型准确区分健康与 luminal 型乳腺癌,AUC 达 0.98,分类准确性高(扩展数据图 10a,b)。
为推广我们的发现,我们分析了两个独立医疗中心 luminal 型乳腺癌患者的治疗前血浆(补充表 6)。EPINUC 在两个队列中均以高准确率区分患者与健康对照,并在 TNBC 中显示出相当的敏感性和特异性(扩展数据图 10c–e)。汇总各中心所有 luminal 样本(n = 188),在 75% 数据上训练的模型达到 AUC 0.96,并稳健分类剩余 25%,尽管来源和批次混合,这一情景反映了真实世界临床环境(图 4h、扩展数据图 10f 和补充图 10)。luminal A 和 luminal B 肿瘤的性能相似(扩展数据图 10g)。尽管为回顾性研究,这些结果支持使用高分辨率、多参数血浆表观遗传分析进行癌症诊断。
文章标题:乳腺肿瘤中的表观遗传异质性为诊断和预后提供信息
MAYO-1 队列由具有至少 5 年临床随访的术前样本组成,这使得能够按 5 年复发情况进行分层(图 5a)。早在诊断时,几个 EPINUC 特征在无病患者与复发患者之间就已存在差异。与侵袭性基底样亚群相关的 H3K4 单甲基化和三甲基化,在发生复发性疾病的患者血浆中升高(图 5b)。H3K27me3 和 H3K9ac 也升高,这可能反映了其他侵袭性肿瘤或微环境状态,例如组蛋白乙酰化特别高的增殖细胞(扩展数据图 1b)。同时修饰有 H3K9ac 和 H3K4me1 的核小体在复发组中更高,这一结果进一步证明了 EPINUC 在捕获这些组合方面的能力(图 5b)。ER 或 PR 状态与复发无关(Fisher 精确检验,P > 0.05),并且该表观遗传特征在具有以下特征的肿瘤中持续存在:ER 和 PR 水平相当;仅为 luminal A 型肿瘤;低负荷 T1–T2 或 1–2 级疾病;以及无淋巴血管侵犯(LVI)的肿瘤。没有任何 EPINUC 特征与组织学分级显著相关,这表明存在超出已知临床参数的预后信息(扩展数据图 11a–f)。
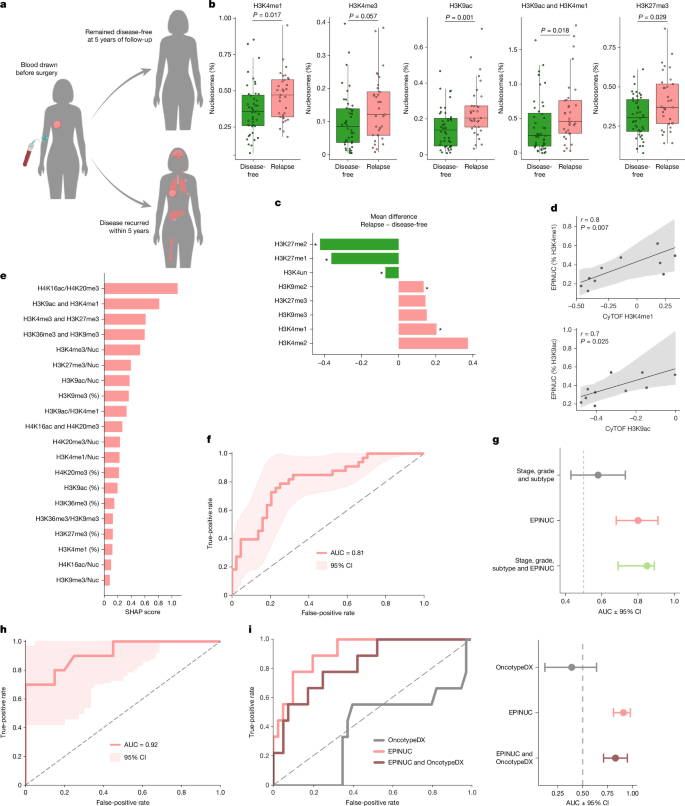
a,实验示意图。血液样本在手术前从 luminal 乳腺癌患者中采集,临床随访至少 5 年。样本根据疾病结局进行分层:无病(n = 44)或复发(n = 33)。b,a 中定义的两个结局组中选定的 EPINUC 特征。箱体显示中位数和第 25–75 百分位数,须线延伸至 1.5× IQR 内的最极端值。圆圈代表单个样本。双侧 Wilcoxon 检验。c,按结局分层的 luminal 肿瘤的组蛋白 PTM 聚焦质谱分析(无病,n = 17;复发,n = 4)。显示了两组之间与 CyTOF 或 EPINUC 面板相关的修饰平均水平的差异。双侧 Welch 检验;*P < 0.05。精确 P 值见源数据。d,散点图比较通过 CyTOF(肿瘤细胞)测量的平均组蛋白 PTM 水平与匹配血浆中的 EPINUC 测量值(n = 10)。标明了 Spearman 相关系数和双侧 P 值。线条显示 Theil–Sen 拟合,阴影表示 95% CI。e,XGBoost 分类器使用所有 EPINUC 特征区分无病组(n = 44)和复发组(n = 33)。SHAP 分数表示每个表观遗传特征对分类器性能的贡献,按重要性排序。f–i,luminal 乳腺癌患者的复发预测。f,MAYO-1 队列的 ROC 曲线(无病,n = 44;复发,n = 33;AUC = 0.81,95% CI 0.71–0.90)。g,具有完整临床注释的患者(无病,n = 39;复发,n = 28)的 AUC 估计值,使用临床预后变量(年龄、肿瘤分期、淋巴结分期、分级和 luminal 亚型)、EPINUC 特征或两者。h,独立 MAYO-2 队列的 ROC 曲线(无病,n = 20;复发,n = 10;AUC = 0.92,95% CI 0.79–1.00)。i,在具有可用 OncotypeDX 测量的患者中,使用 OncotypeDX 评分、EPINUC 特征或两者,比较无病(n = 40)和复发(n = 9)的 ROC 曲线和 AUC 估计值。对于 ROC 曲线,阴影表示 95% CI;对于 AUC 估计值,点和线分别表示 AUC 和 95% CI。a 中的示意图在 BioRender 中创建;Furth, N. https://biorender.com/xg9gtix (2026)。
为了进一步探究肿瘤与血浆表观遗传模式之间的关联,我们分析了一个小型 luminal 肿瘤队列,该队列具有组蛋白 PTM 质谱数据39,并且同样按疾病复发进行了分层39。在我们的 CyTOF 数据中标记基底样细胞的 H3K4me1 和 H3K9me2,在发生复发的患者中显著更高,这一结果进一步将该亚群与侵袭性肿瘤特征联系起来(Fig. 2e 和 5c)。最后,对于 Fig. 1–3 中分析的患者,我们获得了术前血液样本,这使得能够直接将肿瘤(CyTOF)和血液(EPINUC)的表观遗传模式进行关联。大多数组蛋白 PTM 呈正相关,其中与复发相关的 H3K4me1 和 H3K9ac 标记显示出最强的正相关,这一结果为它们的预后价值提供了进一步支持(Fig. 5d 和 Extended Data Fig. 11h)。尽管需要更大规模的验证,这些数据表明循环核小体既报告肿瘤的存在,也报告其表观遗传状态,这一发现对临床管理可能具有重要意义。
为了检验 EPINUC 预测疾病复发的预后能力,我们在多参数数据上应用了机器学习分类器。最佳模型达到了 0.81 的 AUC,并且优于基于经典预后参数(如分期、分级和亚型)的预测(Fig. 5e–g 和 Extended Data Fig. 11i)。为了评估可重复性并对已建立的检测进行基准测试,MAYO-2 聚焦于有可用 OncotypeDX 评分74 的样本。尽管规模较小,EPINUC 仍以 0.92 的 AUC 预测复发(Fig. 5h)。在两个队列中具有 OncotypeDX 数据的患者中,无病组和复发组之间的评分没有差异,而 EPINUC 保留了区分能力(Fig. 5i、Extended Data Fig. 11j 和 Supplementary Fig. 11)。联合检测并未提高性能,这表明 OncotypeDX 在此背景下附加价值有限。总体而言,数据表明肿瘤细胞亚群(如基底样细胞)的表观遗传特征可在血液中被捕获,并提供超出静态组织预后窗口的疾病生物学见解。在等待更大规模前瞻性验证之前,这些发现支持使用 EPINUC 进行早期诊断和复发风险分层。
讨论
单细胞研究已揭示癌症中具有临床相关性的表型多样性,但推动这种异质性的表观遗传机制仍知之甚少75,76。我们对 luminal 乳腺肿瘤的分析揭示了与先前转录组学和蛋白质组学方法一致的肿瘤细胞多样性14,21,33,34,54。定量质谱还显示乳腺癌亚型之间整体组蛋白修饰水平存在差异,这支持了染色质调控细胞身份的观点39,77,78。H3K4 去甲基化改变可驱动 luminal 身份丧失40,这表明 ER 信号的变化,即使没有 ESR1 突变,也可能促进 luminal 向 basal 的可塑性。在这里,我们对 luminal 乳腺肿瘤中的组蛋白 PTM 进行了单细胞分析。通过在单细胞分辨率下测量多种整体染色质修饰,我们在不同肿瘤中鉴定出 K5hi 基底样细胞的复发性表观遗传特征,并通过 H3K4 甲基化的单细胞基因组分析在不同模态上得到了支持。
在单细胞来源的 MCF7 克隆和独立培养的 PDX 肿瘤中重建完整异质性谱,支持表观遗传驱动的、可相互转换的状态,而非遗传上不同的克隆。亚群频率在患者间存在差异,并可能受偏向状态获得的突变影响,正如胶质母细胞瘤46中所报道。这种可塑性可能使适应治疗压力成为可能,进而促进耐药和进展。因此,蛋白质组学肿瘤内异质性随肿瘤分级增加,且独立于基因组异质性,从而提示表观遗传机制7。表观遗传疗法能否限制可塑性和状态转换仍有待检验。
乳腺癌预后在很大程度上取决于早期发现,但准确筛查同时尽量减少假阳性仍具挑战性79,80,81,82。在临床进展前检测分子变化可指导治疗调整并最大化一线获益83。肿瘤水平的组蛋白 PTM 特征可区分管腔型乳腺癌细胞状态,而治疗前血浆样本的 EPINUC 分析为结局预测提供了概念验证。值得注意的是,H3K4 甲基化标记在基底样肿瘤细胞和复发疾病患者血浆中均升高,这提示该亚群与疾病结局之间存在联系。
与解析肿瘤细胞群体的 CyTOF 不同,血浆测量整合了来自健康组织损伤、肿瘤微环境以及局部和全身免疫应答的信号29,84。尽管如此,肿瘤和血液中患者匹配的组蛋白 PTM 分析显示,大多数标记呈正相关,其中复发相关标记 H3K4me1 和 H3K9ac 的相关性最高,这为其预后价值提供了支持。总体而言,我们的组织和血浆染色质数据集揭示了乳腺癌中表观遗传驱动的肿瘤内异质性,并支持将 EPINUC 用作乳腺癌诊断和预后的潜在方法。
方法
人类参与者
乳腺癌组织样本及匹配血液样本的采集和分析获以色列卫生部伦理委员会批准(赫尔辛基申请 KMC-0028-22),随后获 Weizmann 机构审查委员会(IRB,2314-3)批准。
用于基于质谱的组蛋白 PTM 分析的乳腺癌样本包括 21 个肿瘤,取自 European Institute of Oncology 接受手术的患者,属于该研究所伦理委员会批准的研究(研究 UID 2550)的一部分。
管腔型乳腺癌患者的血浆样本和数据来自 Mayo Clinic(IRB 批准号 23-011311)。在 Sheba Medical Center 接受治疗的乳腺癌患者血浆样本采集获机构审查委员会批准(IRB 批准 7509-09)。健康个体的血浆样本来自 Weizmann Institute of Science(IRB 批准号 1850-1)。
所有研究均按照相关指南和法规进行,并获得所有参与者的知情同意。本研究未报告可直接识别参与者身份的信息。参与者信息详见补充表 2 和 6。未使用统计方法预先确定样本量。在人样本的采集、处理或分析中未进行随机化或盲法。
PDX 模型
所有动物研究均获 Weizmann Institute 的机构动物护理和使用委员会(IACUC)批准,并按照以色列法律进行。小鼠饲养和处理于无病原体、温度控制(22 °C ± 1 °C)设施中,采用 12 小时明暗循环。动物喂食常规饲料(2018 Teklad Global 18% protein rodent diet),并可自由获取食物和水。
TM00112(PDX-1)和 TM00386(PDX-2)模型购自 Jackson Laboratory,并植入 10 周龄雌性 NSG 小鼠(Jackson Laboratory)。简言之,安乐死后,从供体小鼠取出肿瘤并切成小碎片。在每只小鼠下背部制作一个小囊袋,并将一块碎片插入囊袋中。伤口使用外科夹闭合。术后 4–5 天移除夹子。每周用卡尺测量肿瘤两次,每周测量体重一次。IACUC 批准的最大肿瘤尺寸为 1,000 mm3。当肿瘤达到约 500 mm3 时,对小鼠实施安乐死,并收集肿瘤用于分析。未使用统计方法预先确定样本量。动物未随机分组,实验期间研究者未设盲。
细胞培养
MCF7 和 MDA-MB-468 细胞系获自 Weizmann Institute of Science 的组织培养细胞库。HCC70、HCC1937 和 SUM149 细胞系由 I. Ben-Porath 提供。HCC70 和 HCC1937 细胞培养于添加 10% FBS、1% L-谷氨酰胺和 1% 青霉素–链霉素的 RPMI-1640 中。SUM149 细胞维持于添加 5% FBS、1 µg ml–1 氢化可的松(Sigma-Aldrich,H0888)、0.5 µg ml–1 胰岛素(Sigma-Aldrich,I5500)、L-谷氨酰胺和青霉素–链霉素的 Ham’s F-12 培养基中。MDA-MB-468 和 MCF7 细胞培养于 DMEM(Thermo Fisher Scientific,41965-039)中,添加 10% FBS(Sigma-Aldrich,F7524)、1% L-谷氨酰胺(Sartorius,03-020-1B)和 1% 青霉素–链霉素(Corning,30-002-CI)。所有细胞均维持于 37 °C、含 5% CO2 的湿润气氛中。
单细胞来源的 MCF7 克隆及匹配的亲本 MCF7 细胞,或由 U. Ben-David89 提供,或在内部通过使用 Sony SH800S 细胞分选仪(Sony Biotechnology)将单细胞分选至 96 孔板并扩增约 4 个月后生成,之后用于实验。
细胞系未经过独立鉴定,但常规检测支原体污染,结果均为阴性。
用于不同应用的肿瘤样本选择
由于每个用于研究的肿瘤样本可获得的解离细胞数量有限,我们无法使用论文中描述的所有不同方法对相同样本进行图谱分析。对人肿瘤基于单细胞 CyTOF 的表观遗传分析是每种肿瘤的优先事项(肿瘤 23 除外,其用于 WGBS 且未通过 CyTOF 进行图谱分析)。对于肿瘤 18,由于肿瘤细胞可得性高,同时进行了 WGBS 和 snCUT&Tag。对于其余样本,我们没有足够的细胞来执行两种方法。值得注意的是,尽管附加分析并非在相同样本上进行,但每项分析均在三个独立肿瘤样本上进行,这确保了每种方法结论的可重复性。分析重点在于识别肿瘤中的常见模式,而非比较肿瘤与患者之间。
肿瘤样本的临床病理和分子数据
患者和肿瘤信息从病理报告中提取。为了量化 ER 阳性,取回在样本采集时同时制备用于 CyTOF 分析的福尔马林固定石蜡包埋(FFPE)肿瘤块,切片并通过 IHC 染色 ER。扫描玻片,并使用 QuPath 软件90分析包含 DAB 信号的数字图像。首先使用像素分类器分割组织区域,以识别包含组织的区域(平均通道 < 245,sigma = 2,分辨率 8.4 μm)。在这些区域中,使用监督像素分类器分割上皮和基质区室,最小对象大小为 1,000 µm2,最小孔洞大小为 5,000 µm2。分类器使用 QuPath 中实现的多层感知机(ANN_MLP)模型,基于 2.1 µm 分辨率的苏木精和 DAB 通道以及多尺度邻域特征(尺度 1、2、4、8 和 12),在多个玻片的代表性区域上进行训练。上皮区域中的细胞核使用 Cellpose-SAM91 分割。对每个细胞核,量化 DAB 强度的中位数。计算每个肿瘤样本的核 DAB 强度分布,并使用每样本阈值化来解释玻片间染色变异性。对每个肿瘤,计算核 DAB 强度中位数的核密度估计,限制在观察到的强度范围内。识别密度函数的局部极大值和极小值,并将分离 ER 阴性和 ER 阳性细胞核的阈值定义为两个最显著密度峰之间的最低局部极小值。使用此方法得出的肿瘤特异性阈值将细胞核分类为 ER 阳性或 ER 阴性,并计算每个样本的 ER 阳性细胞百分比。
肿瘤样本中的突变检测
使用 RecoverAll Total Nucleic Acid Isolation kit(Thermo Fisher Scientific)从 FFPE 块中提取 DNA,并储存在 −20 °C。FFPE 块由认证病理学家审查并标注肿瘤细胞丰富度,最低接受的肿瘤细胞丰富度阈值为 20%。使用 Qubit 3 荧光计和 dsDNA HS Assay kit(Thermo Fisher Scientific)量化 DNA 浓度。
使用 TruSight Oncology 500 (TSO500) assay(Illumina)按照制造商说明制备文库。简言之,每个样本的 100 ng DNA 使用 Covaris M220 超声仪(Covaris)剪切。基因组文库使用 Hamilton Microlab STAR 系统(Hamilton)制备,并在 Illumina NextSeq550 仪器上使用 High Output kit v.2.5(300 循环)测序。初步分析使用 DRAGEN TruSight Oncology 500 分析软件(v.2.6.2,Illumina)进行。
根据 AMP 指南将变异注释并分类为 IA、IB、IIC、IID、III 和 IV92 级。使用 Velsera Clinical Genomics Workspace (CGW) 排除分类为 IV 级、同义、非编码或没有已建立生物学影响的变异。剩余变异使用计算机预测工具(REVEL、CADD 和 SpliceAI)以及来自 Franklin (Genoox)、UCSC Genome Browser 和 Velsera CGW 的注释进行人工审查。仅当测序覆盖度超过 100× 且变异等位基因频率 >1% 时才报告变异。
针对新鲜分离的乳腺肿瘤、PDX 模型和乳腺癌细胞系的表观遗传学聚焦 CyTOF 分析
CyTOF 抗体组合
该抗体组合结合了乳腺组织相关的细胞身份标志物33,34、涵盖不同染色质状态的组蛋白 PTMs 以及染色质修饰因子 EZH2 和 BMI-1(补充表 1)。分析所用的染色质标记是基于高特异性和经过验证的抗体的可用性而选择的,核心组蛋白的定量用于信号归一化。
细胞解离和 CyTOF 染色
手术后,将一份肿瘤组织样本保存在 MACS Tissue storage solution(Miltenyi Biotec,130-100-008)中,并按照制造商方案使用 human Tumour Dissociation kit(Miltenyi Biotec,130-095-929)解离成单细胞。使用 Red Blood Cell Lysis solution(10x,Miltenyi Biotec,130-094-183)去除红细胞,并使用 human CD45 MicroBeads(Miltenyi Biotec,130-045-801)去除 CD45+ 细胞。随后用 PBS 洗涤细胞悬液,或进一步处理用于 CyTOF 分析,或在细胞数量合适时提取细胞核用于 snCUT&Tag 分析。对于细胞系,使用补充有 DNase I(Merck,4716728001)的 Accutase(Sigma-Aldrich,STC-07922)解离细胞。
对于 CyTOF 分析,细胞用 Maxpar CyTOF PBS(Standard BioTools)洗涤,并用 1.25 μM cisplatin(Standard BioTools)染色 1 min。用温热的 10% FBS–DMEM 中和 cisplatin。细胞用 Maxpar Cell Staining buffer(Standard BioTools)洗涤,并使用 TruStain FcX, Fc Receptor Blocking solution, human(422301,BioLegend)封闭,随后与细胞外抗体混合物(补充表 1)孵育 30 min。对于肿瘤样本,细胞用 PBS 洗涤,用 1.6% 多聚甲醛(PFA)–PBS 轻度固定 30 min,并在 10% DMSO–FBS 中冷冻。当细胞数量允许时,此步骤得到的冷冻细胞分装用于其他应用(基于流式细胞术的分选或 WGBS)。对于细胞系,样品直接进行细胞内标志物染色,不进行轻度固定和冷冻。
对于细胞内染色和 CyTOF 测量,肿瘤样本先解冻,所有样品用染色缓冲液洗涤,并按照制造商说明使用 Maxpar nuclear antigen staining buffer set(Standard BioTools)固定和透化。对于多重样本,使用 Cell-ID 20-Plex Pd Barcoding kit(Standard BioTools)进行条形码标记。简言之,每个样品重悬于 MaxPar Nuclear Antigen Staining Perm buffer(Standard BioTools)中,并与新鲜解冻的
总体而言,通过 CyTOF 分析了 17 个不同的肿瘤样本,其中 5 个样本分析了两次:或作为不同批次中的技术重复以提供锚定信息,或使用不同的抗体 panel 以分析额外的细胞周期标记(pRb)。共测量了 1,565,881 个活细胞(每个样本约 30,000–400,000 个细胞;Supplementary Table 3)。其余 CD45+ 细胞从分析中移除。对于 PDX 分析,移除 CD45+ 细胞,仅通过保留人 CD298+ 和小鼠 MHC class I 阴性细胞来分析人细胞。
批次校正
由于样本按批次测量,使用锚定样本(在不同批次中测量的相同肿瘤样本)来实施批次效应校正。使用基于经验累积分布函数(ECDF)的 Q-Q 变换校正批次效应。该方法将一个锚定样本的分位数值非线性映射到另一个锚定样本中的对应分位数,从而有效对齐它们的分布。随后将该变换应用于第一批次中的肿瘤样本。
值得注意的是,由于 Q-Q 图变换依赖插值,本质上受限于锚定样本的范围;对于该范围之外的值,基于样本均值和标准差的线性外推可以近似变换的斜率和截距,从而在观测数据范围之外为非线性映射提供合理估计。
该变换可以近似为以下方程:
批次校正后,将完整队列下采样至每个样本约 10,000 个细胞,用于后续与基质细胞一起分析。移除基质细胞后,队列进一步下采样至每个样本 5,000 个细胞。如之前所述22,23,归一化和数据缩放要么将所有肿瘤作为一个批次进行,要么对单个肿瘤进行。简言之,使用核心组蛋白(H3、H3.3 和 H4)对细胞进行门控,随后使用这些核心组蛋白值对细胞内蛋白(包括组蛋白 PTMs)的信号进行归一化,以减少系统性技术变异:
选择系数以最小化核心组蛋白方差之和。UMAP 表示显示随机子集的数据点(约 10%)以改善可视化。
降维和聚类
为了分析我们的 CyTOF 实验产生的高维数据,我们首先使用 UMAP94 进行降维。随后使用 DBSCAN95 进行聚类。然后根据表达模式的相似性合并聚类,以定义三个不同的细胞亚群:cycling、luminal 和 basal-like。
使用置换校准的标记程序评分进行单细胞数据的 PermCell 特征评分
我们针对每个细胞和每个预定义基因特征,量化该集合相对于竞争性零模型是否富集,该零模型匹配特征大小,但从同一细胞剩余标记中采样特征。该方法返回每个细胞的 z 分数,并在 UMAP 嵌入上可视化。
详细计算如下:
令 X ∈R(N × G) 为细胞×特征矩阵。对于集合 \(\,{\mathcal{S}}=\{{S}_{1},\ldots ,{S}_{S}\}\),每个 Ss 的大小为 m_s ms = |Ss|。支持可选的带符号特征权重 w{s,g}(若 g ∉ S_s,则 w{s,g} = 0)。
我们按细胞进行行中心化以去除全局水平偏移,如下所示:
带符号观测和(未加权)如下:
带符号观测和(加权)如下:
绝对幅度观测和(未加权)如下:
绝对幅度观测和(加权)如下:
对于竞争性零假设(大小匹配的置换或精确枚举),对于每个集合 s,我们构建了一个竞争基因池 \({{\mathcal{P}}}_{{\rm{s}}}\)。默认情况下,我们使用当前特征空间中的补集,\({{\mathcal{P}}}_{s}=\{1,\ldots ,G\}\backslash {S}_{s}\)(exclude_set = True),以强制实施竞争性零假设;如果补集太小,我们则回退到所有特征。然后我们从 \({{\mathcal{P}}}_{{\rm{s}}}\) 中无放回地抽取 m_s 个基因,为每个细胞构建零和:
其中 b = 1,…,B 次置换。当组合数 \(C(|{{\mathcal{P}}}_{s}|,{m}_{s})\) 低于阈值(默认 5 × 10⁴)时,我们以流式分块方式精确枚举。对于每个细胞和集合,我们通过数值稳定的流式更新估计零均值和方差(以及绝对变体的类似量);向标准差加入一个小常数(10–6)以避免除以零。
每个细胞的 z 分数(有符号和绝对值)计算如下:
右尾 P 值(可选双侧)计算如下:
为了在保留方向的同时概括效应大小,我们定义:
因此,当集合持续上调时(绝对信号大且净方向为正),Z_dir 大且为正;当持续下调时,Z_dir 大且为负。
该框架支持有符号特征权重 \(w_{s,g} \in \mathbb{R}\)。正权重要求更高的表达,而负权重编码了预期在目标程序中低表达的标记。零假设通过从 \({{\mathcal{P}}}_{s}\) 中抽取 m_s 个未加权竞争基因来保持相同大小 \({m}_{s}=\sum _{g}{\mathbb{1}}[w\{s,g\}\ne 0]\),从而保留竞争性解释。观测到的有符号和使用 w{s,g},而绝对幅度和使用 |w{s,g}|。
我们每个集合使用 B = 2,000 次置换(最终图表为 10,000 次),exclude_set = True(竞争性零假设),当耗竭相关时使用双侧 P 值,并将 FDR 控制在 5%。对于 scRNA-seq,我们建议在文库大小归一化和可选的技术协变量回归后,对对数归一化计数进行计算;对于 CyTOF,arcsinh 或 z-score 缩放的通道效果良好。
将细胞机器学习分类至亚群
在每个肿瘤中,构建了一个细胞训练集,仅包括被成功分类为 luminal、basal-like 或 cycling 的细胞,并保持样本间的类别分布和大小相等。从每个肿瘤中,这些细胞的 80% 被随机分配到训练集,其余 20% 用作验证集。我们使用了 XGBoost 模型35,学习率为 0.1、最大深度为 10、估计器数量为 1,000。该模型在验证集上达到了 94% 的预测准确率。随后,训练好的模型被应用于未被 DBSCAN 分配到亚群的细胞(cluster –1),预测置信度 >95% 的细胞被分配到相应的 luminal、basal-like 或 cycling 亚群,用于下游分析(Extended Data Fig. 3b)。每个特征对 XGBoost 分类的贡献使用 SHAP 分数30,31 评估,其反映的是特征对分类的贡献,而非相对表达水平。
用于确定表观遗传多样性的 Vendi 分数
Vendi scores96 是基于表观遗传 CyTOF panel(组蛋白 PTM 和染色质修饰因子)计算的。对于每个样本,细胞按类别标签分层。为控制各类别之间细胞数量的差异,我们从每个类别中无放回地重复抽样子样本 m = ⌊n_min/2⌋ 个细胞,其中 n_min 是该样本中最小的类别大小。标志物强度首先使用在来自所有数据集的平衡细胞样本上计算的全局 z-score 进行归一化。对于每次 rarefaction,表观遗传标志物值被离散化为 20 个均匀 bin,并在所得的细胞×标志物矩阵上计算归一化的对偶 Vendi score。报告值对应于 5,000 次 rarefaction 的均值,不确定性区间由 rarefied score 分布的第 2.5 和第 97.5 百分位数定义。
基于 K5 的分选及后续蛋白质组、转录组、CUT&Tag 和 EM-seq 分析
细胞染色、分选和样品制备
质谱分析的样品制备经过优化,以在有限起始材料下实现 FACS 前细胞内染色。为 CyTOF 制备的轻度固定(1.6% PFA)乳腺肿瘤单细胞悬液被解冻,并用 Maxpar CyTOF PBS 洗涤。细胞按照制造商说明使用 Maxpar nuclear antigen staining buffer set(201063,Standard BioTools)进行固定和透化。染色在 10% FCS/CyTOF Nuclear Antigen Staining Perm 中使用以下抗体完成:K5–AF546(Cell Signaling,71536,内部荧光团偶联)和 pan-keratin–AF647(Cell Signaling,4528)。用 PBS 洗涤三次后,将细胞转移至新孔中,以尽量减少残留去垢剂含量。样品使用 FACS(BD Aria III)读取,每个群体(K5hi 和 K5low;Supplementary Fig. 12a)的 200 个细胞直接分选到 96 孔板格式(Eppendorf twin.tec PCR plates)中新鲜配制的含 3 μl 裂解缓冲液的孔内。分选仪液滴体积为 3.33 nl 时,分选过程使每孔总体积额外增加 0.66 μl。
细胞裂解缓冲液通过混合以下组分制备:5 mM tris-(2-carboxyethyl) phosphine(TCEP)作为还原剂,20 mM chloroacetamide(CAA)烷化剂,100 mM triethylammonium bicarbonate(TEAB)和 0.1% n-dodecyl-β-D-maltoside(DDM)。分选后,将板短暂离心,以确保细胞沉降到裂解缓冲液中。随后用 PCR 盖条密封板,并在 Eppendorf ThermoMixer C 中于 95 °C 孵育 30 min,盖上盖子以防止冷凝。孵育后,将板冷却、短暂离心,并向每孔加入 11 μl 蛋白消化缓冲液(50 mM 碳酸氢铵缓冲液、0.033 ng μl–1 测序级修饰胰蛋白酶(Promega)和 0.132 ng μl–1 Trypsin/Lys-C mix,质谱级(Promega))。将板重新密封、短暂离心,并在室温下过夜孵育以进行蛋白消化。第二天,向每孔加入 20 μl 溶剂 A(99.9% 水和 0.1% 甲酸),以酸化样品并终止胰蛋白酶消化过程。
LC–MS 分析
LC–MS 分析在 Evosep1 液相色谱系统(Evosep)上进行,该系统与 TimsTOF SCP 质谱仪(Bruker)联用。样品按照制造商说明加载到一次性 Evotip C18 捕集柱(Evosep Biosystems)上。简言之,工作流程包括用 20 μl 溶剂 B(99.9% 乙腈和 0.1% 甲酸)冲洗干燥的 Evotip,随后在 800g 下离心 60 s。然后将吸头浸泡在 100 μl 1-丙醇中进行调理,直到它们呈浅白色。调理后,用 20 μl 溶剂 A 平衡吸头,随后在 800g 下离心 60 s。将蛋白样品加载到湿润的吸头上,随后再次在 800g 下离心 60 s。为确保洁净,用 20 μl 溶剂 A 洗涤吸头,并重复离心。最后,为保持吸头水合,加入 100 μl 溶剂 A,并在 800g 下短暂离心 10 s。
肽段使用 Whisper 40 SPD 方法在 Aurora Elite CSI 15 × 75 C18 UHPLC 柱(IonOpticks)上分离。质谱采集以数据非依赖(DIA)PASEF 模式进行。对于 diaPASEF 模式,离子累积和 ramp 时间设为 100 ms,分析离子淌度范围 1/K0 = 1.45 V s–1 cm–2 至 0.64 V s–1 cm–2 的前体离子,质荷比(m/z)范围为 100 至 1,700。用于 MS/MS 分析的前体离子根据 diaPASEF 窗口设置进行分离,覆盖离子淌度范围 1/K0 = 0.75 V s–1 cm-2 至 1.2 V s–1 cm–2 以及 m/z 范围 400–1,000。估计周期时间为 0.64 s,包含 1 个 MS ramp 和 5 个 MS/MS ramp,共产生 75 个 MS/MS 窗口。碰撞能量从 1/K0 = 0.6 V s–1 cm–2 时的 20 eV 梯度升至 1/K0 = 1.6 V s–1 cm–2 时的 59 eV。
数据分析
使用 DIA-NN(v.1.8.1)分析质谱原始文件97。文件分析采用基于文库的方法(谱文库由 BRUKER 提供,包含 67,686 个蛋白和 13,827 个基因)。使用 FASTA 数据库(FASTA 文件 UP000000589_10090.fasta 和 UP000000589_10090_additional.fasta,2022 年 8 月版本)重新注释文库前体。选择胰蛋白酶作为蛋白酶,最多允许一个漏切位点。使用 DIA-NN 默认设置,但有以下例外:前体电荷范围设为 2–10,并选择“unrelated runs”选项。共鉴定到 5,630 个蛋白。
使用 enricher 函数(clusterProfiler 包98)对差异表达蛋白进行功能富集分析,并与 MsigDB hallmark 基因集85 进行比较。
分选群体上的 H3K4me1 CUT&Tag
来源于 luminal PDX 肿瘤或 MCF7 培养物的轻度固定(1.6% PFA)细胞的单细胞悬液如上所述进行染色。对于 PDX 样品,细胞用 K5–AF555(Cell Signaling, 72825)和 pan-keratin–AF647(Cell Signaling, 4528)染色。pan-keratin 阳性上皮细胞根据 K5 表达水平分选为 K5hi 和 K5low 群体。对于 MCF7 细胞,使用 K5–AF555 和 GATA3–Brilliant Violet(BioLegend, 653814)进行染色。表达高 K5 和低 GATA3 的细胞定义为 K5hi,并与剩余细胞群体(K5low)进行比较。使用 Sony SH800S 细胞分选仪(Sony Biotechnology)分选细胞,并用单染对照进行补偿和建立门控阈值。
文章标题:乳腺肿瘤中的表观遗传异质性为诊断和预后提供信息
正文: 分选后,按照制造商说明,使用 CUT&Tag-IT Express Assay 试剂盒(Active Motif,53175)进行 H3K4me1 分析。H3K4me1 抗体(Cell Signaling,5326)以 1:50 稀释度使用。去交联通过在 55 °C 孵育 1 h、随后在 65 °C 孵育 4 h 完成。文库在 AVITI 平台(Element Biosciences)上使用双端 50 bp 读长进行测序。测序数据经过拆分并比对到 hg38 组装版本。使用 MACS2 并以 --keep-dup 1 参数进行峰识别。K5hi 或 K5low 样本各自独有的峰使用 ChIPseeker R 包分配至基因。功能富集分析使用 clusterProfiler R 包中的 enricher 函数进行,所用基因特征详见 Supplementary Table 4。
分选群体的 EM-seq
EM-seq 针对低起始量样本进行了调整。肿瘤单细胞悬液按上述方法用 K5 和 pan-keratin 抗体染色。简言之,每个群体(K5hi 和 K5low)各取 200 个细胞,直接分选到新鲜配制的裂解缓冲液(10 mM Tris-HCl,pH 8.0,200 mM NaCl,10 mM EDTA,0.5% SDS 和 0.3 mg ml–1 蛋白酶 K)中并冷冻。每种条件分析四个重复。
裂解的细胞在 55 °C 孵育 3 h,随后在 60 °C 过夜孵育以逆转交联。在 PCI 提取前加入 Tris-HCl 和 NaCl 将 SDS 浓度降至 0.33%。回收水相,将 NaCl 调整至 300 mM,并加入糖原至 0.13 mg ml–1,随后用 2.3 倍体积的冰冷乙醇在 −20 °C 过夜沉淀 DNA。通过离心(21,000g,45 min,4 °C)沉淀 DNA,用 70% 乙醇洗涤一次,并重悬于 10 mM Tris-HCl、0.1 mM EDTA(pH 8.0)中。
DNA 样本使用 NEBNext UltraShear 试剂盒(M7634S,New England Biolabs)在 37 °C 下酶切片段化 25 min。文库使用 NEBNext Enzymatic Methyl-seq v.2 试剂盒(E8015S,New England Biolabs)和 NEBNext LV Unique Dual Index Primers Set 2A(E3390S,New England Biolabs)按照 NEBNext UltraShear 用户手册第 3 节制备,并作以下修改:未甲基化 lambda 和 CpG 甲基化 pUC19 DNA 对照按 1:500 稀释。四个重复中的三个重复的文库使用转化对照制备。胞嘧啶脱氨基前的 DNA 变性使用甲酰胺(4401457,Thermo Fisher Scientific)进行。文库扩增 12 个 PCR 循环,并使用 NEBNext Sample Purification Beads 以 0.8× 比例进行 2 轮磁珠纯化。文库质量和片段大小分布使用 Agilent TapeStation 配合 High Sensitivity D5000 试剂盒评估,平均片段大小约为 500 bp。文库在 AVITI 高通量流动池(Element Biosciences)上测序,产生 150 bp 双端读长。
双端测序读长使用 cutadapt99(v.4.4;参数:--quality-cutoff 20 --overlap 5 --minimum-length 25;从双端读长中切除 Illumina TruSeq 接头‘AGATCGGAAGAGC’)进行接头和质量修剪,随后从第一条读长的 5′ 和 3′ 端分别修剪 10 和 5 个核苷酸,从第二条读长的 5′ 和 3′ 端分别修剪 15 和 5 个核苷酸。修剪后的读长使用 BSMAP100(v.2.90;参数:-v 0.1 -s 16 -q 20 -w 100 -S 1 -u -R)比对到人类参考基因组(hg19)。使用 GATK101(v.4.6.2.0;--VALIDATION_STRINGENCY = LENIENT --REMOVE_DUPLICATES=true)中的‘MarkDuplicates’命令去除重复。甲基化率使用 MOABS 包102(v.1.3.9.6;默认参数)中的 mcall 进行识别。为评估分选肿瘤群体之间的相似性,仅使用某一给定肿瘤全部八个样本中共有的 CpG 计算 CpG 甲基化水平的成对相关性。Pearson 相关系数在这些共有 CpG 位点上计算。
对每个肿瘤分别进行 K5hi 和 K5low 细胞的差异甲基化分析,并合并重复样本以获得更高覆盖度。使用 WGBStools(https://doi.org/10.26508/lsa.202503514)识别差异甲基化区域,并根据启动子重叠(转录起始位点(TSS)的 –2,000 至 +500)将这些区域分配给基因。对每个基因,汇总启动子相关甲基化变化,仅考虑绝对差异 >0.2 且 FDR 校正的 Fisher 精确检验 <0.05 的基因。根据甲基化变化的主要方向对基因进行分类。
使用 enricher 函数(clusterProfiler 包)进行功能富集分析,与 MsigDB hallmark 基因集或经整理的乳腺癌细胞身份特征进行比较。
对每个肿瘤和状态组合,在 CGI 水平汇总合并重复样本的 EM-seq 甲基化谱,通过计算甲基化读段与总覆盖度的比值得到 CGI 甲基化。将 TCGA BRCA DNA 甲基化数据(Illumina HumanMethylation450)映射到 hg19 CGI 坐标,每个肿瘤的 CGI 甲基化定义为与相应 CGI 重叠的探针的平均 β 值。构建共享 CGI 特征空间,即 EM-seq 中检测到的 CGI 与 TCGA 中可测量的 CGI 之间的交集。在每个样本(肿瘤 5 或肿瘤 23)中,对每个 CGI 计算 K5hi 与 K5low 状态之间的差异甲基化,并保留在两个样本中变化方向一致的 CGI。每个保留 CGI 的效应量定义为模型特异性差异的中位数,并用于赋予带符号权重。TCGA CGI 甲基化值在肿瘤间进行标准化,对每个肿瘤,特征评分计算为保留 CGI 上标准化 CGI 甲基化值的加权平均值。比较不同 PAM50 亚型之间的特征评分。
使用 RLM 工具103 量化读段水平的 DNA 甲基化异质性。对每个重复样本,使用参数 -m PE、-a bsmap 和 -s all,对 BSMAP 比对的双端 BAM 文件针对 hg19 参考基因组进行分析。仅保留测序覆盖度 ≥10 条读段的位点用于分析。对每个样本汇总所有位点的熵值,并在每个肿瘤样本中比较 K5hi 与 K5low 之间的差异。
RNA 提取与 bulk MARS-seq
对于 bulk MARS-seq 分析,将 MCF7 细胞分选为 K5hiGATA3low 和 K5lowGATA3hi 群体(如上所述),以捕获基底样和极端管腔亚群。使用添加了 DNase I(Merck,4716728001)的 Accutase(Sigma-Aldrich,STC-07922)解离细胞,用 PBS 洗涤,并使用 Zombie Violet fixable viability dye(BioLegend,423105 或 423113)进行活力评估。细胞在冰上避光孵育 10 分钟,随后用染色缓冲液(含 2% FBS 和 2 mM EDTA 的 PBS)洗涤 2 次。对于细胞内染色,细胞在室温下于 4% 甲醛–PBS 中固定 15 分钟。用甘氨酸(终浓度 125 mM)淬灭固定反应,细胞在 4 °C 下以 700g 离心 5 分钟,然后用冰冷染色缓冲液洗涤一次、用 PBS 洗涤一次。细胞在室温下于含 0.1% Triton X-100 的 PBS 中透化 15 分钟,用染色缓冲液洗涤两次,并用封闭缓冲液(含 5% FBS 和 2 mM EDTA 的 PBS)在冰上封闭 10 分钟。随后,细胞在染色缓冲液中用 anti-GATA3-BV421(1:10 稀释,BLG-653814)和 anti-KRT5-Alexa Fluor 555(1:20 稀释,CST-72825S)抗体在 4 °C 避光过夜染色,之后用分选缓冲液洗涤两次。在 Sony SH800S Cell Sorter 上进行流式细胞术。对单个活细胞设门(排除 Zombie 染料阳性细胞)。在活细胞群体中定量细胞内 GATA3 和 KRT5 表达,使用单染对照进行补偿并确定设门阈值(补充图 12b)。
按照制造商说明,使用 RNeasy Micro Kit(Qiagen,74004)提取总 RNA,并储存于 −80 °C。按照已发表的方案104,从提取的 RNA 制备 bulk MARS-seq 文库,并使用 NextSeq 500/550 High Output Kit v.2.5(75 个循环)在 NextSeq 500 仪器上测序。使用 UTAP 转录组分析流程105进行差异表达分析。
CD74hi 和 CD74low MCF7 细胞的流式细胞术分选
使用添加了 DNase I(Merck,4716728001)的 Accutase(Sigma-Aldrich,STC-07922)解离 MCF7 细胞,并在培养基中计数。用 PBS 洗涤细胞,并使用 Zombie NIR 或 Zombie Violet fixable viability dye(BioLegend,423105 或 423113)进行活力评估。细胞在冰上避光孵育 10 分钟,随后用染色缓冲液(含 2% FBS 和 2 mM EDTA 的 PBS)洗涤两次。对于表面标志物染色,细胞与抗人 CD74–FITC 抗体(在染色缓冲液中 1:10 稀释;eBioscience,11-0748-42,clone 5-329)在 4 °C 避光孵育 45 分钟,每 10 分钟间歇混匀,然后用分选缓冲液(含 1% FBS 和 5 mM EDTA 的 PBS)洗涤两次。将活细胞分选到含 50% FBS 和 50% DMEM 并添加 1% 青霉素–链霉素的收集培养基中。为富集基底样群体细胞,根据 CD74–FITC 荧光强度分选 CD74 表达最高的前 10% 细胞(CD74hi),并作为对照分选 CD74 表达最低的后 10% 细胞(CD74low)(补充图 12c)。使用 Sony SH800S 细胞分选仪(Sony Biotechnology)分选细胞,并使用单染对照进行补偿和确定设门阈值。
迁移实验
Transwell 实验
细胞迁移能力使用置于 24 孔板中的 Transwell 聚碳酸酯膜插入物(直径 6.5 mm、孔径 8.0 µm;Corning, 3422)进行评估。分选后的细胞接种于完全培养基中,并恢复约 20 h。随后,实验前在添加 0.1% FBS 的 DMEM 中进行血清饥饿 5 h。血清饥饿后,使用 Accutase 解离细胞,重悬于含 0.1% FBS 的 DMEM 中并计数。将 150 µl 含 0.1% FBS 的 DMEM 中的 5 × 10⁴ 个细胞接种到上室。下室加入 600 µl 含 20% FBS 和 100 ng ml–1 表皮生长因子(EGF;PeproTech, AF-100-15)的培养基作为趋化剂。对照孔的上下室均加入含 0.1% FBS 的 DMEM,以评估随机迁移。
迁移 20 h 后,用棉签去除膜上表面的未迁移细胞,下表面的迁移细胞用 4% 甲醛(Thermo Fisher Scientific, 28906)在室温下固定 15 min,并在 20% 甲醇中用 0.1% 结晶紫(Sigma-Aldrich, C0775)染色 10 min。膜用蒸馏水洗涤并风干。由于结晶紫信号强度弱且背景噪声高,妨碍了准确的自动化定量,因此使用 Cy5 通道(激发和发射分别为 640 和 670 nm)对迁移细胞成像,以检测结晶紫自发荧光。该方法实现了可靠的背景扣除和自动细胞计数。Cy5 信号与结晶紫阳性细胞完全重叠,从而证实自发荧光准确代表了迁移细胞群体。使用 ImageJ 软件(v.1.53;National Institutes of Health)进行定量,结果表示为每视野迁移细胞数。
伤口愈合实验
使用二维伤口愈合实验评估集体细胞迁移和伤口闭合。在无菌条件下,将用于自行插入的 Culture-Inserts 2 Well(ibidi, 80209)置于 6 孔板(Corning, CC-3516)中。以每孔 70 µl 完全生长培养基中 1 × 10⁵ 个细胞接种,并孵育 24 h 直至形成汇合单层。用无菌镊子小心移除培养插入物,以形成宽度约 500 µm 的明确无细胞间隙。孔用 PBS 洗涤两次以去除未贴壁细胞,并加入 2 ml 新鲜培养基。使用倒置显微镜在致伤后 0 h、20 h、46 h 和 54 h 以 ×10 放大倍数采集图像。
使用基于 Segment Anything Model(SAM)的交互式分割工作流程,从明场图像中定量伤口面积。对每张图像,将伤口区域识别为连续的无细胞区域,并使用放置在伤口内以及(在需要时)放置在伤口外的用户引导点提示进行分割,以抑制周围组织或背景。对得到的二值掩膜进行视觉检查并交互式细化,直至其与伤口边界匹配。然后将伤口面积计算为最终掩膜中包含的像素数。为考虑图像大小或视野差异,对每张图像通过将伤口掩膜面积除以图像总面积计算伤口面积分数。当有空间校准可用时,使用显微镜像素尺寸将像素面积转换为物理单位(µm2)。该流程产生了绝对和归一化的伤口面积测量值,用于跨实验条件比较。
乳腺肿瘤样本的 WGBS
样本处理、亚硫酸氢盐反应和测序
为 CyTOF 制备的轻度固定乳腺肿瘤单细胞悬液被解冻,并使用 NucleoSpin Tissue 试剂盒提取 DNA。在裂解步骤中加入 20 μl 10 mg ml–1 RNase 去除 RNA。WGBS 双索引文库的构建遵循基于 NEBNext Ultra DNA Library Prep kit for Illumina(New England BioLabs,E7442、E7445 和 E7535)的修改方案,并按照制造商说明进行。文库投入量为 500 ng gDNA,使用 Qubit BR 检测(Invitrogen,Q32853)定量,并加入 1% 未甲基化 Lambda DNA(Promega,D1521)作为亚硫酸氢盐转化效率的对照。使用 Covaris S220 Focused-ultrasonicator 将投入的 gDNA 片段化至平均插入片段大小为 350 bp。使用 SPRIselect 磁珠进行片段大小选择,分离 300–400 bp 范围内的片段。大小选择后使用 EZ DNA Methylation-Lightning 试剂盒(Zymo,D5030)进行亚硫酸氢盐转化,并遵循制造商指南。亚硫酸氢盐转化后的扩增使用 Kapa HiFi Uracil+(Kapa Biosystems,KK282)聚合酶,循环条件如下:98 °C 45 s,随后 8 个循环的 98 °C 15 s、65 °C 30 s 和 72 °C 30 s,最后 72 °C 延伸 1 min。WGBS 文库在 Illumina NovaSeq 6000 仪器上测序,使用 S4 flowcell 和 150 bp 双端双索引运行,并加入 5% PhiX 文库对照(Illumina)。所得覆盖度为 16.7× 至 22.5×。未甲基化 Lambda DNA 的亚硫酸氢盐转化率平均为 99.8%。
WGBS 数据分析
双端测序读段使用 Trim Galore!(v.0.6.5)预处理,然后使用 ‘non_directional’ 选项通过 Bismark(v.0.24.2)和 Bowtie2(v.2.3.5.1)106 进行比对。为亚硫酸氢盐转化的人 hg19 生成参考基因组(获自 UCSC)。所得比对文件使用 Samtools(v.1.16.1)合并并排序,并用 ‘deduplicate_bismark’ 进一步去重,随后使用 ‘bismark_methylation_extractor’ 调用上下文依赖性甲基化。
使用 ClubCpG 包55 从读段水平甲基化模式计算经验熵。对 100 bp 基因组分箱内的甲基化模式进行读段聚类,用于确定观察到的 DNA 甲基化状态经验分布,不对未完全覆盖给定分箱的读段进行插补。由于该数据
文章标题:Epigenetic heterogeneity in breast tumours informs diagnosis and prognosis
正文: 为与 TCGA BRCA 数据集51 对比并对 DNA 甲基化数据进行解卷积,使用 HumanMethylation450 v.1.2 Manifest File (https://emea.support.illumina.com/downloads/humanmethylation450_15017482_v1-2_product_files.html) 计算 HumanMethylation450 芯片(Illumina)中每个探针的甲基化状态。随后使用 EDec 包 (https://github.com/BRL-BCM/EDec)110 将合并数据集(TCGA 与本研究)解卷积为不同数量的 archetypes。TCGA BRCA 数据集中的 PAM50 信息用于按亚型对肿瘤进行注释。TCGA BRCA 数据集可获取的相关表达数据用于将表达模式与每个 archetype 相关联。基因按各 archetype 的 Pearson 相关系数排序,这使我们能够利用 GSEA 和 MSigDB Hallmarks 基因集85,111,112 将每个 archetype 与功能术语相关联。
单细胞多组学数据集分析
使用 Chromium Next GEM Single Cell Multiome ATAC + Gene Expression 平台(10x Genomics),按照制造商方案对染色质可及性和基因表达进行同步分析。将冷冻保存的乳腺癌细胞快速解冻,在补充有 10% FBS 的 RPMI 中逐步稀释,在含 0.04% BSA 的 PBS 中洗涤,并通过 40 μm 滤网过滤。使用 10x Genomics 细胞核分离流程分离细胞核,在预冷的细胞核洗涤缓冲液中洗涤,并重悬于稀释的细胞核缓冲液中。细胞核悬液经过滤去除聚集体,并调整至推荐浓度后上样。每个样本约 500 个细胞核上样至 Chromium controller 进行 tagmentation、barcoding 和 GEM 生成。基因表达和 ATAC 文库按照制造商方案生成,并使用 10x Genomics 双索引板进行索引。文库质量和浓度使用 Qubit 荧光法和 Agilent TapeStation 评估。测序按照 10x Genomics 规格在 Aviti 平台上进行。ATAC–seq 数据使用 cellranger-arc(v.2.2.0)处理,并比对到人类基因组 GRCh38。基因表达数据使用 cellranger(v.10.0.0)处理。
先前发表的 scRNA-seq 和 scATAC–seq 数据13 按照作者所述方法进行分析。仅纳入根据 RNA 谱定义为癌细胞的细胞用于分析。为可视化基因表达模式,计算指定 signature 的 UCell 评分。为考虑 dropout,使用高斯核对基因 signature 进行平滑处理,带宽设为归一化基因空间中点对点距离的欧几里得距离的第 5 百分位数。对于 basal–luminal 指数,计算 luminal 相对 basal 下调 signature 与 luminal 相对 basal 上调 signature59 之间的 z-score 差值。对于 ATAC–seq 数据,分别对每个样本(仅癌细胞)进行 peak calling,并计算 WIP 分数。较低的 WIP 分数对应较高比例的片段位于所call peak 之外,被解释为表观遗传噪声增加58。
乳腺肿瘤中 H3K4 和 H3K9 甲基化的 snCUT&Tag 分析
样本制备
CD45 去除后,将 1 × 10⁶ 个细胞重悬于抗体缓冲液(20 mM HEPES pH 7.5、150 mM NaCl、2 mM EDTA、0.5 mM 亚精胺、0.05% digitonin、0.01% NP-40、蛋白酶抑制剂和 1% BSA)中,冰上孵育 3 分钟,并以 600g 离心 3 分钟,按先前所述方法提取细胞核113。细胞核重悬于补充有 10% DMSO 的抗体缓冲液中,并冷冻保存用于进一步分析。
文章标题:乳腺肿瘤中的表观遗传异质性为诊断和预后提供信息
正文: 对于 CUT&Tag,除非另有说明,所有洗涤均使用 500 µl 进行,所有离心均使用吊桶式离心机在 4 °C 下以 600g 离心 8 分钟。将约 50,000 至 100,000 个细胞核重悬于 50 μl 抗体缓冲液(EDTA 2 mM、20 mM HEPES pH 7.2、NaCl 150 mM、亚精胺 0.5 mM、BSA 2%、NP-40 0.01%、洋地黄皂苷 0.01% 和蛋白酶抑制剂 1×)中,加入 1:50 稀释的抗体(抗 H3K4me1 D1A9,5326 和抗 H3K4me3 C42D8,9751,Cell Signaling)或 0.3 μg(抗 H3K9me2 D85B4 80806,Cell Signaling),并于 4 °C 旋转孵育过夜。次日用 Dig-Wash 缓冲液洗涤细胞核,并重悬于 100 μl Dig-300 缓冲液(20 mM HEPES pH 7.2、300 mM NaCl、0.5 mM 亚精胺、2% BSA、0.01% NP-40 和 0.01% 洋地黄皂苷)中,同时加入 protein A–Tn5 融合蛋白(Diagenode,C01070001,1:250),于室温旋转孵育 1 小时。用 Dig-300 缓冲液洗涤细胞核 3 次,重悬于 300 µl Tag-Buffer(20 mM HEPES pH 7.2、300 mM NaCl、0.5 mM 亚精胺、2% BSA、0.01% NP-40、0.01% 洋地黄皂苷和 10 mM MgCl2)中,并于 37 °C 孵育 1 小时。通过加入一倍体积的 1x 稀释细胞核缓冲液(DNB,10x Genomics,补充有 2% BSA 和 12.5 mM EDTA)终止 tagmentation。随后将细胞核在 4 °C 下以 1,300g 离心 4 分钟,并用 200 µl 补充有 2% BSA 的 1× DNB 洗涤两次。将细胞核重悬于 10–70 µl DNB + 2% BSA 中。按照先前描述的方法113,使用 10X Chromium Single Cell ATAC–Seq kit v.2(10x Genomics)将细胞核加载到 10x Chromium 系统上。GEM 孵育、条形码标记和扩增按照 Chromium Single Cell ATAC Library kit 手册进行,使用 17 个 PCR 循环。文库使用 13 个 PCR 循环进行扩增。snCUT&Tag 文库在 NovaSeq 6000(Illumina)上以 PE50 模式测序。
snCUT&Tag 数据分析
原始测序文件(Fastq 文件)使用内部流程(https://github.com/vallotlab/scCUT-Tag_10X)处理,以生成片段文件和计数矩阵。简言之,使用 Bowtie2(v.2.5.4)将条形码比对到索引参考文库,并使用 STAR(v.2.7.8a)将 reads 的基因组部分比对到人类参考基因组(hg38)。重复 reads、比对到 ENCODE 黑名单区域的 reads 以及比对质量低(q20)的 reads 被过滤掉。
接下来,使用 50-kb bin 矩阵生成所有三个肿瘤样本的联合 UMAP 表示。肿瘤微环境和肿瘤细胞根据已知标记基因处的 H3K4me1 或 H3K4me3 富集进行注释(Supplementary Table 7)。由于在肿瘤解离过程中物理去除了 CD45+ 细胞,因此无法基于 H3K4me1 或 H3K4me3 图谱鉴定出免疫细胞。使用 CallPeaks(Signac)114 进行 peak calling。基因活性矩阵通过按照标准 Signac 方法聚合基因体和启动子区域(从 TSS 延伸 –2 kb)的计数生成。这些基因水平活性评分被用作降维和聚类的特征。计数数据集分别对每个肿瘤使用 SCTransform115 进行标准化。差异结合占据通过双侧 Wilcoxon 符号秩检验(FDR 校正)计算。功能富集使用 enricher 函数(clusterProfiler 包98)进行,以 MsigDB 基因集85,116 作为参考。表观基因组基因特征评分使用 UCell117 对每个感兴趣的基因集计算,起始于 SCTransform 计数。为了在 UMAP 空间中可视化基因特征,考虑到 dropout,表观基因组基因特征评分使用高斯核进行平滑,带宽设置为归一化基因空间中点到点距离的欧几里得距离的第 5 百分位数。
为了识别导致表观基因组肿瘤内异质性(H3K4me3 或 H3K4me1)的位点,在训练好的 XGBoost 分类器35 上使用了 SHAP 算法。对于每个肿瘤,将导致准确分类的最有贡献的基因(约 400 个基因,约 90% 准确率)与来自 MSigDB85,116 的基因签名进行比较。
通过聚合分配给每个聚类的细胞的片段级 snCUT&Tag 数据,生成了伪批量覆盖轨迹。对于每个样本和组蛋白标记,将对应于基底样聚类和所有剩余聚类的片段分别合并。为了能够直接比较,对非基底样组进行降采样,以匹配基底样群体的总片段数。从片段区间计算全基因组覆盖度,并归一化为每百万计数(CPM),生成 bedGraph 文件,随后转换为 bigWig 格式用于可视化。使用 pyGenomeTracks 可视化轨迹。
从单细胞数据生成伪批量染色质图谱,并使用 MACS3(参考文献 118)进行 peak calling,其中窄峰模式应用于 H3K4me3,宽峰模式应用于 H3K4me1。使用 ChIPseeker107 注释每个样本和组蛋白修饰的统一 peak 集,并将基因组特征分布总结为每个样本总 peak 的百分比,在可视化前合并启动子亚类。在一对其余框架中评估 peak 与聚类的差异关联。对于每个 peak,将信号存在与否二值化,并使用单侧双比例 z 检验比较目标群体(聚类)和剩余细胞之间的检测比例。效应大小计算为 CPM 归一化平均信号的 log2 倍数变化。P 值使用 Benjamini–Hochberg 程序校正,peak 在校正后 P ≤ 0.05、log2 倍数变化 ≥ 0.25 且最低检测率为 1% 时被认为显著。
使用 Signac 框架114 和从 JASPAR 数据库119 获得的转录因子结合谱进行 motif 富集分析。检查了与预定义的 EMT 和基底样状态调节因子列表相关的 motif,这些调节因子分别针对增强子(H3K4me1)和启动子(H3K4me3)信号定义,使用 P < 0.05 的名义显著性阈值。在每个样本测试的转录因子子集中使用 Benjamini–Hochberg 程序计算多重检验校正,这反映了减少的假设空间。
为了比较 read count 与基因活性,对于每个肿瘤,将每个细胞的计数数(‘nCount_RNA’)与表观基因组基因签名评分(在 TFIDF 归一化115 数据上计算的 UCell)进行相关性分析(Pearson)。
使用 scGLUE120,我们将 H3K4me1 snCUT&Tag 数据集与 CyTOF 数据集进行多模态整合。对于 CyTOF 抗体面板中存在的每个细胞身份标记,我们在基因活性矩阵中识别相关基因,并使用这些基因形成 scGLUE 的弱信息连接。运行 scGLUE 后,我们在联合潜在空间中对 CyTOF 数据训练 XGBoost 分类器以预测细胞标签,并使用该分类器将标签转移到 snCUT&Tag 模态。
对于 H3K9me2 数据集的细胞注释,使用了来自同一细胞核提取的互补 H3K4me1 数据集。简言之,为 H3K4me1 和 H3K9me2 数据集生成了 20-kb bin 矩阵,保留来自 H3K4me1 分析的细胞标签。在标记的 H3K4me1 数据集上训练分类器,达到 >95% 准确率,并将其应用于 H3K9me2 的倒置 z-score 矩阵,使用 H3K4me1 相关调控染色质和 H3K9me2 相关抑制染色质的一般相反基因组分布作为推断框架62,63。
对于基因关联分析,H3K9me2 在未进行 peak calling 的情况下进行分析,因为该标记形成宽泛的抑制性结构域,而不是尖锐的局灶峰。相反,启动子区域(相对于 TSS 的 –2 kb 至 +200 bp)被划分为 200 bp 窗口,并在这些启动子近端窗口上量化片段计数,以生成启动子占据矩阵。所得矩阵使用 SCTransform115 进行归一化,并用于 UMAP 嵌入和聚类。由于 H3K9me2 是一种抑制性组蛋白标记,高基因集评分被解释为相应位点上的抑制性占据增加,而不是转录活性增加。
血浆采集与 EPINUC 分析
血液样本采集于 EDTA 管中,并在环境温度下转移进行处理。血浆通过离心分离,并储存于 −80 °C。
单分子成像的表面制备
PEG化生物素包被和 PEG化 poly(T) 包被的显微镜载玻片按此前所述方法制备28,29。简言之,玻璃盖玻片经过充分清洗(用丙酮和 Alconox 进行多轮超声处理),通过在 1 M KOH 中孵育进行羟基化,并用氨基硅烷化化学(3% 3-aminopropyltriethoxysilane,5% acetic acid in HPLC ethanol)进行钝化。表面功能化连同第一步钝化通过施加 mPEG: PEG化生物素/PEG叠氮溶液(10:1 比例)完成。PEG化表面再用 MS(PEG)4 进一步钝化。通过点击化学(10 µM 5′heyxynyl-dT50 (IDT),2 mM CuSO4)将 dT50 锚定到 PEG化 poly(T) 表面。
EPINUC 抗体标记
抗体使用生物素偶联试剂盒(Abcam,ab201796)和 Alexa Flour 抗体标记试剂盒(Thermo Fisher Scientific,A20181、A20183 和 A20186)按照制造商方案进行标记。标记抗体进一步使用 Bio-Spin 6 柱(Bio-Rad,7326200)通过尺寸排阻色谱纯化。抗体列于补充表 5a。
生物标志物的单分子成像
五种蛋白质生物标志物的定量按此前所述方法进行28。PEG化 poly(T) 包被的盖玻片组装到 ChipSop 流通池(chip 2-28 mini Luer platform Fl. 342,30001180)中,生成 14 通道流通池。将链霉亲和素溶液(0.2 mg ml–1,溶于 PBS)加入表面 15 分钟,并用 IMB2(10 mM MES pH 6.5、60 mM KCl、0.32 mM EDTA、3 mM MgCl2、10% 甘油、0.1 mg ml–1 BSA 和 0.02% Igepal)清洗。生物素化抗体在 IMB2 中于表面孵育 30 分钟,随后用 IMB2 清洗。接下来,将血浆样本加入流通池并在表面孵育 30 分钟,随后用 IMB2 清洗三次,以使靶蛋白结合。荧光标记抗体(检测抗体)引入表面 60 分钟,用 IMB2 清洗并成像。
成像在 Nikon 制造的 TIRF 显微镜(Eclipse Ti2-E LU-N4 TIRF)上进行,使用 CFI apochromat TIRF ×60 物镜,以及分别用于 488 mm、561 mm 和 647 nm 激光的 TRF49904、TRF49909 和 TRF89902 滤光块(Chroma)。图像以 ×1.5 放大设置拍摄,使用 Andor Zyla 4.2 Plus 相机,得到 148 µm × 148 µm 的
乳腺肿瘤中的表观遗传异质性为诊断和预后提供信息
血浆核小体按先前所述28并稍作修改进行处理。通过以下反应为核小体加 polyA 尾:将 20 µl 血浆与 10 µl 10× Green buffer(Enzymatics)、416 µM CoCl2(Enzymatics)、1:60 蛋白酶抑制剂混合物(Sigma)、83.3 µM dATP(Thermo Fisher Scientific)、5 µl Klenow Fragment(3′→5′ exo-,NEB)、3 µl T4 polynucleotide kinase(NEB)和 4 µl 末端脱氧核苷酸转移酶(TdT,Enzymatics)混合。在 37 °C 孵育 1 h 后,通过加入终浓度为 5 mM 的 EDTA 使样品中的 TdT 失活。
接下来,将含有加 polyA 尾的无细胞核小体的血浆样品与抗体(终浓度 1:60)在室温孵育 30 min,以形成抗体–无细胞核小体复合物。接下来,将样品加载到表面并孵育 15 min,使 polyA 尾与 dT50 寡核苷酸杂交。流动池用 IMB(12 mM HEPES pH 8(Thermo Fisher Scientific)、40 mM Tris pH 7.5(Gibco)、60 mM KCl(Sigma)、0.32 mM EDTA(Invitrogen)、3 mM MgCl2(Sigma)、10% 甘油(Bio-Lab)、0.1 mg ml–1 BSA(Sigma)和 0.02% Igepal(Sigma))洗涤一次,并通过在 IMB 中杂交 25 pM Cy3-dT23 至 polyA 尾的游离部分 10 min,使无细胞核小体可视化。我们向 Cy3-dT23 溶液中补充了 TetraSpeck 珠(Thermo Fisher Scientific),用作基准标记,以便在图像分析中校正载物台漂移。流动池用 IMB 洗涤一次,然后充满 IMB,随后使用 3 个激光通道在所有位置每 15 min 进行 5 个循环的延时成像。
成像在如上所述的 TIRF 显微镜上进行,每个泳道获得 100 个视野(148 µm2)的图像;或在 Epivision 的高通量单分子成像系统上进行,每个泳道获得 100 个视野(200 µm2)的图像。整个
为了实现跨独立处理的 EPINUC 队列之间的比较,我们采用了批次校正,以消除抗体标记程度上的差异。简言之,先将参考数据集进行下采样以平衡各组样本量,再计算各特征的均值与标准差。对独立处理的队列先做标准化,随后重新缩放,使其均值与方差与参考数据集相匹配。该方法使各队列间的特征分布得以对齐,同时保留了样本之间的相对差异。
通过质谱法定量组蛋白 PTMs
组蛋白按此前所述方法从 FFPE 组织中富集122。取约 4 µg 组蛋白八聚体,与等量的重同位素标记组蛋白(用作内标123)混合,并在 17% SDS–PAGE 凝胶上分离。切取组蛋白条带,用氘代乙酸酐进行化学酰化,并用胰蛋白酶进行胶内酶解124。样品经反相色谱分离,在 Q Exactive HF 仪器(Thermo Fisher Scientific)上采集数据,并按此前所述方法使用 MaxQuant 和 QualBrowser 进行分析124。对于每条组蛋白修饰肽段,分别估算样品(轻通道)或内标(重通道)的相对丰度百分比(%RA)值。随后计算 %RA 的轻/重比值(log2 转换),结果见 Supplementary Table 8。
报告摘要
有关研究设计的更多信息,请参见与本文关联的 Nature Portfolio Reporting Summary。