Newshot
- 广告排名模型正朝着 LLM 规模增长,其速度超过了运行它们所需的硬件跟进能力。额外的一单位算力对某些广告请求、模型和芯片的影响,比对另一些更大。挑战在于决定将其分配到何处,才能为整个系统带来最佳结果。
- 我们构建了 Intelligent Delivery,这是一个由 ML 驱动的系统,会跨服务栈分配资源,以朝着全系统最优目标推进。自 2017 年以来,它已在模型和系统进步之上带来约 10% 的增量排名性能。
- 我们正在分享 Intelligent Delivery 的几项能力:我们如何构建 ML 模型来预测算力的边际效用,如何在系统中跨层移动资源的多层机制,以及我们如何越来越多地利用代理式 AI 来持续检测并响应系统变化。
随着前沿广告排名系统朝着更大的模型、更广的候选集和更丰富的投放架构演进,它们也对服务效率提出了更高要求。算力资源的扩展速度跟不上模型和系统复杂度的增长速度。挑战不仅在于如何构建更强大的模型,还在于如何在异构系统中、在有限的服务容量下,并在严格的延迟预算内高效运行它们。我们最近分享了如何让闲置推理容量发挥作用。本文介绍我们如何决定每一单位算力去向何处,以实现全局最优的系统效率。
Intelligent Delivery 是我们应对该问题的方法,从 2017 年到 2026 年上半年,它已在模型和系统进步之上,为各主要场景的广告排名性能额外贡献了约 10% 的提升。它引入了一个由 ML 驱动、且日益由 AI 运营的自适应优化层,持续将资源导向具有最高边际效用的请求、模型、硬件集群和排名阶段。这帮助我们在生产中高效运行先进的广告排名模型,让每一单位算力发挥更大价值,为使用我们应用和服务的用户提供更好的广告。
目标与难点
我们的目标之一是创建一个投放系统,无论用户行为如何变化、模型如何演进、服务栈如何变得更复杂,它都能持续收敛到全局最优。
广告投放系统的三个基本特性使这一点颇具挑战:
算力的边际影响高度异质且依赖上下文:同样的额外一单位算力,可能因产品场景、用户意图、候选质量和系统状态不同而产生截然不同的回报。仅靠请求感知信号并不足够;要分配得好,就意味着要为每个请求估计每个可用可调系统参数的回报,而每个旋钮在漏斗的每个阶段表现都不同。我们需要在毫秒内跨庞大的决策空间完成逐请求的结果计算。
局部最优并不等同于全局最优:结果估计只是开始;服务栈还必须可动态控制。广告投放横跨多阶段排名、数百个模型、多代硬件和许多数据中心。如果没有能够考虑整个栈中复杂依赖关系的自适应控制,资源就无法在这些边界之间自由且可靠地转移。
全局最优是一个移动目标:优化景观持续变化。每一个新模型、新一代硬件或新架构都会改变这一景观,并可能使先前最优的分配决策失效。系统需要足够快地适应,以保持其最优性。
Intelligent Delivery 包含三项能力,每项能力都旨在应对上述一个基本系统挑战。
Intelligent Delivery 的能力
1. 请求理解:面向算力的共享 ML 智能层
有些广告请求比另一些更能从额外计算中获益。最初,我们通过粗粒度分群来捕捉这些差异:按展示面、上下文和广告创意表现形式等属性对请求分组,并由工程师为每个组制定资源分配策略。这种方法带来了改进,但无法扩展。每新增一个信号都会使规则成倍增加,使这项工作难以为继;而且相互独立的分群无法捕捉数千个信号之间的非线性交互,从而限制了准确性。
在将这一问题重新表述为两个机器学习问题之后,我们在主要展示面的离线基准测试中,相对于之前的生产模型,在识别影响最大的广告请求方面取得了约 20% 的提升:哪些广告请求最有可能从额外计算中获益?不同的资源配置将如何影响它们的结果和投放性能?
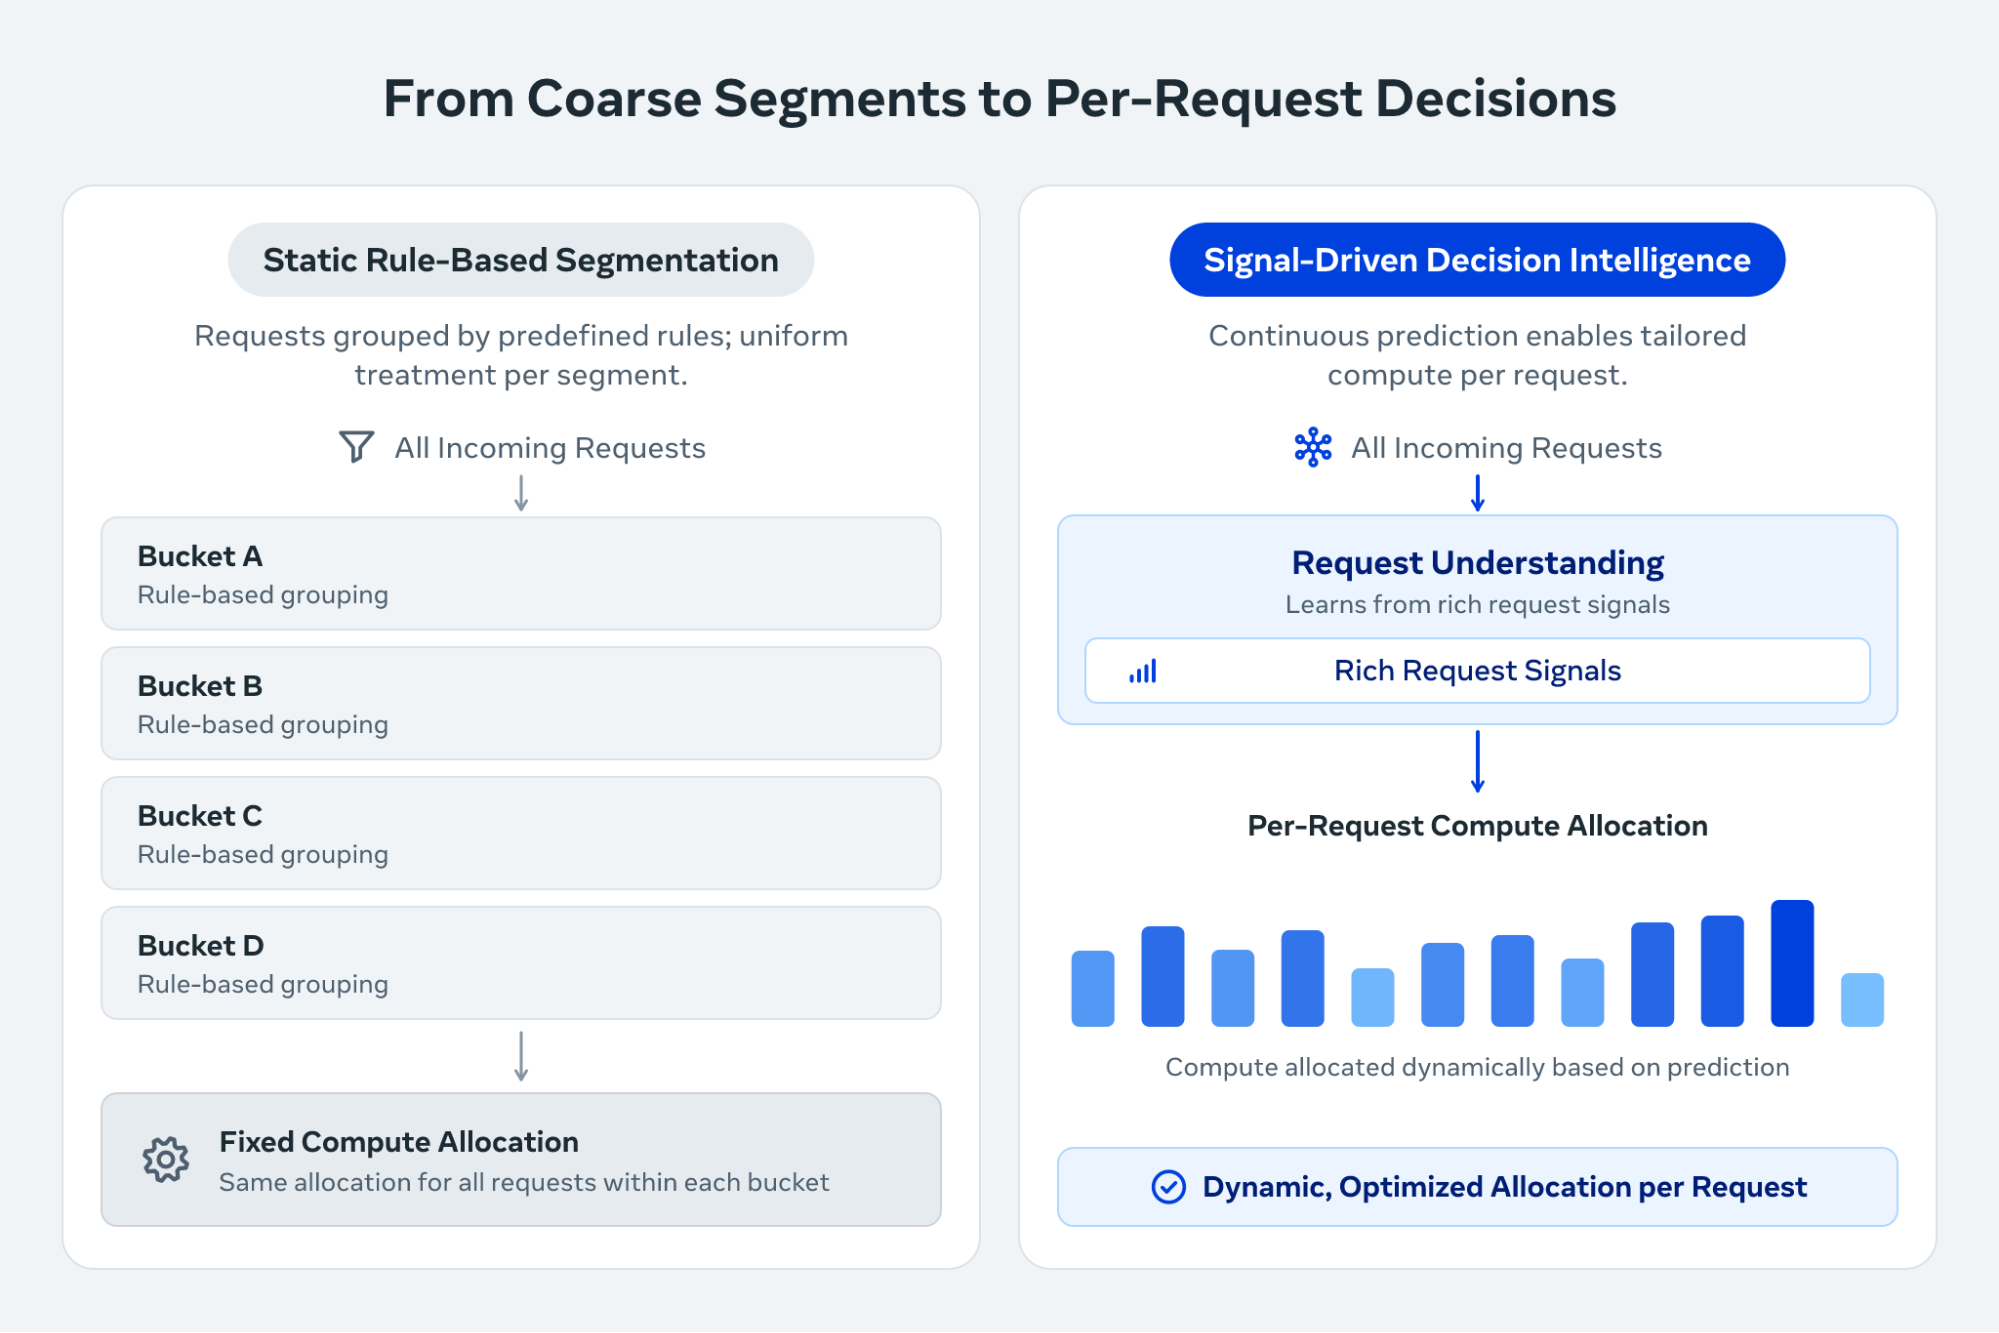
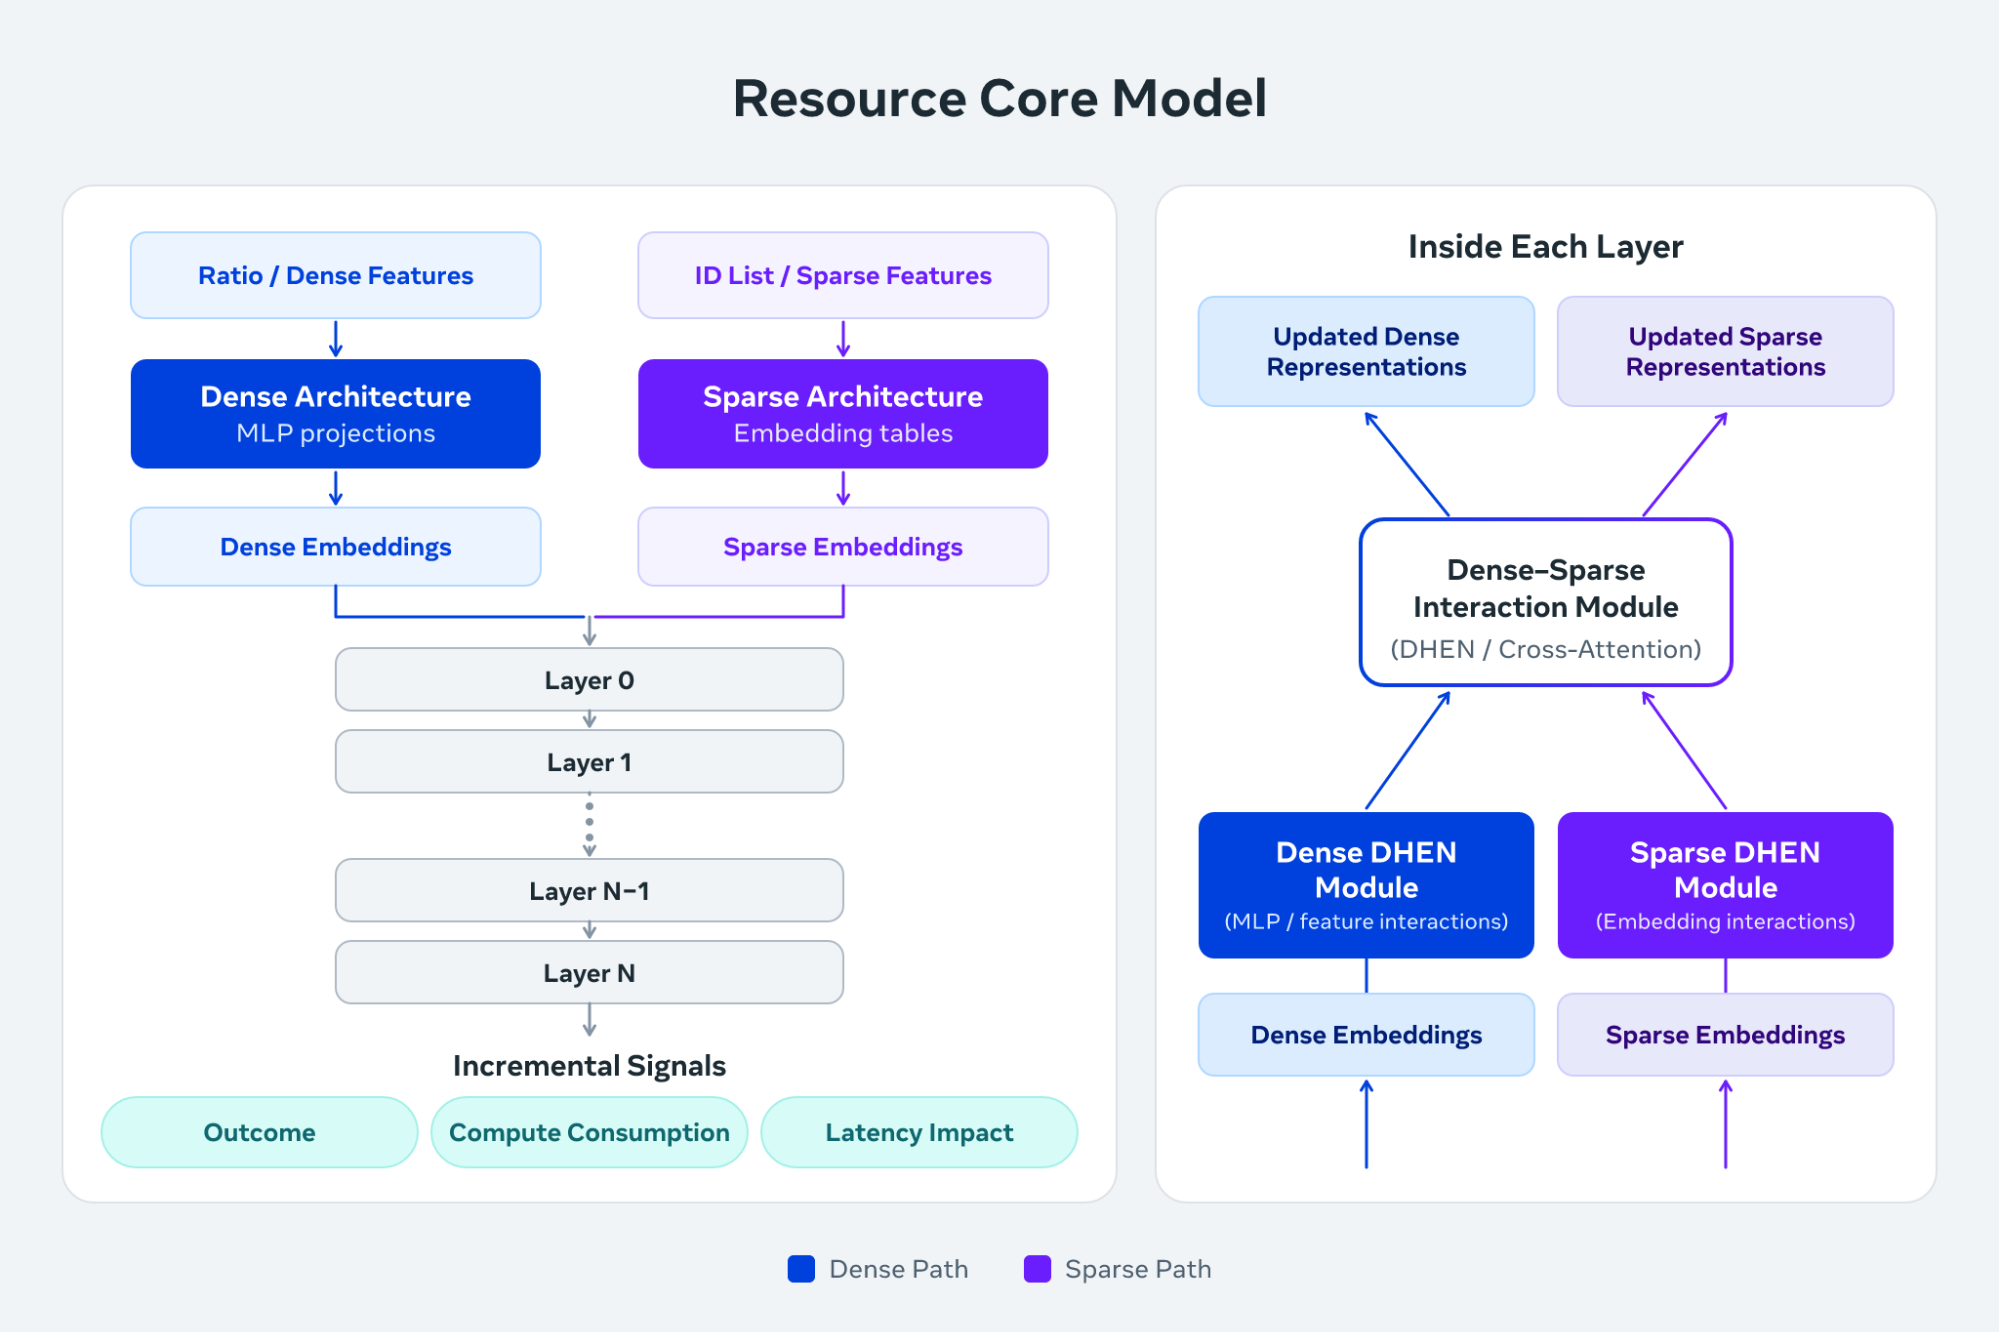
为了回答第一个问题,我们构建了 Resource Core Model。这是一组具有 6B 稀疏参数和 20M 稠密参数的深度学习模型,在候选召回之前运行一次,并在整个投放漏斗中共享。学习到的嵌入和深层特征交互能够捕捉人工定义分群无法捕捉的细微请求模式。
随后,我们将 Resource Core Model 微调为一组专用模型,每个模型都会生成关于结果、计算消耗和延迟影响的增量信号。它们共同构成用于资源分配的共享机器学习智能层:Resource Core Model 理解每个请求及其投放行为,而各个机制决定如何将这些预测转化为行动。
2. 分配机制:决策引擎的层级体系
广告投放运行在全球分布、异构的机群上,涉及众多数据中心区域、多代硬件和数百万台主机,所有这些都由一个多层级服务栈共享。单一分配机制无法端到端控制复杂的资源分布。因此,我们将问题分解为分层体系,并为每一层构建专门的决策引擎。了解这一层级体系最直观的方法,是跟随一个请求走完整个流程。
有人打开信息流。一个广告
Intelligent Delivery:让每一单位算力更好地服务广告
在主机内部,请求能获得这台机器的多少资源?在严格的尾延迟 SLO 下,并发请求在延迟预算和影响上各不相同。我们使用先进的深度学习模型实时预测每个请求的预期结果及其计算和延迟成本,并求解一个约束优化问题,以在主机延迟预算内
端到端实时优化:如今,理解一个请求和决定如何投放它仍是两个独立步骤。我们正朝着将它们融合为单一模型的方向构建,该模型读取请求并实时投放,无需数月实验。已有成熟工作使用基于学习的方法按请求调整计算量。然而,在流量变化、硬性容量限制和紧密的阶段间依赖下,同时在每个投放阶段联合执行——仍是尚未解决的部分,也是我们正在推进的方向。
在 GPU 上服务最先进的模型:大型排序模型,如 Meta 的 Generative Ads Model (GEM),正增长至 LLM 规模,并越来越多地运行在 GPU 上,这开辟了不同的优化空间。GPU 容量不像 CPU 时间那样划分——它以完整、固定的块形式提供,吞吐量、批处理和内存的表现都不同。我们为 CPU 世界构建的杠杆必须重新构想,现在我们的大部分工作都用于理解这些机制,并将它们转化为新的杠杆。我们从每个加速器获得的有效工作越多,在相同容量下就能用强大的模型服务越多的人。
致谢
Sowji Adavi、Karthik Alle、Tao Cai、Olivier Chaine、Jianhao Du、Antonio Frigo、Gayatree Ganu、Chao Li、Chao Ma、Bennet Matazzoni、Riddhi Mehta、Saurabh Pohnerkar、Sudhir Pokhrel、Yuehui Qian、Liang Qiao、Yitao Qiu、Rob Schwartzberg、Sanketh Shetty、Ganlin Song、Samuel Tatipamula、Xueqi Wang、Ye Wang、Wei Wei、Jing Xu、Haomin Yu、Jiayi Yu、Jay Zang、Caijie Zhang、Shengjie Zhang、Tong Zhang 以及 Wei Zheng。
分享此内容:
- 分享到 Facebook(在新窗口打开) Facebook
- 分享到 Threads(在新窗口打开) Threads
- 分享到 WhatsApp(在新窗口打开) WhatsApp
- 分享到 LinkedIn(在新窗口打开) LinkedIn
- 分享到 Reddit(在新窗口打开) Reddit
- 分享到 X(在新窗口打开) X
- 分享到 Bluesky(在新窗口打开) Bluesky
- 分享到 Mastodon(在新窗口打开) Mastodon
- 分享到 Hacker News(在新窗口打开) Hacker News
- 通过电子邮件将链接发送给朋友(在新窗口打开) Email
阅读更多 ML Applications 内容