Newshot
- Triton Low-Level Extensions (TLX) 是 Triton 的一个扩展,帮助工程师在保留 Triton 高效编程模型的同时优化 GPU 性能。
- TLX 引入显式的 warp-group 和 cluster 级编排,让开发者在不牺牲开发速度的前提下采用新的硬件能力。
- TLX 已在 RecSys 训练、RecSys 推理和大规模 LLM 预训练中展现出性能提升。
现代 GPU 架构越来越依赖面向执行的功能,例如 warp 特化、异步内存搬运、tensor memory 和 cluster 级执行,来优化自身性能。但同样的这些功能也暴露出面向控制的底层编程模型与面向生产力的高层编程模型之间日益扩大的差距。为弥合这一差距,我们构建了 Triton Low-Level Extensions (TLX),这一扩展让工程师能够显式控制 GPU 执行,同时保留 Triton 高效的编程模型。
如今,TLX 支撑着 Meta 内部的生产工作负载,从 AI 训练到大规模 LLM 预训练,使工程师能够快速采用新的硬件能力,而不牺牲开发速度。在 NVIDIA 和 AMD GPU 上,TLX 正在推进 GPU 性能的前沿——将最先进的 kernel 与显式执行编排和模型感知的融合相结合,带来超越单独库所能实现的端到端改进。
从 AI 模型到 GPU kernel
要理解 TLX 的定位,不妨追溯从 AI 模型到最终执行它的 GPU 指令的路径。在 Meta,机器学习(ML)工作负载构建在以 PyTorch 为中心的通用软件栈之上。模型代码经过图捕获、优化、编译和 lowering 转换,最终成为运行在大型加速器集群上的 GPU kernel。过去几年里,Triton 已从实验性的 kernel 语言演变为这一软件栈的基础组件。相当大比例的生产 GPU kernel——无论是编译器生成的还是手工优化的——如今都用 Triton 实现。因此,这一层的改进可以广泛传播到训练和推理工作负载中,使 kernel 性能成为提升端到端系统效率日益重要的杠杆。
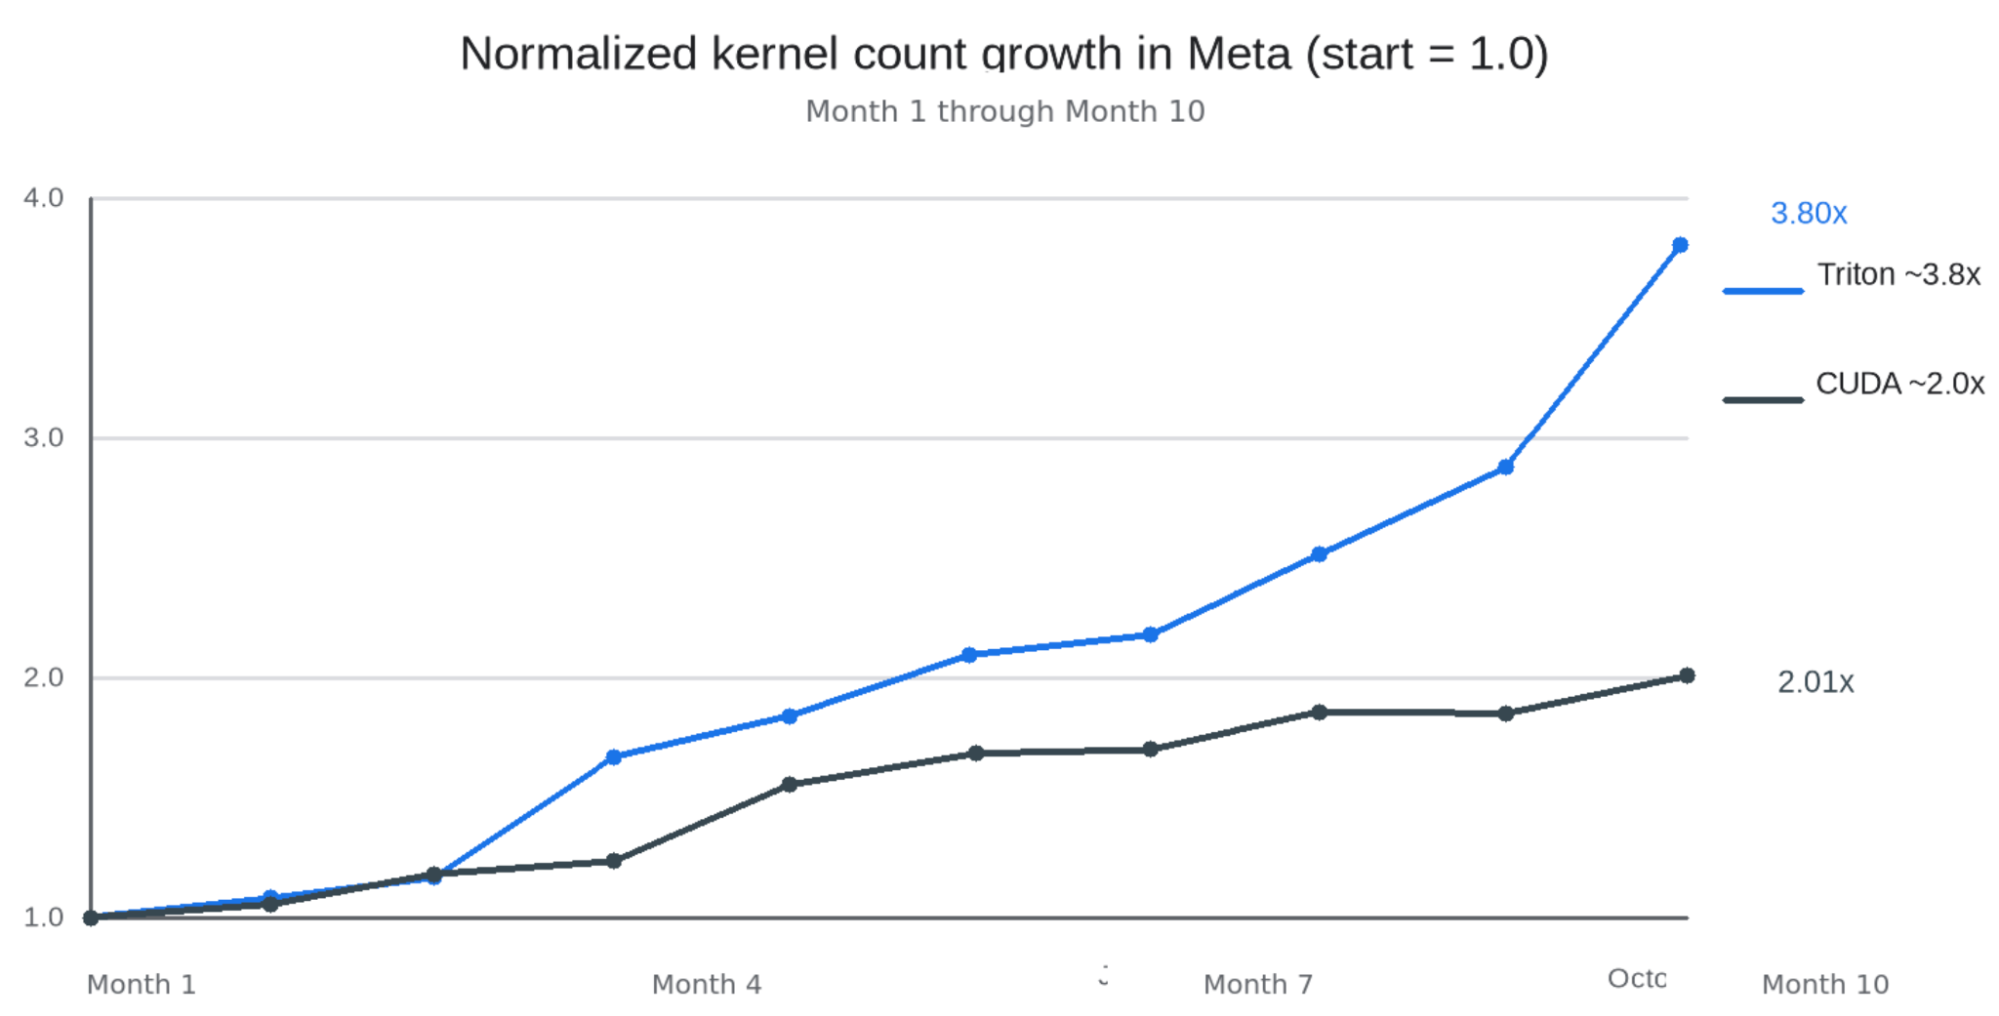
这一转变也改变了编写 kernel 的人。kernel 优化不再是 GPU 专家的专属领域。ML 工程师日常会分析方法负载、识别瓶颈,并通过自动调优、融合、内存布局改进或算法重构来优化最热的 kernel。Triton 的高效性让其中许多迭代能在数小时而非数天内完成,使工程师能够紧贴模型开发流程。因此,GPU kernel 开发日益成为 ML 工程师标准优化工具箱的一部分。
Triton 已经通过融合和编译器管理的内存访问优化,为许多受内存带宽限制的工作负载提供了高效的基础。在这些优势之上,TLX 解决的是一个互补性的挑战:在现代 GPU 上协调执行组、异步数据搬运和共享资源。
问题:当硬件演进快于编程模型
尽管 Triton 极大提升了开发者生产力,但现代 GPU 架构的演进方式越来越强调执行编排,而不仅仅是计算本身。NVIDIA 的 Hopper 引入了 warp specialization 和 Tensor Memory Accelerator(TMA)。NVIDIA 的 Blackwell GPU 通过 Tensor Memory(TMEM)、集群级执行、成对 CTA 执行以及日益异步化的执行机制,进一步扩展了这一趋势。这些能力并非只是可以隐藏在编译器优化背后的新指令,它们从根本上改变了高性能 kernel 的组织方式。
例如,一个现代 FlashAttention kernel 可能让一个 warp group 专门负责发出 TMA 传输,而另一个 warp group 执行 tensor-core 计算。一个 Blackwell GEMM kernel 可能同时协调多个 warp group、TMEM 分配和集群资源。在这两种情况下,性能不仅取决于所执行的计算,还取决于多个执行代理如何协同工作。
当我们在 Meta 的 ML 基础设施中采用 Hopper 和 Blackwell 时,反复遇到同一个挑战:CUDA 能够表达这些执行结构,但往往需要大量架构特定的编排代码。Triton 提供了生产力显著更高的编程模型,但现代硬件所需的许多执行关系仍隐藏在编译器抽象之后。
结果就是日益严重的编译器追赶问题。每一代新硬件都会引入新的执行能力,而程序员要么等待编译器支持到位,要么退回到越来越专用的实现中。我们意识到,挑战并不只是缺少编译器特性,而是缺少合适的编程抽象。
缺失的中间层:为什么 SIMT 和 SIMB 不够用
在最新 GPU 上最重要的能力,既不在线程粒度上运行,也不在 block 粒度上运行。warp specialization 将工作划分到协同工作的 warp group 上。TMA 引入了专门负责内存移动的代理。TMEM 支持执行组之间新的通信模式。集群执行让多个 CTA 能够在共享执行上下文中协作。围绕这些特性组织 kernel,意味着要推理多个执行代理如何协作、通信和同步——这是一种介于 CUDA 和 Triton 之间的结构层次。
这揭示了我们逐渐视为缺失的抽象。CUDA 的 SIMT 模型运行在过细的粒度上:它提供完全控制,但要求开发者手动表达每一种执行关系。Triton 的分块编程模型运行在过粗的粒度上:它提升了生产力,但把许多执行结构变成了编译器的隐式决策。现代硬件越来越需要介于两者之间的东西。
我们将这种模型称为 Multiple Instructions, Multiple Warps(MIMW)。MIMW 将 warp group 提升为编排的基本单元。程序员不再需要推理单个线程或整个 block,而是表达多个执行代理如何协作、通信、同步和共享资源。这是表达许多 Hopper 和 Blackwell 优化时的自然层次,也是 TLX 实现的抽象层。
图 2 展示了 GPU 编程模型的演进。CUDA 的 SIMT 模型直接在线程粒度上暴露执行,使开发者完全控制调度、同步和内存移动。Triton 转向 SIMB 模型,将抽象提升到分块张量计算,并提高了生产力。MIMW 占据这两个极端之间的空间。它不再把线程或张量块视为主要执行抽象,而是将 warp group 提升为一等执行代理。
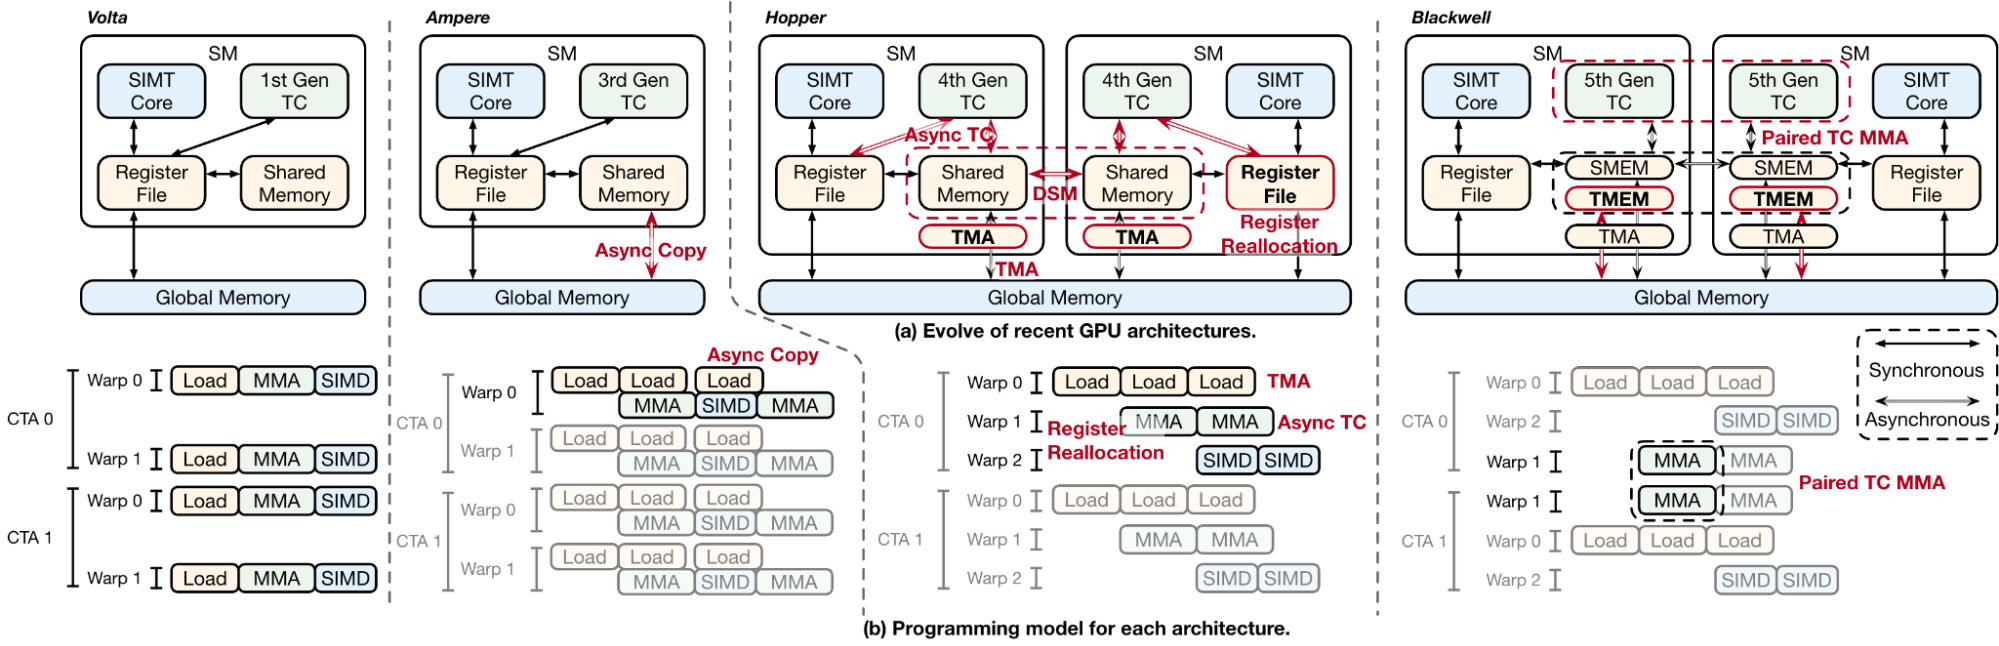
MIMW 的出现并非软件设计偏好,而是硬件演进方式的结果。Volta 和 Ampere 通过线程级和 warp 级编程将张量核心暴露出来。Hopper 使异步数据移动(由 TMA 支持)和 warp 组执行(由 WGMMA 支持)成为高性能内核的核心。Blackwell 通过 TMEM、寄存器重分配、cluster 执行和 paired-CTA MMA 进一步扩展了这一趋势。每一代都将更多跨 warp 组的协作——有时是跨 CTA 的协作——推入编程模型(而不仅仅是编译器)必须处理的领域。
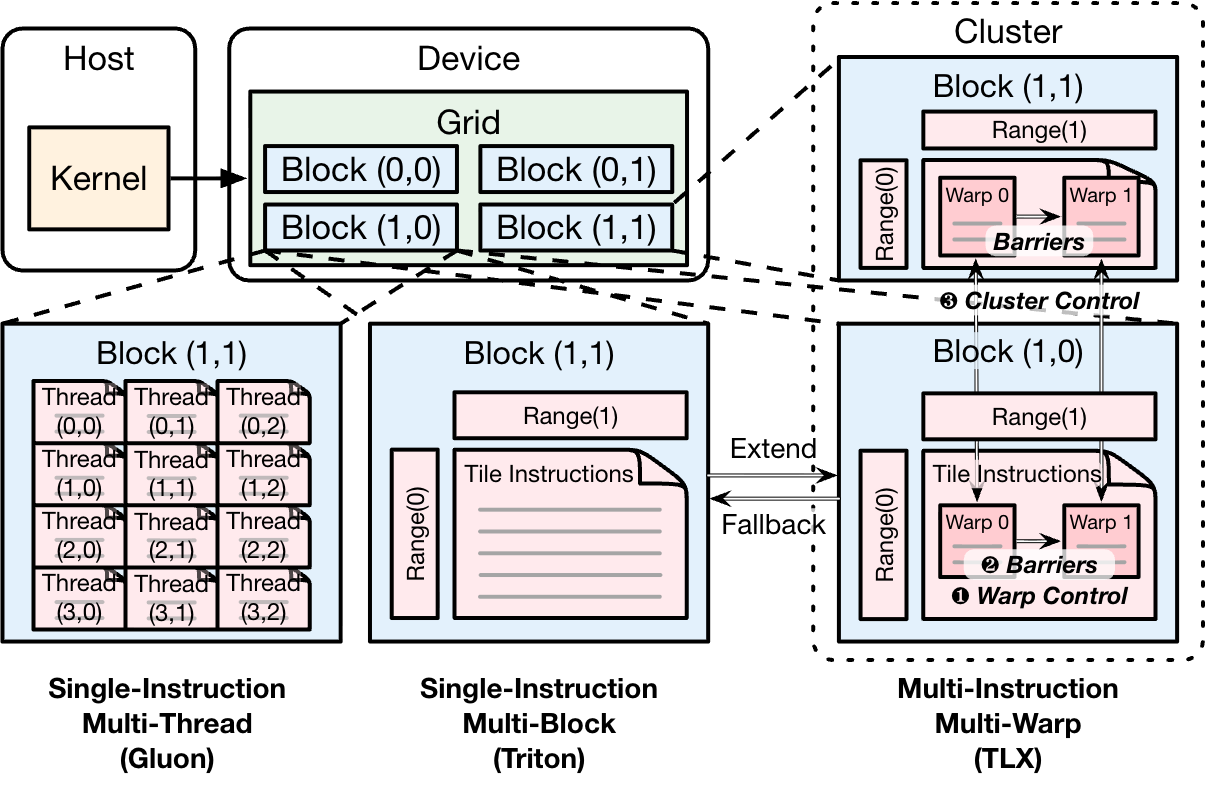
让 MIMW 变得实用,需要将协作的 warp 组或 wave 组表达为一等执行任务,并显式控制共享内存缓冲区访问、同步以及它们之间的交接。TLX 将这些能力引入 Triton 现有的张量编程模型,让开发者能够将显式执行控制与熟悉的高层张量操作结合起来。
介绍 TLX:缺失的中间层,已实现
我们希望避免用 TLX 创建又一个独立的底层语言。相反,TLX 通过第二层面向执行的构造来扩展 Triton。程序员继续使用熟悉的 Triton 张量操作来表达计算,而 TLX 仅在需要对执行、内存移动或同步进行显式控制的地方使用。换句话说,Triton 回答应该执行什么计算,而 TLX 回答该计算应该如何编排。通过一个简单的分块矩阵乘法最容易看出区别。在标准 Triton 中,执行遵循同步的加载-计算循环:每个 tile 被加载、消费,然后在下一个 tile 开始之前被丢弃。
        # Standard Triton: synchronous load-compute loop semantics,
# with compiler-managed software pipelining
@triton.jit
def matmul_kernel(a_ptr, b_ptr, c_ptr, M, N, K, ...):
    pid_m = tl.program_id(0)
    pid_n = tl.program_id(1)
    acc = tl.zeros((BLOCK_M, BLOCK_N), dtype=tl.float32)
    for k in range(0, K, BLOCK_K):
        a = tl.load(a_ptr + ...)   # Load A tile from global memory
        b = tl.load(b_ptr + ...)   # Load B tile from global memory
        acc += tl.dot(a, b)        # Compute matmul
    tl.store(c_ptr + ..., acc)
TLX 保留相同的计算,但使执行结构显式化。生产者 warp 组异步移动数据,消费者 warp 组执行张量核心计算,同步通过轻量级屏障直接表达。计算本身仍然是 Triton;只有编排层发生变化。结果是一个深度流水化的内核,无需离开 Python 或牺牲 Triton 的自动调优基础设施,就能重叠内存移动、计算和输出处理。更重要的是,执行结构在源代码中可见,而不是隐藏在编译器启发式内部。
        # TLX on Blackwell: explicit warp-group orchestration and pipelining
@triton.jit
def matmul_kernel(desc_a, desc_b, desc_c, M, N, K, ...):
    buffers_a = tlx.local_alloc((BLOCK_M, BLOCK_K), tl.float16, NUM_STAGES)
    buffers_b = tlx.local_alloc((BLOCK_K, BLOCK_N), tl.float16, NUM_STAGES)
    acc = tlx.local_alloc((BLOCK_M, BLOCK_N), tl.float32, 1, tlx.storage_kind.tmem)
    load_bars = tlx.alloc_barriers(num_barriers=NUM_STAGES, arrive_count=1)
    dot_bars  = tlx.alloc_barriers(num_barriers=NUM_STAGES, arrive_count=1)
    with tlx.async_tasks():
        # Warp group 0: PRODUCER — async TMA loads into shared memory
        with tlx.async_task("default"):
             # Wait for last matmul
            tlx.barrier_wait(dot_bars[num_k_tiles - 1], phase)
            result = tlx.local_load(acc[0])
            desc_c.store(offsets, result.to(tl.float16))

        # Warp group 1: CONSUMER — tensor-core matmul from shared memory
        with tlx.async_task(num_warps=1):
            for k in range(num_k_tiles):
                buf = k % NUM_STAGES
                 # Wait for TMA load to complete
                tlx.barrier_wait(load_bars[buf], phase)
                tlx.async_dot(buffers_a[buf], buffers_b[buf], acc[0],
                              use_acc=(k > 0), mBarriers=[dot_bars[buf]])

        # Warp group 2: EPILOGUE — store result to global memory
        with tlx.async_task(num_warps=1):
            for k in range(num_k_tiles):
                buf = k % NUM_STAGES
                 # Wait for consumer to release buffer
                tlx.barrier_wait(dot_bars[buf], phase)
                tlx.barrier_expect_bytes(load_bars[buf], ...)
                tlx.async_descriptor_load(desc_a, buffers_a[buf], offsets, load_bars[buf])
                tlx.async_descriptor_load(desc_b, buffers_b[buf], offsets, load_bars[buf])
TLX 在五个关键方面扩展了 Triton:
Warp 组编排:TLX 将 warp 组视为一等执行代理。程序员可以为协作的 warp 组分配明确角色——例如,负责搬运数据的生产者 warp 组、执行 tensor core 计算的消费者 warp 组,以及处理结果的收尾 warp 组。
同步:TLX 在 warp 组级别而非线程级别暴露同步。程序员使用 mbarriers 等硬件原语,表达协作执行组之间的依赖关系——例如软件流水线中的生产者-消费者关系。细粒度的线程级同步仍由底层执行模型和编译器处理,让开发者专注于协调更大粒度的执行结构,而这些结构正日益决定现代 GPU 上的性能。
内存编排:TLX 提供对 TMA、异步 tensor core 操作和 TMEM 等硬件能力的直接访问。这些原语让内存搬运与计算能在程序定义的执行结构内自然重叠,同时避免 CUDA 中通常需要的大量底层设置和簿记工作。
Cluster 执行:TLX 将 cluster 级执行暴露为一等编程构造。多个 CTA 可以通过分布式共享内存和 cluster 级同步原语协作,从而实现原本需要往返全局内存的片上通信模式。
可选布局:与 CUDA 和 CUTLASS 不同,TLX 不要求程序员在表达计算之前显式指定布局。编译器会自动推断合理的默认值,程序员仅在出于性能原因想要覆盖时才指定布局。因此,即使没有任何布局标注,也能写出正确的 kernel,并在优化过程中逐步引入布局调优。
一个重要结果是,内核融合变得显著更容易。融合是最有效的 GPU 优化之一,因为它消除了中间内存流量和内核启动开销。然而,在传统 CUDA 风格的工作流中,融合往往被布局管理所主导。每个阶段可能假设不同的 tiling、swizzling 或共享内存映射,迫使程序员在操作边界之间手动协调布局。
由于 TLX 自动推断布局,操作通常可以在不手动协调中间布局的情况下融合。编译器在可能的情况下解决布局兼容性,程序员仅在特定布局选择能提升性能时介入。这显著降低了构建复杂融合内核所需的工程资源,并支持原本需要多个内核或大量布局专用基础设施的多阶段流水线。
综合来看,这些能力使 TLX 占据 Triton 的生产力与 CUDA 的控制力之间的空间。开发者保留了 Python、自动调优和分块张量编程的优势,同时可以直接访问在现代 GPU 上越来越决定性能的执行结构。
TLX 在生产中:实际影响
过去几个月,我们一直在 Meta 的 ML 基础设施中生产运行 TLX。三个部署——涵盖 RecSys 训练、RecSys 推理和大规模 LLM 预训练——突出了 TLX 所支持的不同方面。
| 案例研究 | 硬件 | TLX 解决的问题 | 主要结果 | 部署 |
|---|---|---|---|---|
| GEM 模型训练 | NVIDIA Blackwell | 在异构 RecSys 基础模型上达到 roofline MFU 需要 warp specialization 和超出标准 Triton 的显式 tensor-memory 控制。 | 在数千个 GPU 上达到 20-25% E2E MFU | GEM 训练栈。 |
| 内核内广播优化 (IKBO) | NVIDIA Hopper | 用户特征在每个候选批次中被复制多次,浪费带宽和计算;消除它需要 warp-specialized 多阶段融合。 | 对于协同设计的模型,在计算密集型延迟中实现最高 2/3 的净延迟降低。 | RecSys 推理,早期→晚期排序,GPU。 |
| 用于 LLM 预训练的分布式分组 GEMM | NVIDIA Blackwell | 专家并行 MoE 层需要带有节点间通信的分组 GEMM;现有实现在大规模下留下了性能空间。 | 在较长时期内于大规模集群规模上通过生产验证。 | LLM 预训练。 |
案例研究 1:GEM 模型训练
训练 Meta 的生成式广告模型 (GEM) 比 LLM 训练更难优化,因为更小的输入形状、每层 10+ 个 norms、异构模块类型和架构多样性都限制了 MFU。通过跨越模型架构、自定义内核、编译器优化和硬件特定调优的系统性模型-内核协同设计方法,最新版本的 GEM 训练在数千个 NVIDIA Blackwell GPU 上达到了 O(10^24) 总训练 flops,E2E MFU 为 20-25%。
TLX 在多 DSL 策略中的作用
我们在 Blackwell 上评估了三种编程模型——CUTLASS、CuTeDSL 和 TLX——并发现 TLX 为大多数内核提供了生产力与性能之间的最佳平衡。它结合了类似 Triton 的简单性、自动调优和可组合性,并可直接访问 Blackwell 特定的能力,例如 async_dot、tensor memory 操作和 mbarrier 同步。
对于 Generalized Dot Product Attention (GDPA)——GEM 中的一个内核——TLX 以一小部分实现复杂度就达到了接近最优的性能,并通过将模型众多类注意力操作统一到单个 GPU 内核中,带来最高 2 倍的前向加速,从而加速训练。尽管不同内核有不同要求,但事实证明,对于大多数同时看重开发者速度和性能的 GEM 工作负载而言,TLX 是正确的抽象。
TLX 使我们能够超越优化单个内核,转向将模型更大部分内核化并进行融合。对于 GEM 工作负载,减少内存移动通常比单纯优化计算带来更大收益,这使得可组合性和融合成为一等关注点。为加速这一过程,我们构建了 Agent for Compute Efficiency (ACE),一个 AI 辅助优化框架,可自动化性能剖析、分析和调优。ACE 缩短了单个内核的优化周期,让工程师能够专注于更高层次的优化机会,而不是低层性能调试。
案例研究 2:面向 RecSys 的内核内广播优化
在 RecSys 推理中,用户特征在所有被打分的候选对象之间完全相同,但它们通常会在每个批次中被复制数十次,以匹配候选维度。在广泛的候选到用户广播比例范围内验证后,这种广播成为浪费内存带宽和计算的重要来源,其开销随候选数量线性增长。
In-Kernel Broadcast Optimization (IKBO) 通过将广播移入内核本身来消除这一低效问题。内核不再物化复制后的用户特征,而是以用户和候选输入各自自然且不匹配的批次大小来消费它们,并在计算过程中隐式执行广播。这种方法通过模型架构、推理运行时和内核实现的协同设计而成为可能。
TLX 为该优化的最终阶段提供构建模块
以我们的线性压缩内核为例。经过一系列优化——包括 matmul 分解、内存对齐和广播融合——剩余瓶颈通过一个 warp 特化的多阶段 TLX 内核得到解决,该内核在 NVIDIA H100 上带来 4 倍加速。最终实现将整个计算折叠进单个持久化巨型内核。生产者与消费者 warp 组使用乒乓调度并发执行,而用户和候选 GEMM 共享环形缓冲区,并通过 mbarriers 同步,且不会在阶段之间排空流水线。Tile 级 release-acquire 同步进一步实现了跨 CTA 的协调。
对于 FlashAttention,IKBO 协同设计通过在共享同一用户上下文的候选之间分摊 K/V 读取,将内核从 I/O 受限转变为计算受限。随后,TLX 叠加 FA3 风格的 warp 特化与持久化,消除在 RecSys 短查询长度下占主导的跨 CTA 启动停顿,并为协同设计的模型带来计算密集型净延迟最高减少三分之二。直接在 CUDA 中表达这种执行结构需要大量手动编排;TLX 允许在 Triton 的 Python 编程模型和自动调优框架中简洁地表达它。
如今,IKBO 帮助在 GPU 和 Meta Training and Inference Accelerator (MTIA) 上优化 Meta 的 Adaptive Ranking Model。更广泛地说,它说明了我们处理 RecSys 推理方式的转变。我们不再围绕广播开销进行优化,而是在计算原语本身将其消除,从而无论候选数量多少都能实现稠密交互质量。
案例研究 3:面向 LLM 预训练的分布式分组 GEMM
我们如何构建 TLX:面向大规模生产机器学习的硬件原生 GPU 编译器
TLX 的生产影响不仅限于推荐负载。一个基于 TLX 的分布式分组 GEMM 内核目前部署在 Meta 的大规模 LLM 预训练基础设施中,在较长训练周期内,它已在庞大的 GPU 集群上持续运行。该内核加速了混合专家(MoE)模型所需的分组矩阵乘法,同时紧密集成计算与通信,以降低端到端延迟。
在这种规模下,峰值吞吐量只是问题的一部分。可靠性、可调试性和长期性能稳定性同样重要。生产内核必须在数周连续运行中保持性能,同时在模型、硬件和系统软件演进时仍可维护。
TLX 被证明特别适合这种环境。它对 warp-specialized 执行、显式内存编排和异步流水线的支持,实现了大规模分布式训练所需的性能特征。同时,它与 Triton 的 Python 编程模型集成,保留了以生产速度迭代、验证和部署复杂内核所需的开发者生产力。
这次部署凸显了 TLX 设计哲学的一个重要方面:它并非仅仅为了达到内核峰值性能,而是为了让先进硬件能力能在真实生产系统中实际采用。
深入了解 TLX 内核
如需更深入地技术了解 TLX 内核,请参阅我们配套的 PyTorch 博客文章:
- 内核内广播优化:为 RecSys 推理协同设计内核。
- TLX Block Attention:面向固定块稀疏自注意力的 Warp-Specialized Blackwell 内核。
- 快速 2-Simplicial Attention:TLX 中的硬件高效内核。
- 使用 TLX 启用 Cluster Launch Control。
- 实现 Free Normalization:通过 TLX 将 Norm 融合进 GEMM 和 Attention。
- 使用 TLX 优化 Jagged Flash Attention:通往 Blackwell 上 SOTA FA4 之路。
- 使用 TLX 优化 CDNA4 上的 GEMM + 激活。
我们学到了什么:构建 GPU 编译器的建议
从真实工作负载开始,而非基准测试
我们构建 TLX 是为了解决 Meta 的实际生产问题,而不是赢得基准竞赛。GEM MFU 项目和 IKBO 都体现了这一原则。两者都始于具体的痛点(GEM 中 MFU 低、RecSys 中广播开销),随后才构建工具。这种专注让我们始终面向真实世界性能,而非合成分数。
生产力与性能是乘数,而非权衡
TLX 通常能提供与手工调优 CUDA 性能相当的性能,但工程师可以显著更快地迭代。一个略快但编写时间三倍的内核在集群规模上是净损失。对于 GEM,多 DSL 方法让我们选择 TLX 以快速迭代;对于 IKBO,基于 TLX 的实现耗时数周而非数月。
硬件特性只有在可访问时才有用
WGMMA、TMA 和 TMEM 是强大的能力,但由于编程模型过于复杂,它们很少被使用。TLX 通过简洁的注解使它们可访问。IKBO 中的 warp-specialized 融合和 GEM 中的多 DSL 内核若用原生 CUDA 实现,会复杂到令人望而却步。
编译器是用户界面的一部分
错误消息、调试支持和性能分析集成与代码生成质量同样重要。我们在开发者体验上的投入与在优化器上的投入一样多。当 GEM 工程师调试 MFU 问题,或 IKBO 工程师遇到 warp-group 同步问题时,他们需要清晰的反馈,而不是晦涩的编译器错误。
演进胜过革命
通过将 TLX 构建为 Triton 的扩展,我们利用了现有的生态系统、工具和专业能力。GEM 团队可以将 TLX 与 CUTLASS 和 CuTeDSL 一起使用;已经熟悉 Triton 的 IKBO 团队只需学习针对性能关键部分的 TLX 注解。从零开始的设计可能更优雅,但可能永远无法发布。
TLX 的下一步
TLX 正在更进一步。以下是我们正在开展的工作:
- 更多硬件:目前,TLX 面向 NVIDIA Hopper 和 Blackwell,以及 AMD Mi300 和 Mi350x。我们正在努力支持更多架构,包括 NVIDIA 和 AMD 的新一代架构,以及像 MTIA 这样的定制加速器。MIMW 模型与硬件无关——挑战在于将其高效地映射到不同的 ISA。GEM 已经在 GPU 和 MTIA 上运行,IKBO 则横跨 GPU 和 MTIA。
- 更高层抽象:TLX 让开发者可以控制 warp 组。接下来,我们希望再次提升抽象层级——从更高层模式中自动推断 warp 组编排。设想一种为你编写注解的“auto-TLX”。我们从 GEM(多 DSL 选择)和 IKBO(三阶段 warp 特化)中学到的模式,都是自动化的候选对象。
- 与 PyTorch 2.x 集成:我们正在努力让 TLX 成为 torch.compile 的后端。愿景是编写 PyTorch 代码,并自动获得经 TLX 优化的 kernel,常见模式无需手动注解。GEM 展示了系统性协同设计所能实现的能力,IKBO 则展示了针对特定模式优化的价值。我们希望让两者都实现自动化。
缺失的中间层确实存在,而且不仅限于 GPU。随着加速器变得越来越复杂,我们需要在不牺牲生产力的前提下,提供恰到好处控制力的编程模型。TLX 是我们朝这个方向迈出的第一步。
致谢
TLX 是 Meta 内部 Triton、PyTorch、MSL、Ads Training Infra、Ads Ranking、RecSys 和 AI Compilers 团队共同合作的成果。我们感谢以下人员所作的贡献:
Triton:Shane Nay、Manman Ren、Oleksandr Stashuk、Karthik Manivannan、Zhijing Li、Yuanwei Fang、Shunting Zhang、Arda Unal、Yueming Hao、Taylor Robie、Puyan Lotfi、Corbin Robeck、Bert Maher、Alexey Loginov、Ying Liu、Bill Yoshimi。
PG:Jackie Xu、Jacky Zhou、Han Xu、Hao Yan、Jake Siso、Devashish Shankar、Shikai Li、Jianyu Huang、Andrew Tulloch、Boda Li、Jiao Jian、Zhuoran Zhao、Ao Cai、Shuyao Bi、Yuanjuan Yao、Ruizhen Guo、Doris Xiang、Jason Lu、Marvin Fan、Hai Zheng、Zhaokang Ke、Albert Chen、Mingyu Guan
UCSD:Yufei Ding 和 Yue Guan。
分享此内容:
- 在 Facebook 上分享(在新窗口打开) Facebook
- 在 Threads 上分享(在新窗口打开) Threads
- 在 WhatsApp 上分享(在新窗口打开) WhatsApp
- 在 LinkedIn 上分享(在新窗口打开) LinkedIn
- 在 Reddit 上分享(在新窗口打开) Reddit
- 在 X 上分享(在新窗口打开) X
- 在 Bluesky 上分享(在新窗口打开) Bluesky
- 在 Mastodon 上分享(在新窗口打开) Mastodon
- 在 Hacker News 上分享(在新窗口打开) Hacker News
- 通过电子邮件将链接发送给朋友(在新窗口打开) 电子邮件
阅读更多开源内容