Newshot
Account

推出我们最小、最高效的模型:Muse Ember

AI summary

Meta AI 在 Claude Haiku/GPT Luna 这一档位推出了 Muse Ember,称其是自家最小、最高效的模型,面向复杂推理执行以及智能体全天重复的工作:工具调用、编码子任务、路由、抽取和长文档解析。短提示下其定价与 GPT-6 Luna、Claude Haiku 5.5 相同,均为每百万输入 token 0.10 美元、每百万输出 token 0.50 美元,而同日的 Claude Fable 5.2 价格是它们的 80 倍(8/40 美元)。三者都支持最多一百万输入 token,但超过各自阈值后价格会上涨;计入阈值后,Ember 的定价介于另外两者之间。

Translation(model translation, not the source's own text)

2026 年 11 月 10 日 - Link Blog

推出我们最小、最高效的模型:Muse Ember。Meta AI 刚刚发布了他们在 Claude Haiku/GPT Luna 这一档的产品:Muse Ember,他们这样描述它:

[...] 我们最小、最高效的模型,专为复杂推理解答以及 agent 整天重复的工作而设计:工具调用、编码子任务、路由、抽取,以及长文档解析。

对于较短的 prompt,它的定价与 GPT-6 Luna 和 Claude Haiku 5.5 相同——两者都是每百万输入 token $0.10、每百万输出 token $0.50。今天另一个重要模型发布 Claude Fable 5.2,价格是它们的 80 倍,为 $8/$40。

不过当 prompt 变长时,定价就没那么直接了。Luna、Ember 和 Haiku 都支持最高一百万输入 token,但它们也都有一个阈值,超过后价格会上涨。把这个阈值考虑进去,Ember 的定价介于另外两者之间:

模型Prompt 长度输入($/M)缓存输入输出
GPT-6 Luna≤272k$0.10$0.01$0.50
>272k$0.20$0.02$0.75
Muse Ember 1.0≤200k$0.10$0.004$0.50
>200k$0.30$0.012$1.50
Claude Haiku 5.5≤100k$0.10$0.01$0.50
>100k$0.50$0.05$2.50

但如今比较每 token 的价格其实意义不大,因为 reasoning token 意味着不同模型解决同一个问题可能使用截然不同数量的 token。

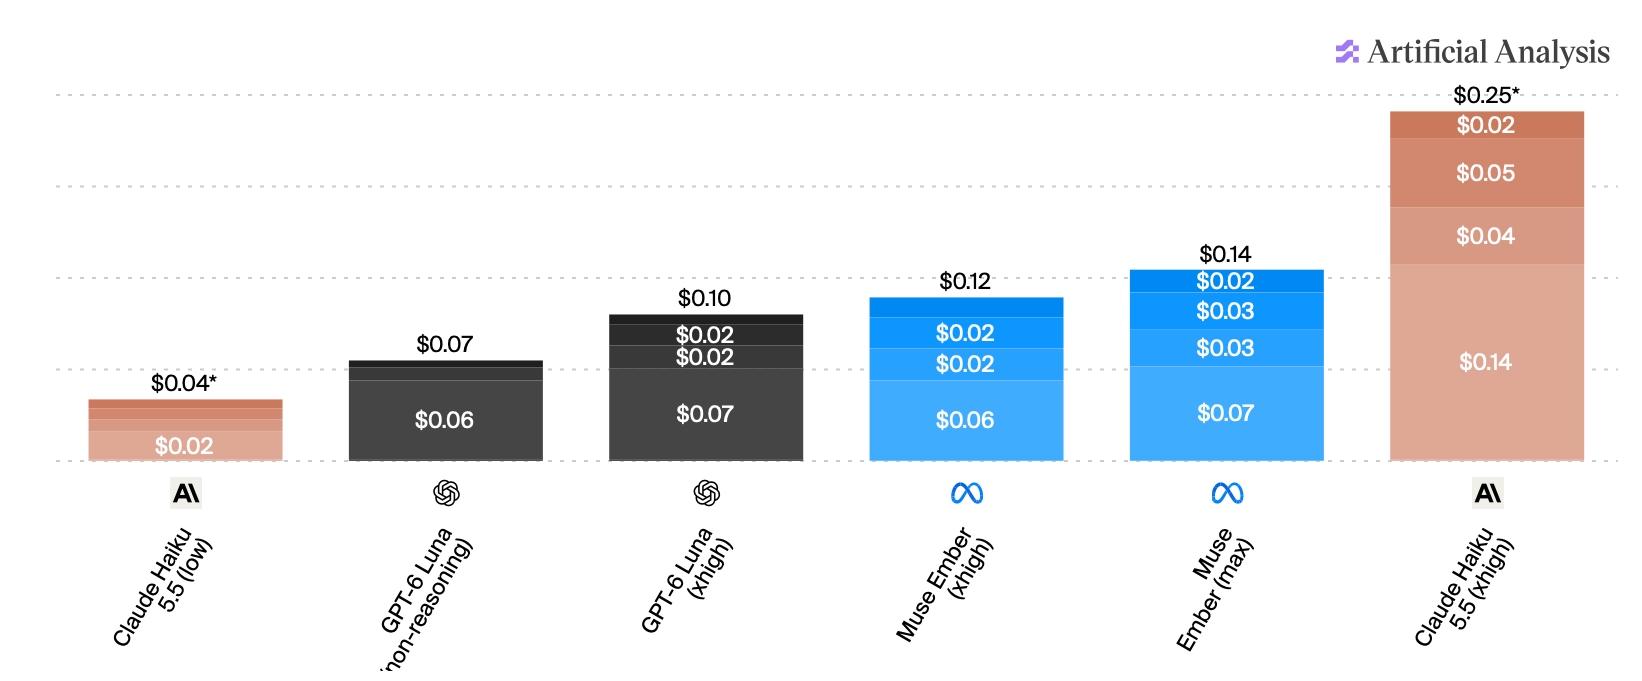
为此,一个有用的指标是 Artificial Analysis。

Artificial Analysis 的堆叠条形图,比较六个模型以美元计的成本,每根条形分为四段未标注的堆叠区段,按总额从低到高排序。Claude Haiku 5.5 (low):总计 $0.04*,底部区段 $0.02,其上是三段细的未标注区段。GPT-6 Luna (non-reasoning):总计 $0.07,底部区段 $0.06,其上是细的未标注区段。GPT-6 Luna (xhigh):总计 $0.10,从底部起各区段为 $0.07、$0.02、$0.02,外加一小段未标注的顶部区段。Muse Ember (xhigh):总计 $0.12,从底部起各区段为 $0.06、$0.02、$0.02,外加一小段未标注的顶部区段。Muse Ember (max):总计 $0.14,从底部起各区段为 $0.07、$0.03、$0.03、$0.02。Claude Haiku 5.5 (xhigh):总计 $0.25*,从底部起各区段为 $0.14、$0.04、$0.05、$0.02。Anthropic 的条形为陶土色,OpenAI 的条形为深灰色,Meta 的条形为蓝色,每个条形下方都有公司 logo。

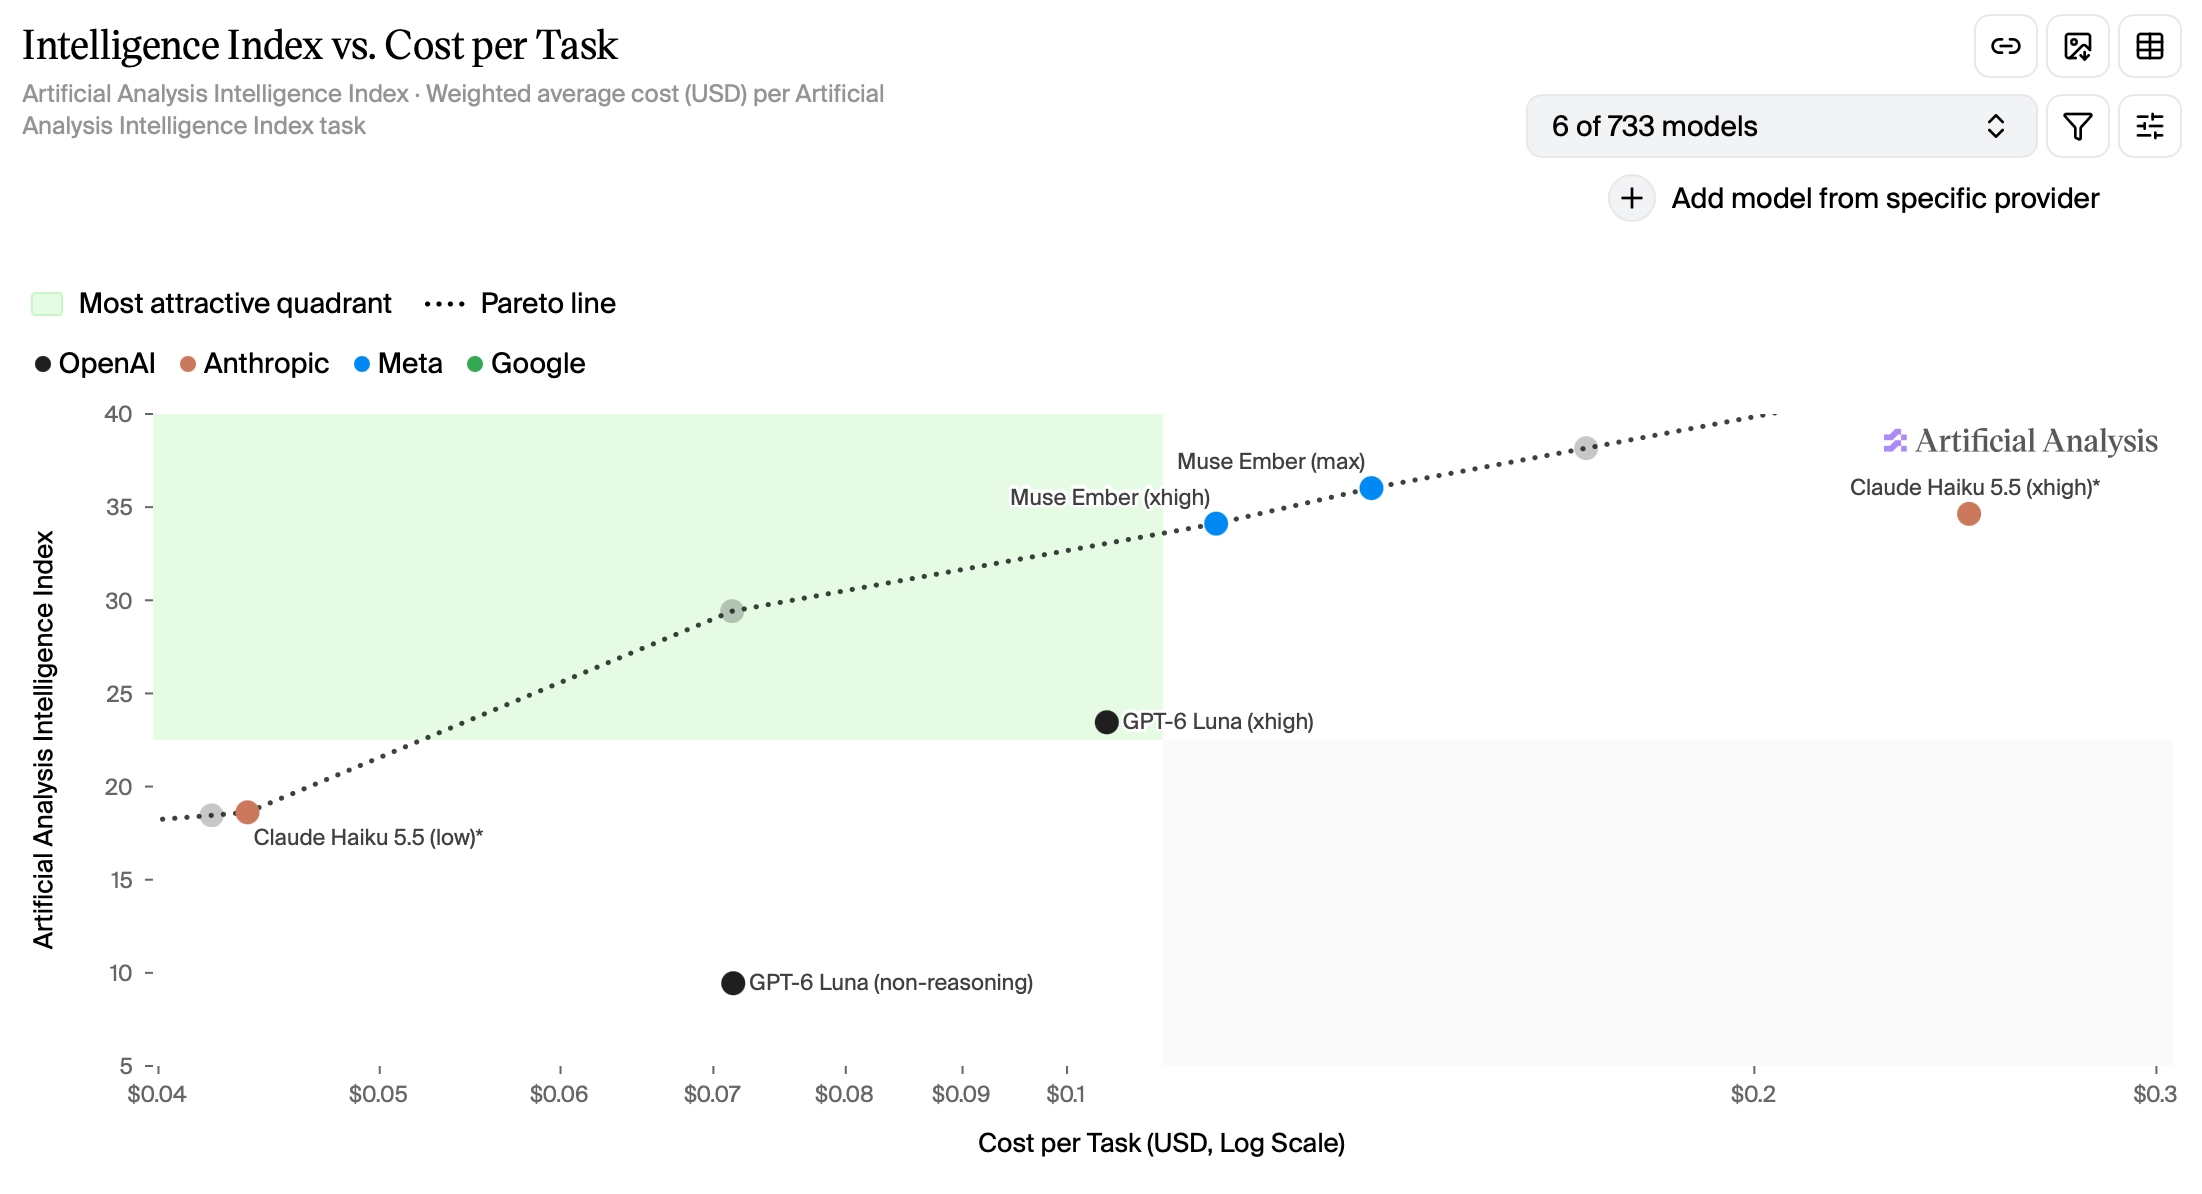
比这更有用的是他们的 Intelligence Index vs. Cost per Task 图表,它显示了这三个模型的如下情况:

Artificial Analysis 的散点图,标题为「Intelligence Index vs. Cost per Task」,纵轴为 Artificial Analysis Intelligence Index(5 到 40),横轴为对数刻度的每任务成本(美元,$0.04 到 $0.3),左上角有绿色的「最具吸引力象限」和一条点状帕累托线。Claude Haiku 5.5 (low)* 得分约 19,成本约 $0.044。GPT-6 Luna (non-reasoning) 得分约 9.5,成本约 $0.07。GPT-6 Luna (xhigh) 得分约 23.5,成本约 $0.10。Muse Ember (xhigh) 得分约 34,成本约 $0.12;Muse Ember (max) 约 36,成本约 $0.14,两者都在帕累托线上。Claude Haiku 5.5 (xhigh)* 得分约 34.5,成本约 $0.25,明显位于帕累托线右侧。帕累托线上还有三个未标注的灰点。

Muse Ember 模型正位于那条帕累托线上——在这条线上,你只有牺牲一个维度才能改善另一个维度。Meta 在他们的发布公告中指出了这一点:

它也位于完整 Artificial Analysis 排行榜的效率前沿:没有任何模型能以更低的每任务成本获得更高的得分。

(绿色区域中间、帕累托线上的那个灰点是 GPT-6.1 Terra (low)——显然我该多关注 Terra 系列了!)

推出我们最小、最高效的模型:Muse Ember

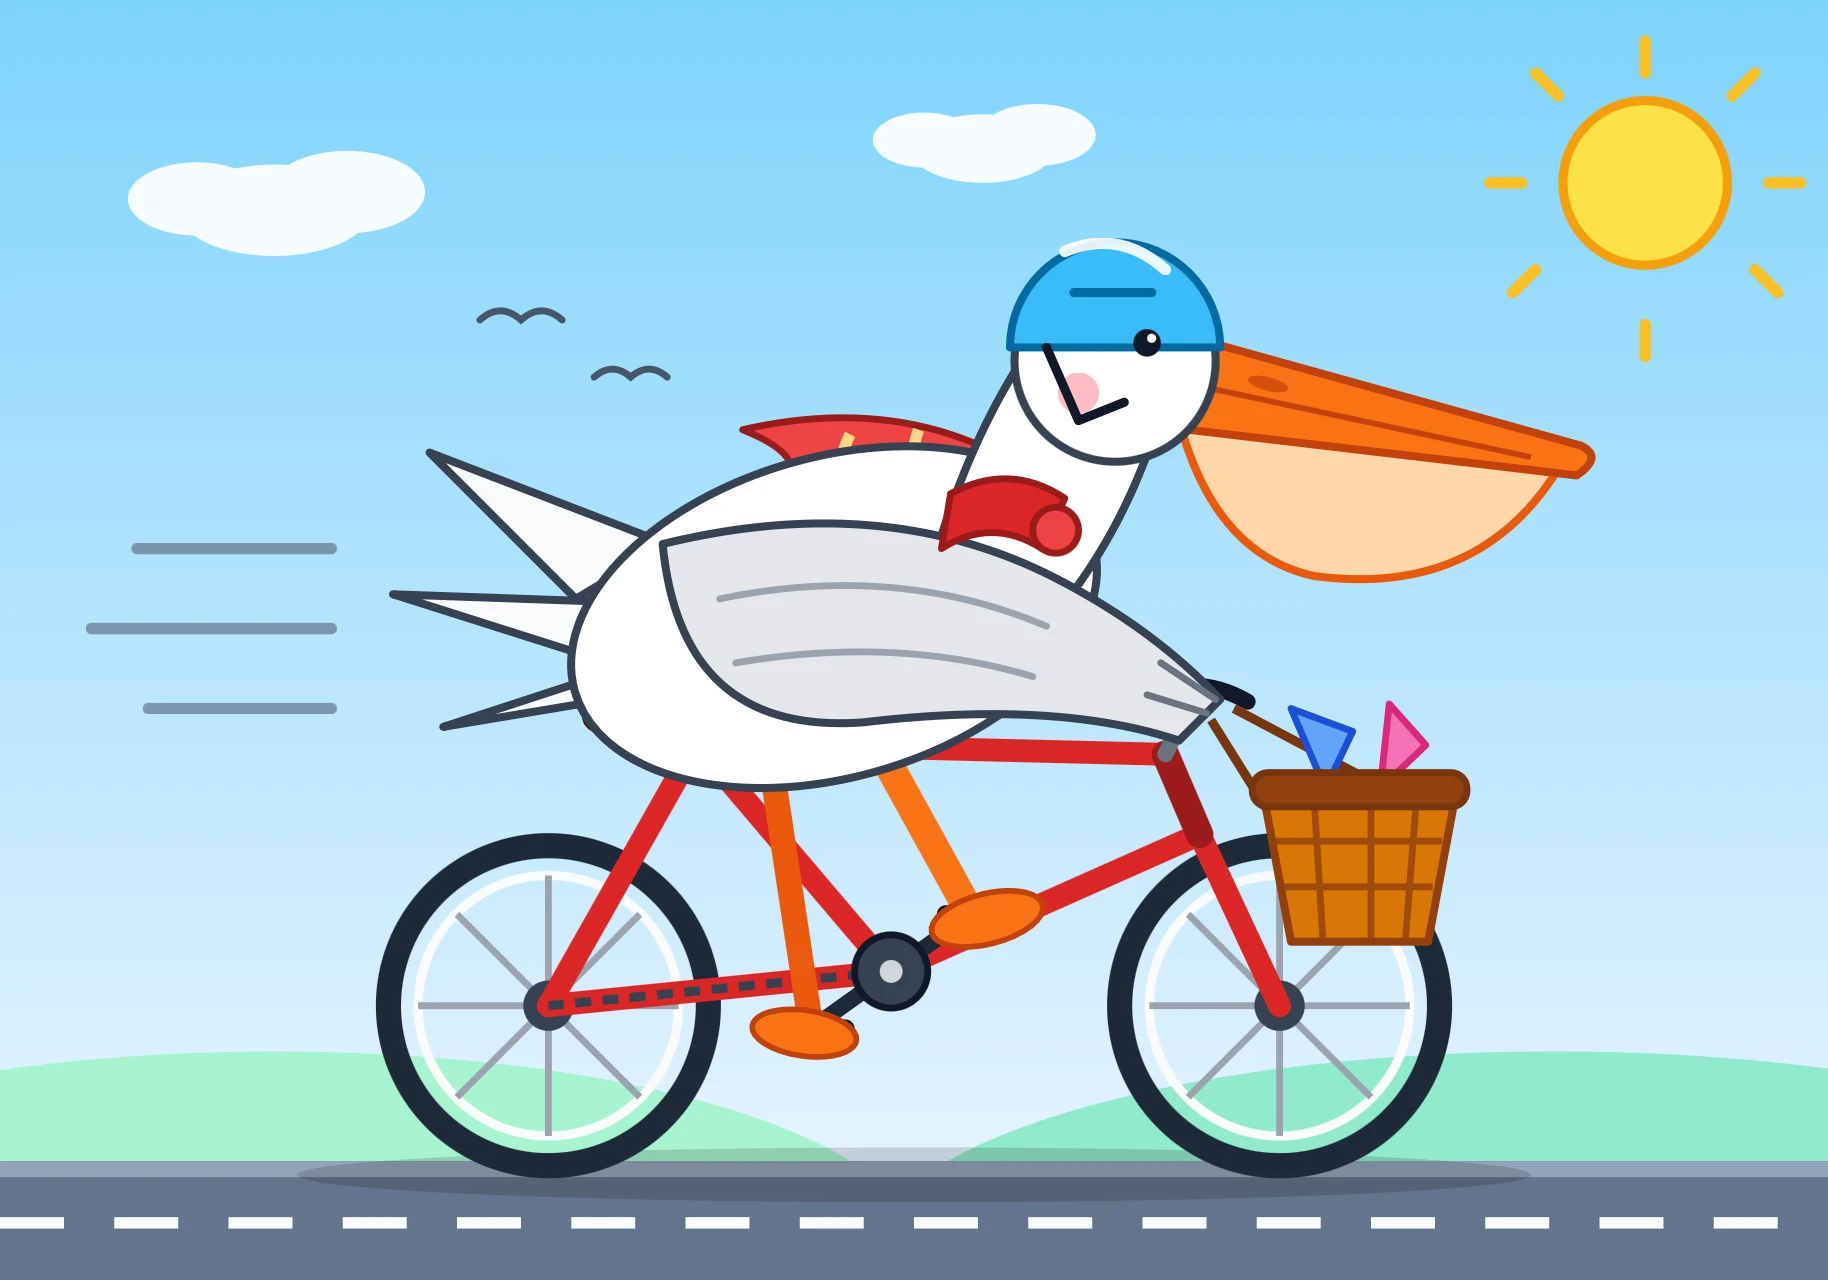
Muse Ember 有六个推理等级——minimal、low、medium、high、xhigh 和 max——于是我渲染了六只骑自行车的鹈鹕。“high”推理等级未能返回完整的 SVG,而其他 SVG 令人意外之处在于,推理等级并没有与回答的视觉质量清晰对应。

这是“max”那张,不过其他的也值得一看:

自行车车架没问题,车筐里有鱼,鹈鹕戴着一顶奇怪的蓝色帽子。

Ember 的鹈鹕在质量上与我从 Muse Wonder 得到的结果相当,而 Muse Wonder 的价格是 Muse Ember 的 40 倍。

近期文章

  • 用 Claude 定位神秘哔声的来源 - 2026年11月9日
  • 把你的垃圾 PR 描述藏在 <details><summary> 后面 - 2026年11月9日
  • 我笔记本上的 Qwen 3.8 27B 也能解读模型权重 - 2026年11月3日
  • 美国人口普查局与“超级智能” - 2026年11月2日

The translation is machine-generated and individual terms may be off. Nothing is rewritten or cut; the original is authoritative.

Published by Simon Willison
This site only summarises and aggregates; copyright stays with the original author. Headlines and summaries follow the source — where they differ, the original wins.
Read the original ↗