 Newshot
文章标题:构建一款网络交换机 ASIC 芯片
正文: 这可真是一段跌宕起伏的经历,该从哪儿说起呢?
我目前正在致力于打造一些开源网络设备,最终目标是做出一台完整的路由器。
在这一路上,还有很多非常有价值、复杂度也没那么高的硬件需要搭建,其中之一就是常见的网络交换机。
此前,我一直在搭建处理以太网数据包的基础设施,并一路做到了一个简单的三端口交换机,还通过 Tiny Tapeout 把它流片了。但那次流片几天之后,当时我还在为赶截止日期而肾上腺素飙升、心有余悸,一个意想不到的机会出现了:有可能免费流片我自己的完整芯片!
但有一个小问题,我只有四天时间来设计整个东西,也就是 96 小时(用小时来说绝对没法让它听起来不那么可怕)。
几个月前,我写过:在不到 2 周内构建一个带有一些硅内调试基础设施的完整矩阵乘法加速器,时间太紧了,这完全是个糟糕的主意,绝对不应尝试,尤其是在企业环境中。而自那以后,我又发现了一个新的地狱层级:在 4 天内独自设计一颗完整的 ASIC。
这下面的咖啡因可不少。
但既然我已经窥见了这些新的地狱深处,那就让我给你讲讲构建完整 ASIC 的旅程吧!
完全开源、完整芯片流片的非管理直通式 100Mbps 以太网交换机和宇宙热寂信标。目标为 0.5x0.5 waffer.space run#2。
晶圆厂会跟我沟通吗?
不……不,他们不会……
但他们会跟 wafer.space 沟通,而 wafer.space 会跟我沟通。
现在我想你可能在想:wafer.space 又是什么?
几个月前,发生了一件事。Tim Ansell,他原本是 Google 团队的一员,那个团队为我们带来了 SkyWater 130nm 和 GlobalFoundries 180nm 开源 PDK,他离开了 Google,创办了 wafer.space,在那里他为普通人打开了以可负担的价格在 GlobalFoundries 流片自己芯片的可能性。他们提供在 GlobalFoundaries 180nm 上制造你芯片的服务,并可选择进行封装。
大芯片和小芯片
芯片有各种矩形尺寸,尺寸以面积衡量。
面积是设计的主要关注点之一,因为这再次是一个冷酷计算的经济学问题,因为当你去制造芯片时,你按面积的 \( mm^2 \) 付费。
以 IHP(另一家晶圆厂)下面为其自己的多晶圆运行给出的报价为例。如果你参与这次运行,你将拿回固定数量的芯片(这里是 40 颗),你的最终芯片成本将对应你的芯片最终有多大。
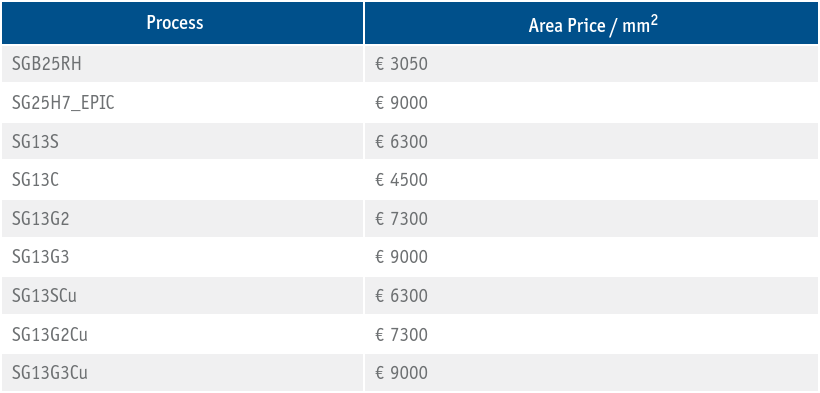
然而,更多面积并不只是因为直接制造成本而更贵,还有第二个更微妙的因素在推高价格,那就是良率。
最终,坏掉的芯片没有价值,实际上我们可以说应该给坏掉的芯片赋予负价值,因为识别哪些芯片坏了要花钱,而卖给客户一颗坏芯片要花更多的钱。因此,最大化好芯片与制造芯片的比率至关重要。这个比率称为良率。
芯片可能因多种原因而损坏,但为简单起见,我会把它们分成两类。首先可能是设计问题,在这种情况下你所有的芯片都同等受影响。其次可能是制造缺陷,它会半随机地影响你的芯片。
在半导体器件制造过程中发生的制造缺陷可以建模为单位面积的恒定缺陷概率,这意味着面积更大的芯片有更高的概率存在缺陷,因而良率更低,最终导致更高的成本。
像 {{NAME_ab12cd34}} 这样写出的值是真实值的占位符。请完全按写法使用它们,在回复和工具调用中都是如此:它们会在任何内容运行之前被填入真实值。不要要求验证它们,也不要用示例替换它们。
文章标题:构建一个网络交换 ASIC 芯片
正文: 这本身并不影响我为芯片面积所支付的价格,但它会影响我为每颗功能性芯片支付的平均净价。
这就是为什么面积优化在芯片设计中如此受关注的双重原因。
现在 GlobaFoundaries 180nm(gf180)并不是一个年轻的节点,而把旧东西礼貌地称为“成熟”。随着节点的成熟,代工厂对该工艺的专业知识不断增加,从而随着时间推移带来更好的良率。因此 gf180 是一个良率极佳的节点,与面积相关的缺陷并不成问题,尤其是与更年轻的先进节点相比。
Wafer.space 现在提供 4 种芯片尺寸,在社区中通常被称为“full”、“half”和“quarter”槽位。
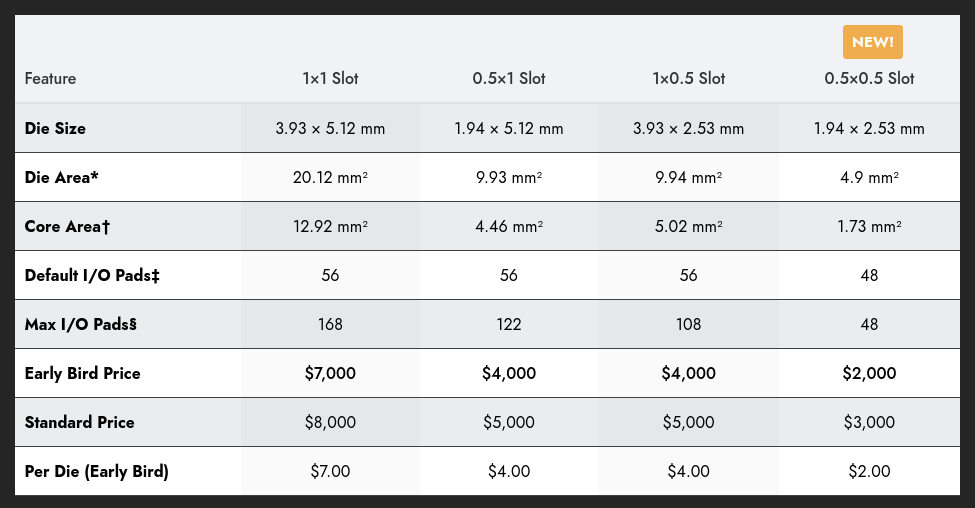
对于需要一些参照的人来说,full 槽位及其近 13mm2 的面积与整个 Tiny Tapeout gf180 shuttle 芯片大小相同。同一颗芯片能够容纳多达 160 个项目瓦片以及所有 Tiny Tapeout 通用基础设施。作为参考,我的两个脉动阵列(8 位整数和 bfloat16)以及最初的交换芯片都只占 4 个瓦片,而我迄今为止最大的设计——blake2s 哈希加速器——占了 8 个。
划片
但把硅制造出来只是这场战争的第一仗。
一旦你的芯片被做在晶圆上,在它真正能被称为一颗芯片之前,还有两个重要步骤需要完成。
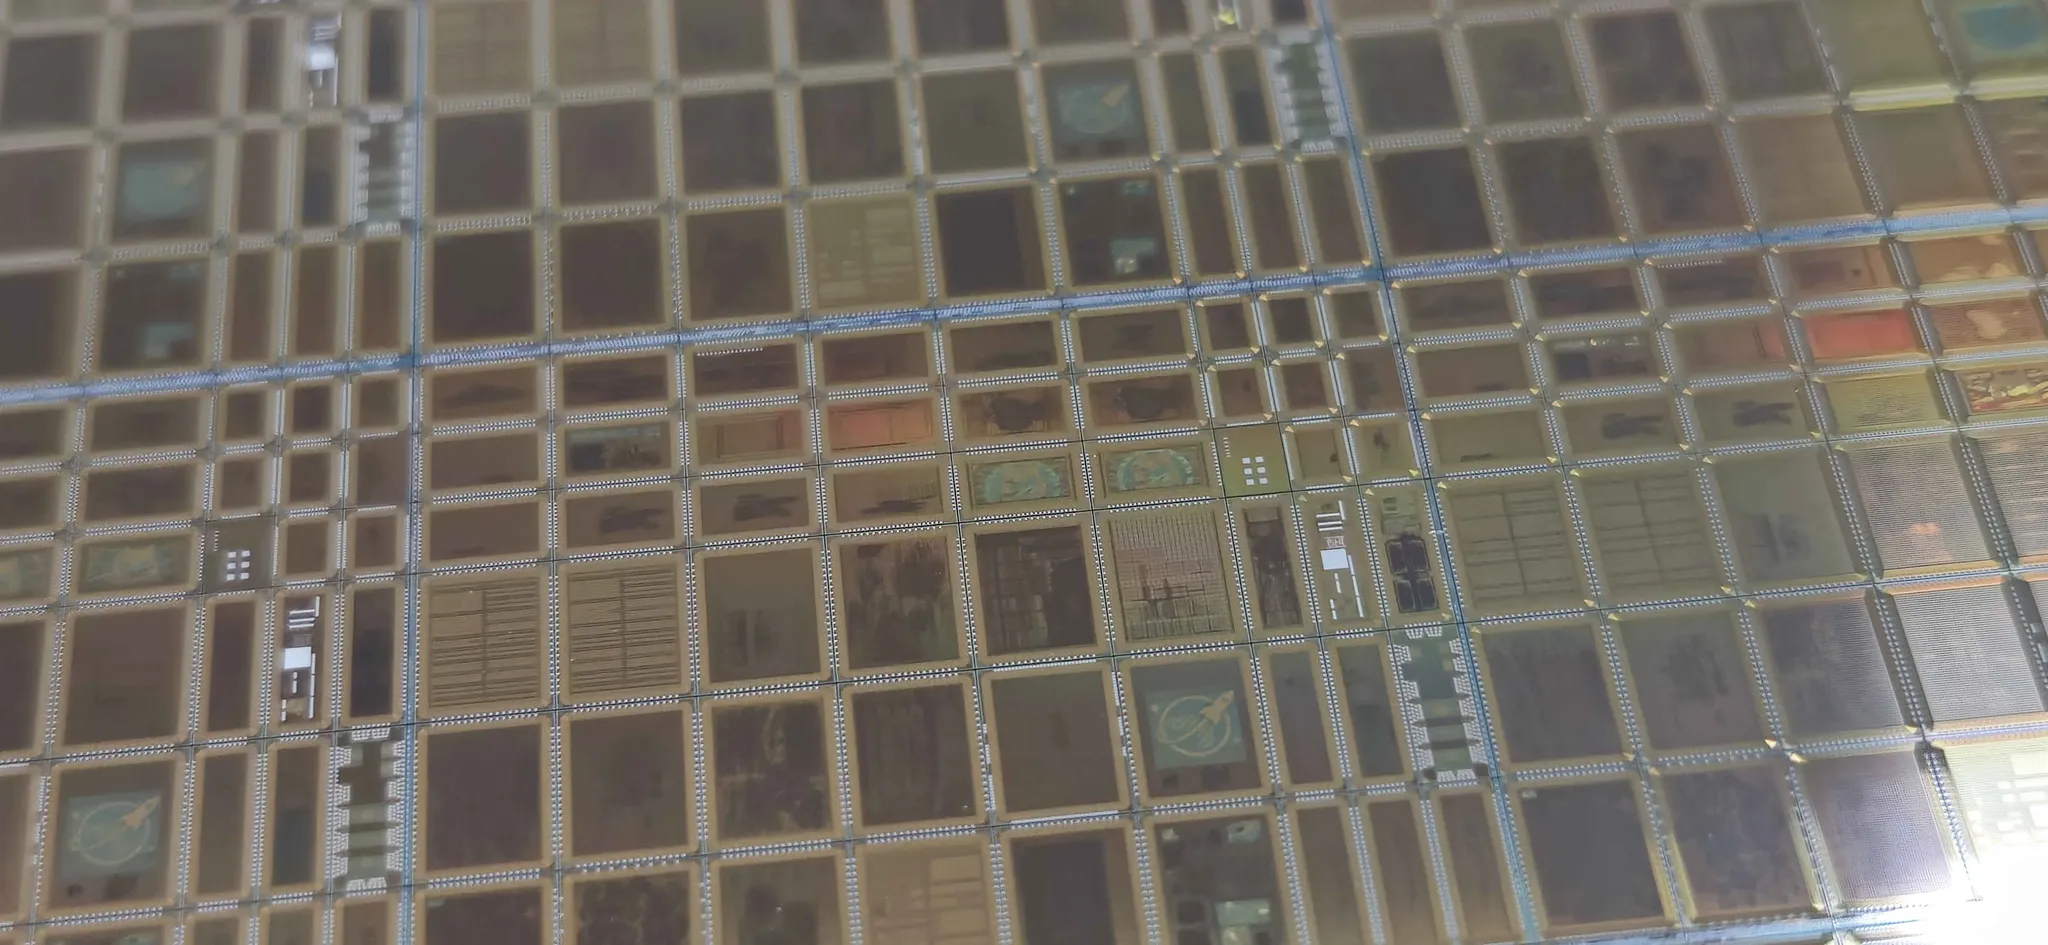
半导体制造在称为晶圆的基板上,这是一块实心硅圆盘,需要被非常精确地分割成一颗颗独立的芯片。这一步称为划片。
因此,一旦晶圆离开晶圆厂,wafer.space 的人收到整套晶圆后,他们会联系另一项专业服务,使用非常精密的金刚石锯沿划片线将它们分割成独立的芯片。
此时,wafer.space 提供两种选择。第一种是直接把划好的芯片邮寄给你,第二种是帮你把芯片封装好。
封装?
原始的半导体硅很漂亮,但除非你也有收集昂贵晶体来观赏的习惯,否则它们本身没什么用。毕竟,你怎么和一块掺杂硅晶体通信呢?
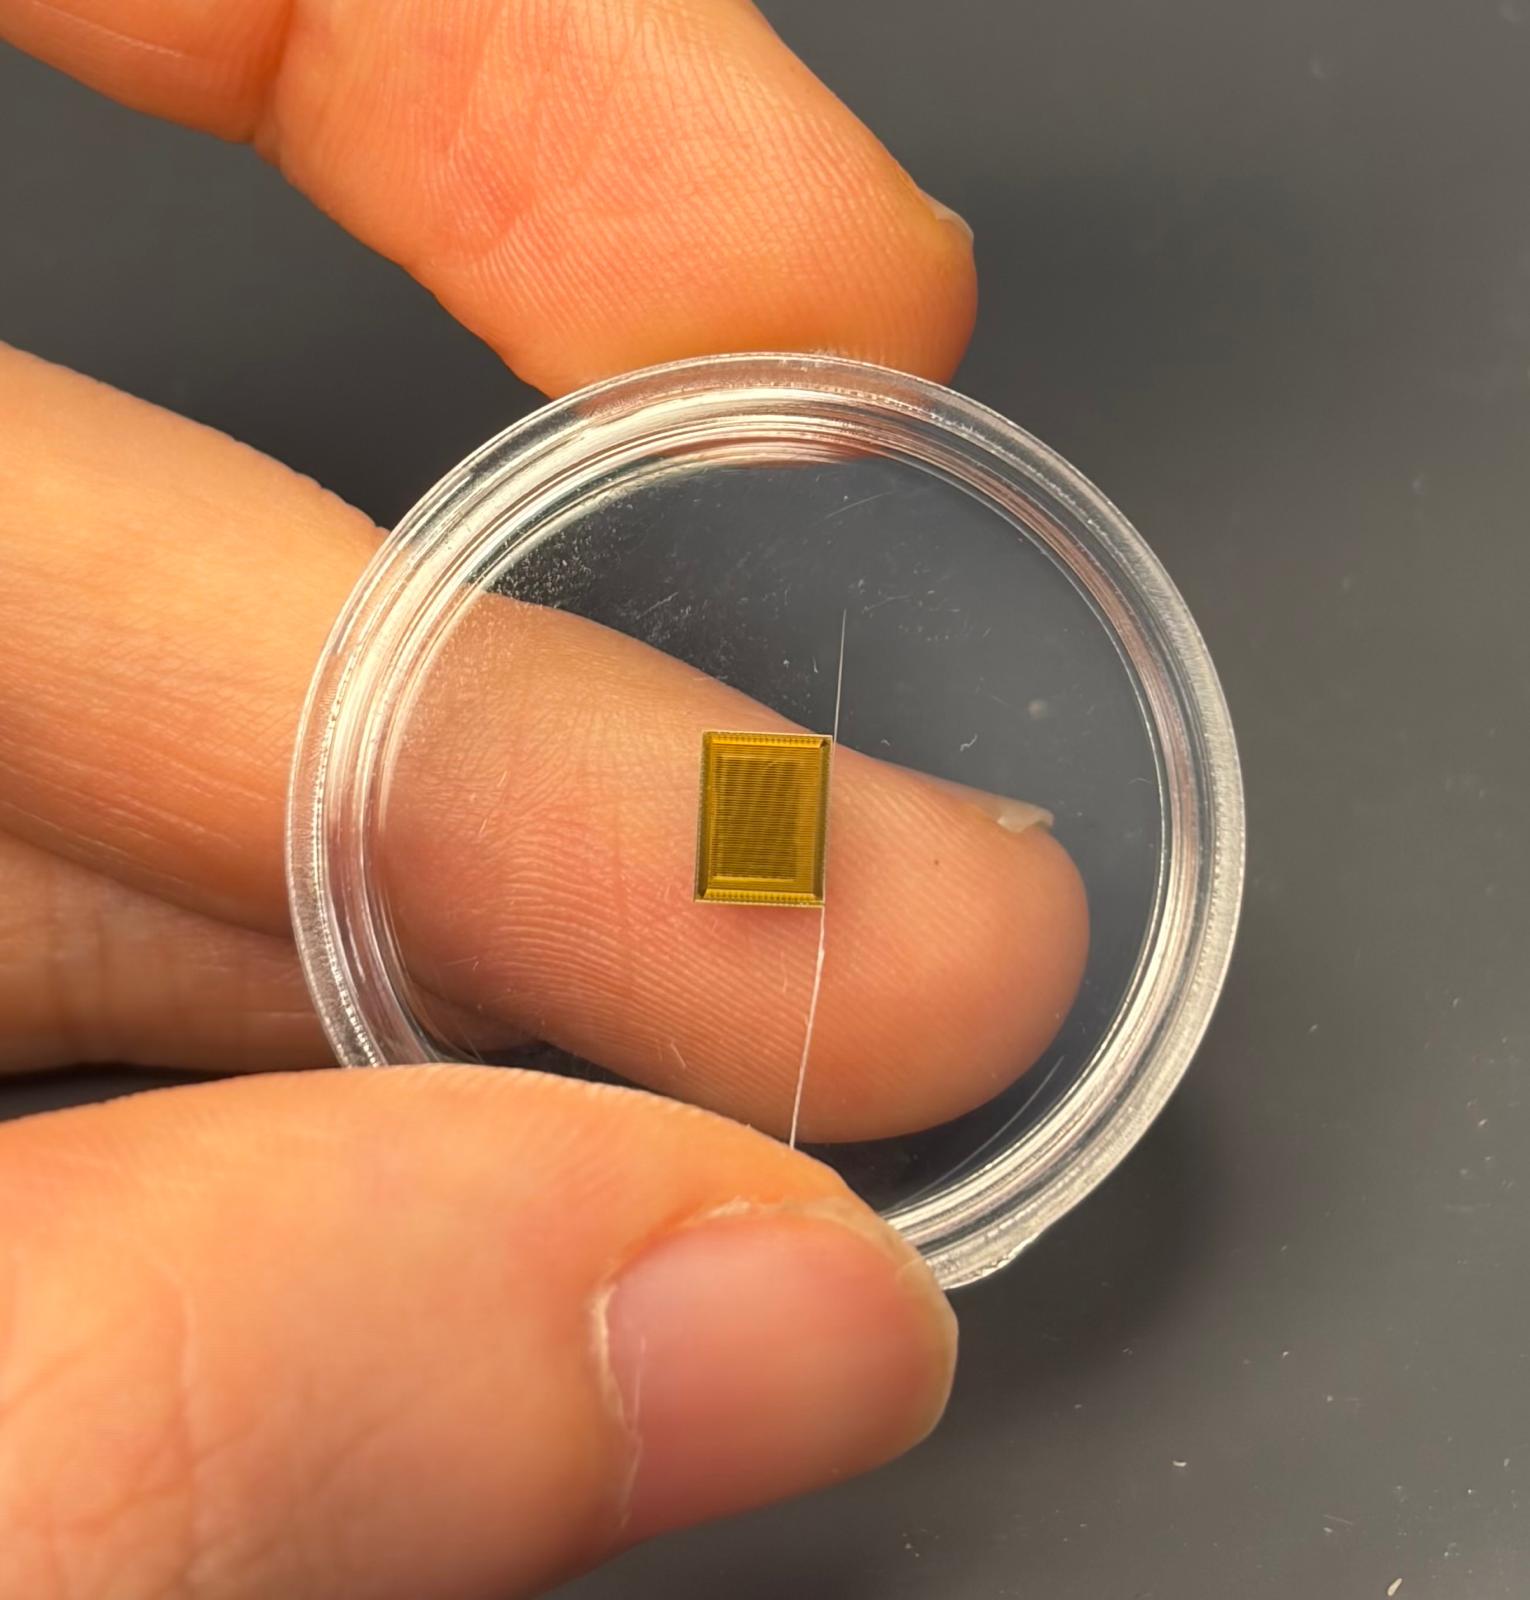
为了给我们的芯片供电并能够与它通信,我们需要将它封装成可以连接到更广泛电子电路的形式。
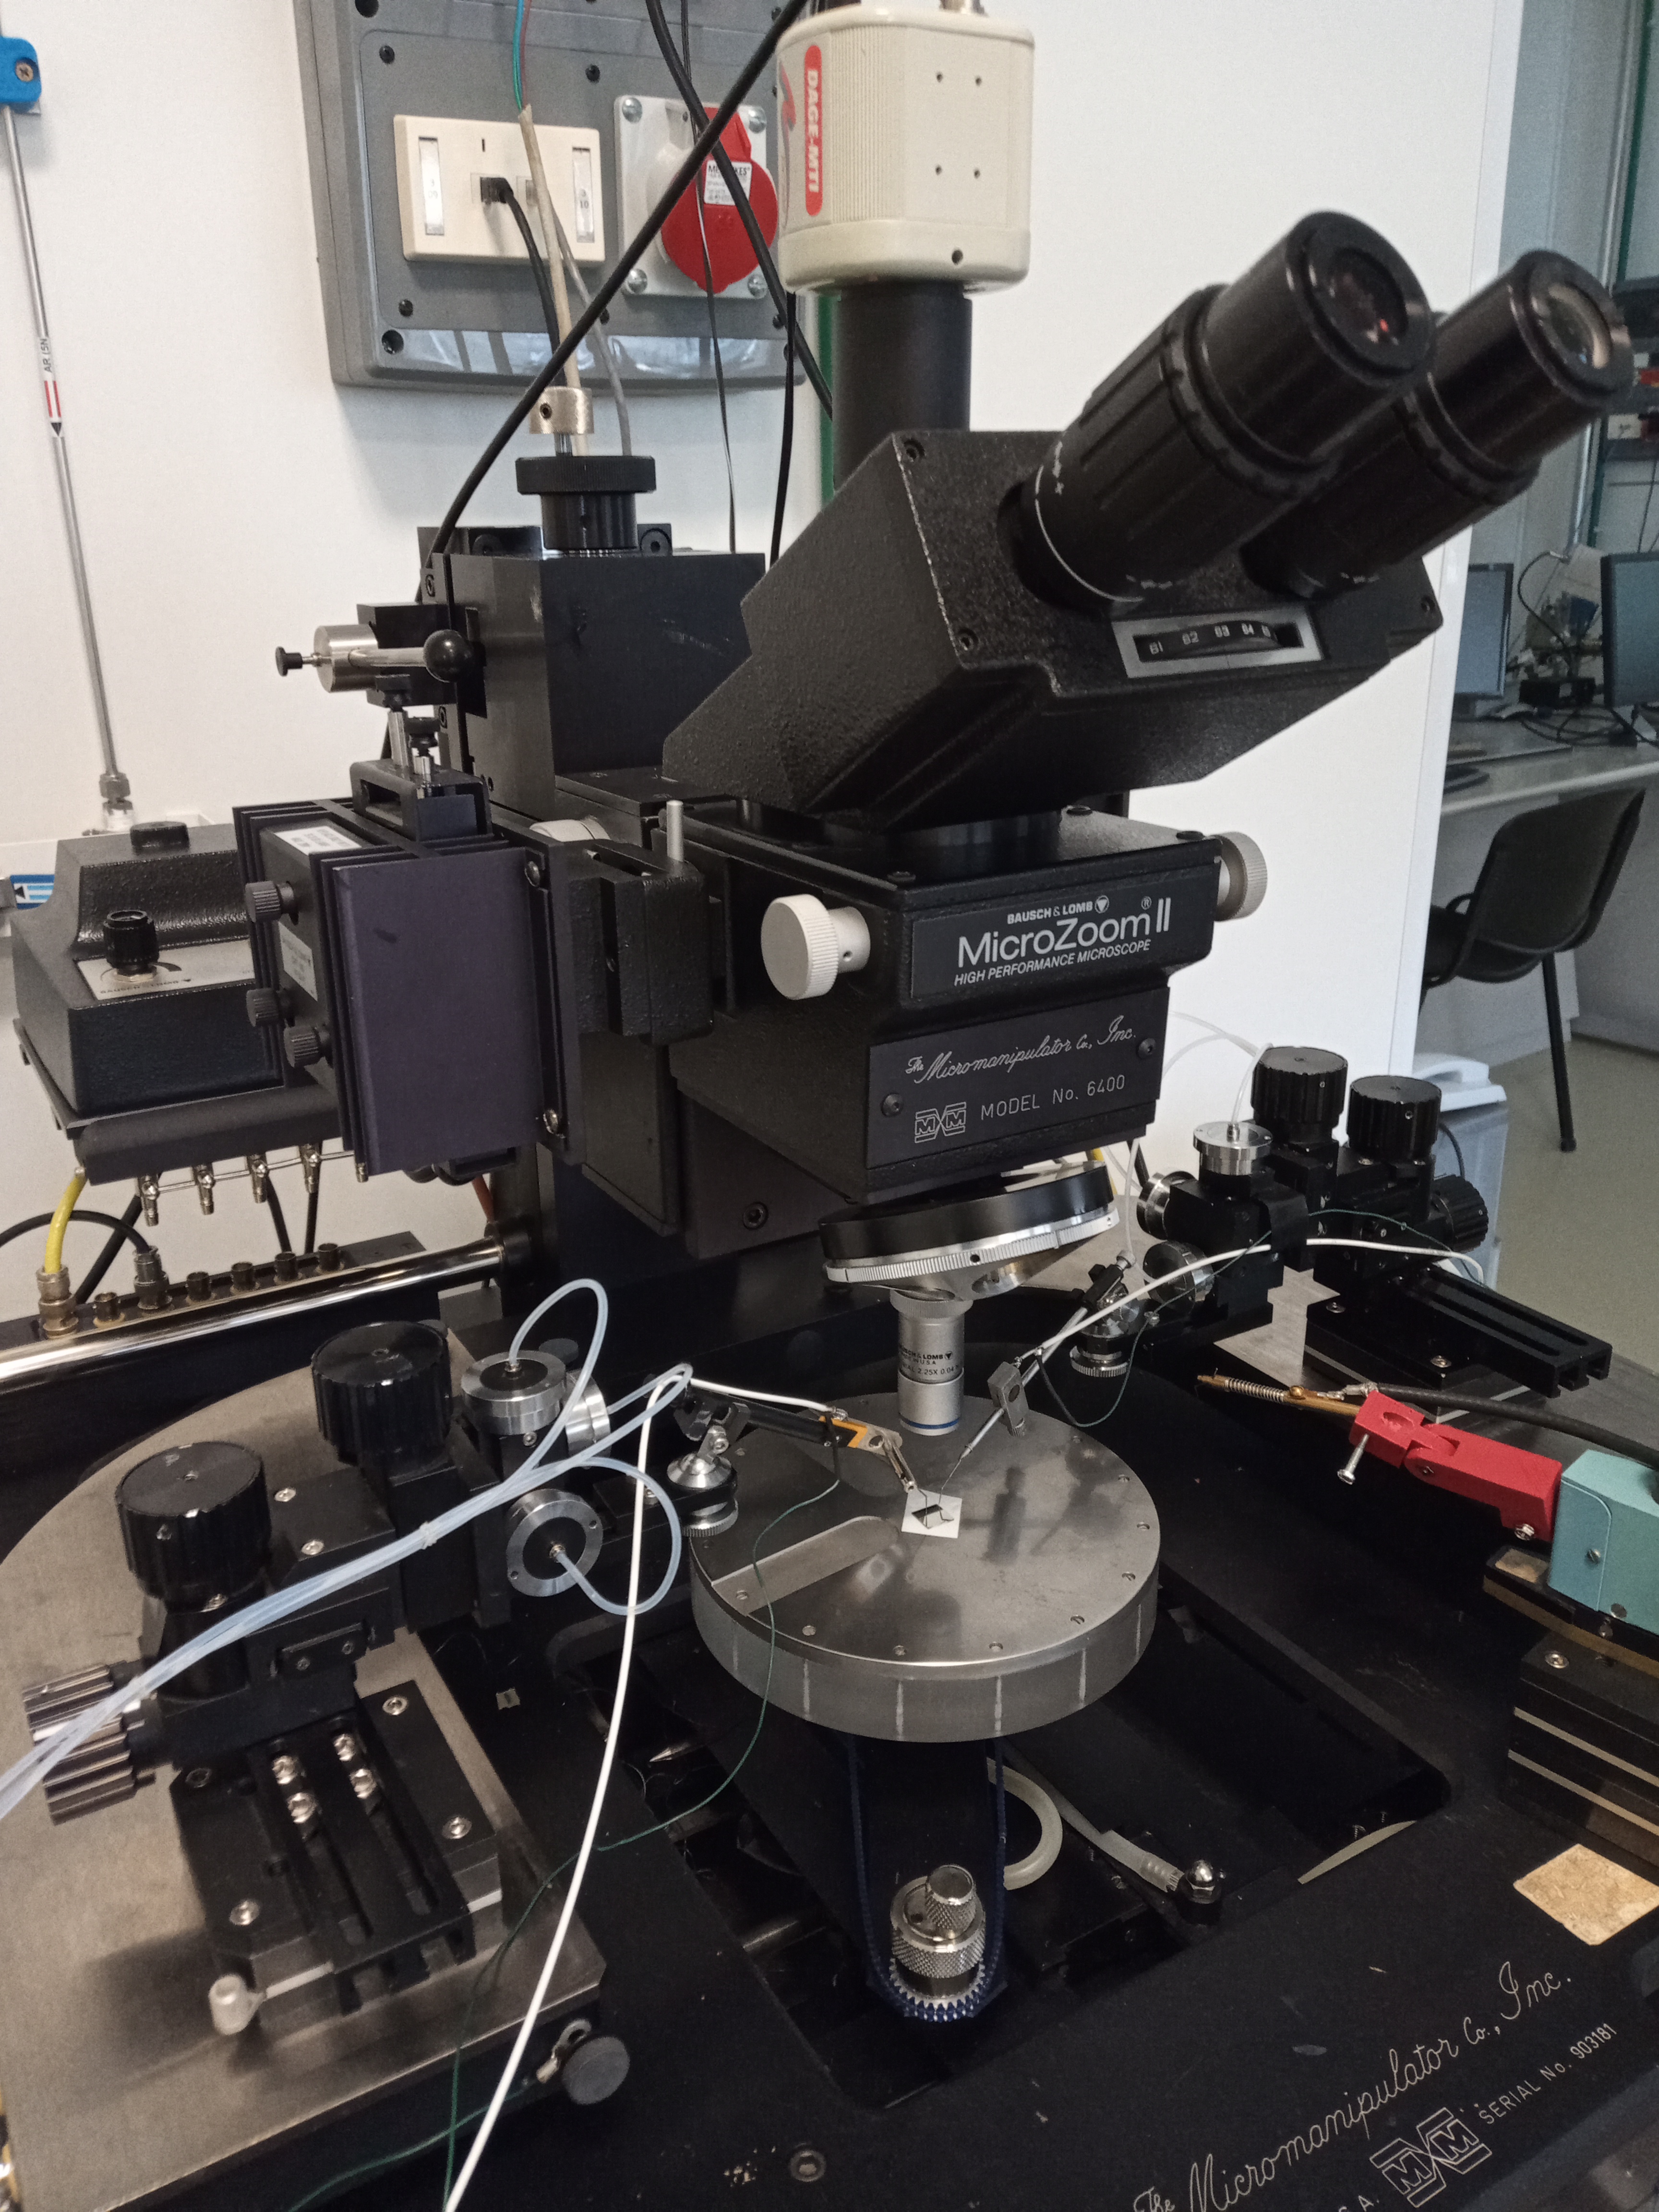
也就是说,除非你车库里恰好有一台微操作器和大约 56 根微探针可用于芯片 bringup。如果是这样,请务必告诉我你是否需要帮忙清理车库,我那天没有任何安排。
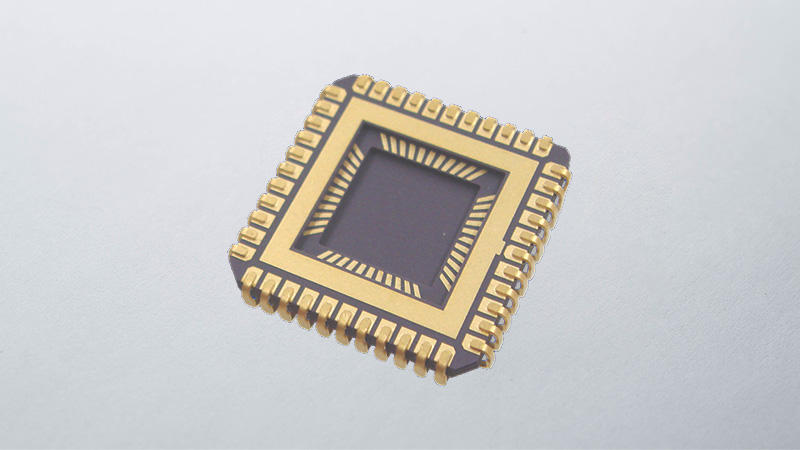
芯片封装有多种形式,最常见的是某种黑色塑料外壳,不仅用于建立到硅的可访问连接,还用于保护脆弱的裸片和连接免受冲击、湿度和极端温度波动造成的环境损害。
我们选择的封装类型也会影响我们如何架构 IO,从而影响我们的硅布局图会是什么样。封装有两大类别:
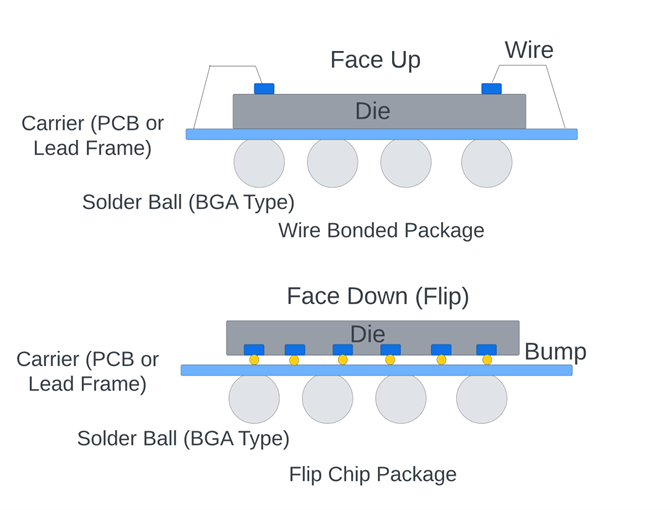
在倒装芯片的情况下,IO 引脚连接将规则地分布在整个布局图上,从而导致更短的逻辑到引脚连接,并支持更高的引脚密度和数量。但另一方面(双关意在所难免),倒装芯片封装需要更高的精度,并且与……相比更昂贵。
引线键合的工作原理是使用一根由金或铝制成的非常细的飞线,将你的硅连接到封装中的焊盘上。
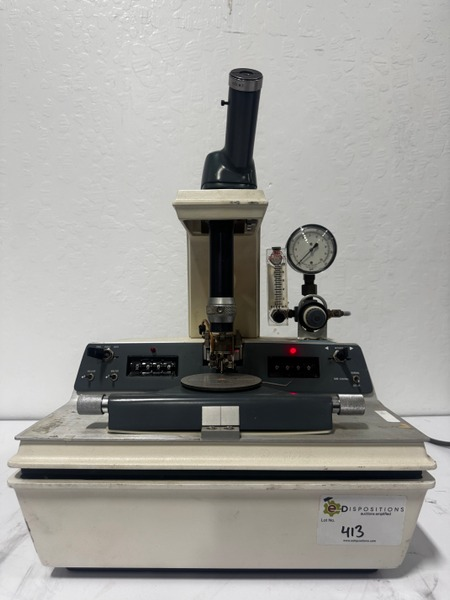
这是由一台引线键合机完成的:它会从硅片上的一个 IO 焊盘物理拉出一根导线,并将其连接到封装上的一个焊盘。硅片会被放置在封装中央,并连接到封装上围绕它布置的焊盘,这些焊盘本身又连接到更大的外部焊盘。
在这种情况下,硅片的 IO 焊盘结构会位于芯片靠外的位置,形成两个不同区域:焊盘环,以及大部分逻辑所在的核心区。
引线键合封装有许多子类型,wafer.space 决定提供一种名为板上芯片封装(CoB)的方案,它与大众市场芯片的经典封装方式有些不同,但对小规模制造来说成本效益高得多。
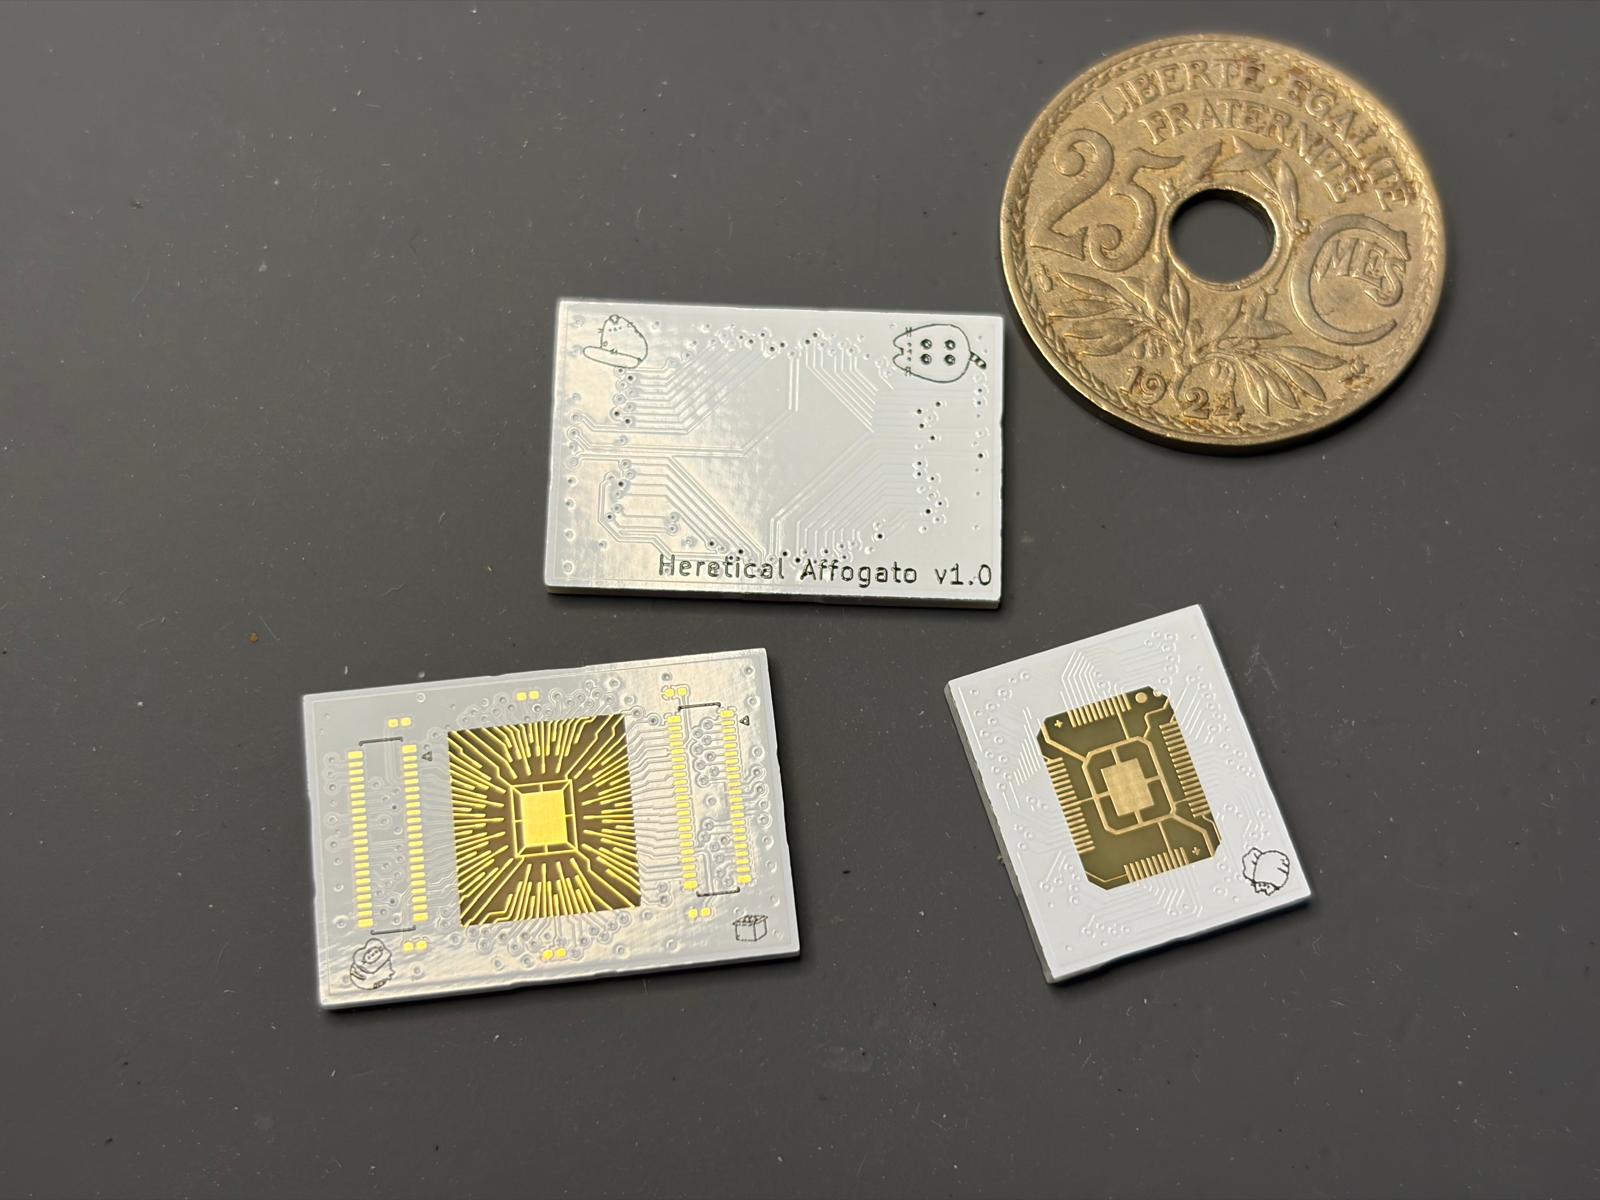
对于 CoB,芯片不是键合到封闭封装中,而是直接连接到 PCB。
芯片键合到 PCB 上后,会在硅片和键合线上沉积并固化一层名为 globtop 的保护性环氧树脂层。你们中的一些人过去可能已经在商用 PCB 上注意到黑色胶块,甚至没有意识到自己看到的可能就是 CoB 封装。
但与暗淡的黑色 globtop 不同,wafer.space 选择了更罕见的漂亮透明环氧树脂,让你可以直接透过封装看到键合好的芯片。
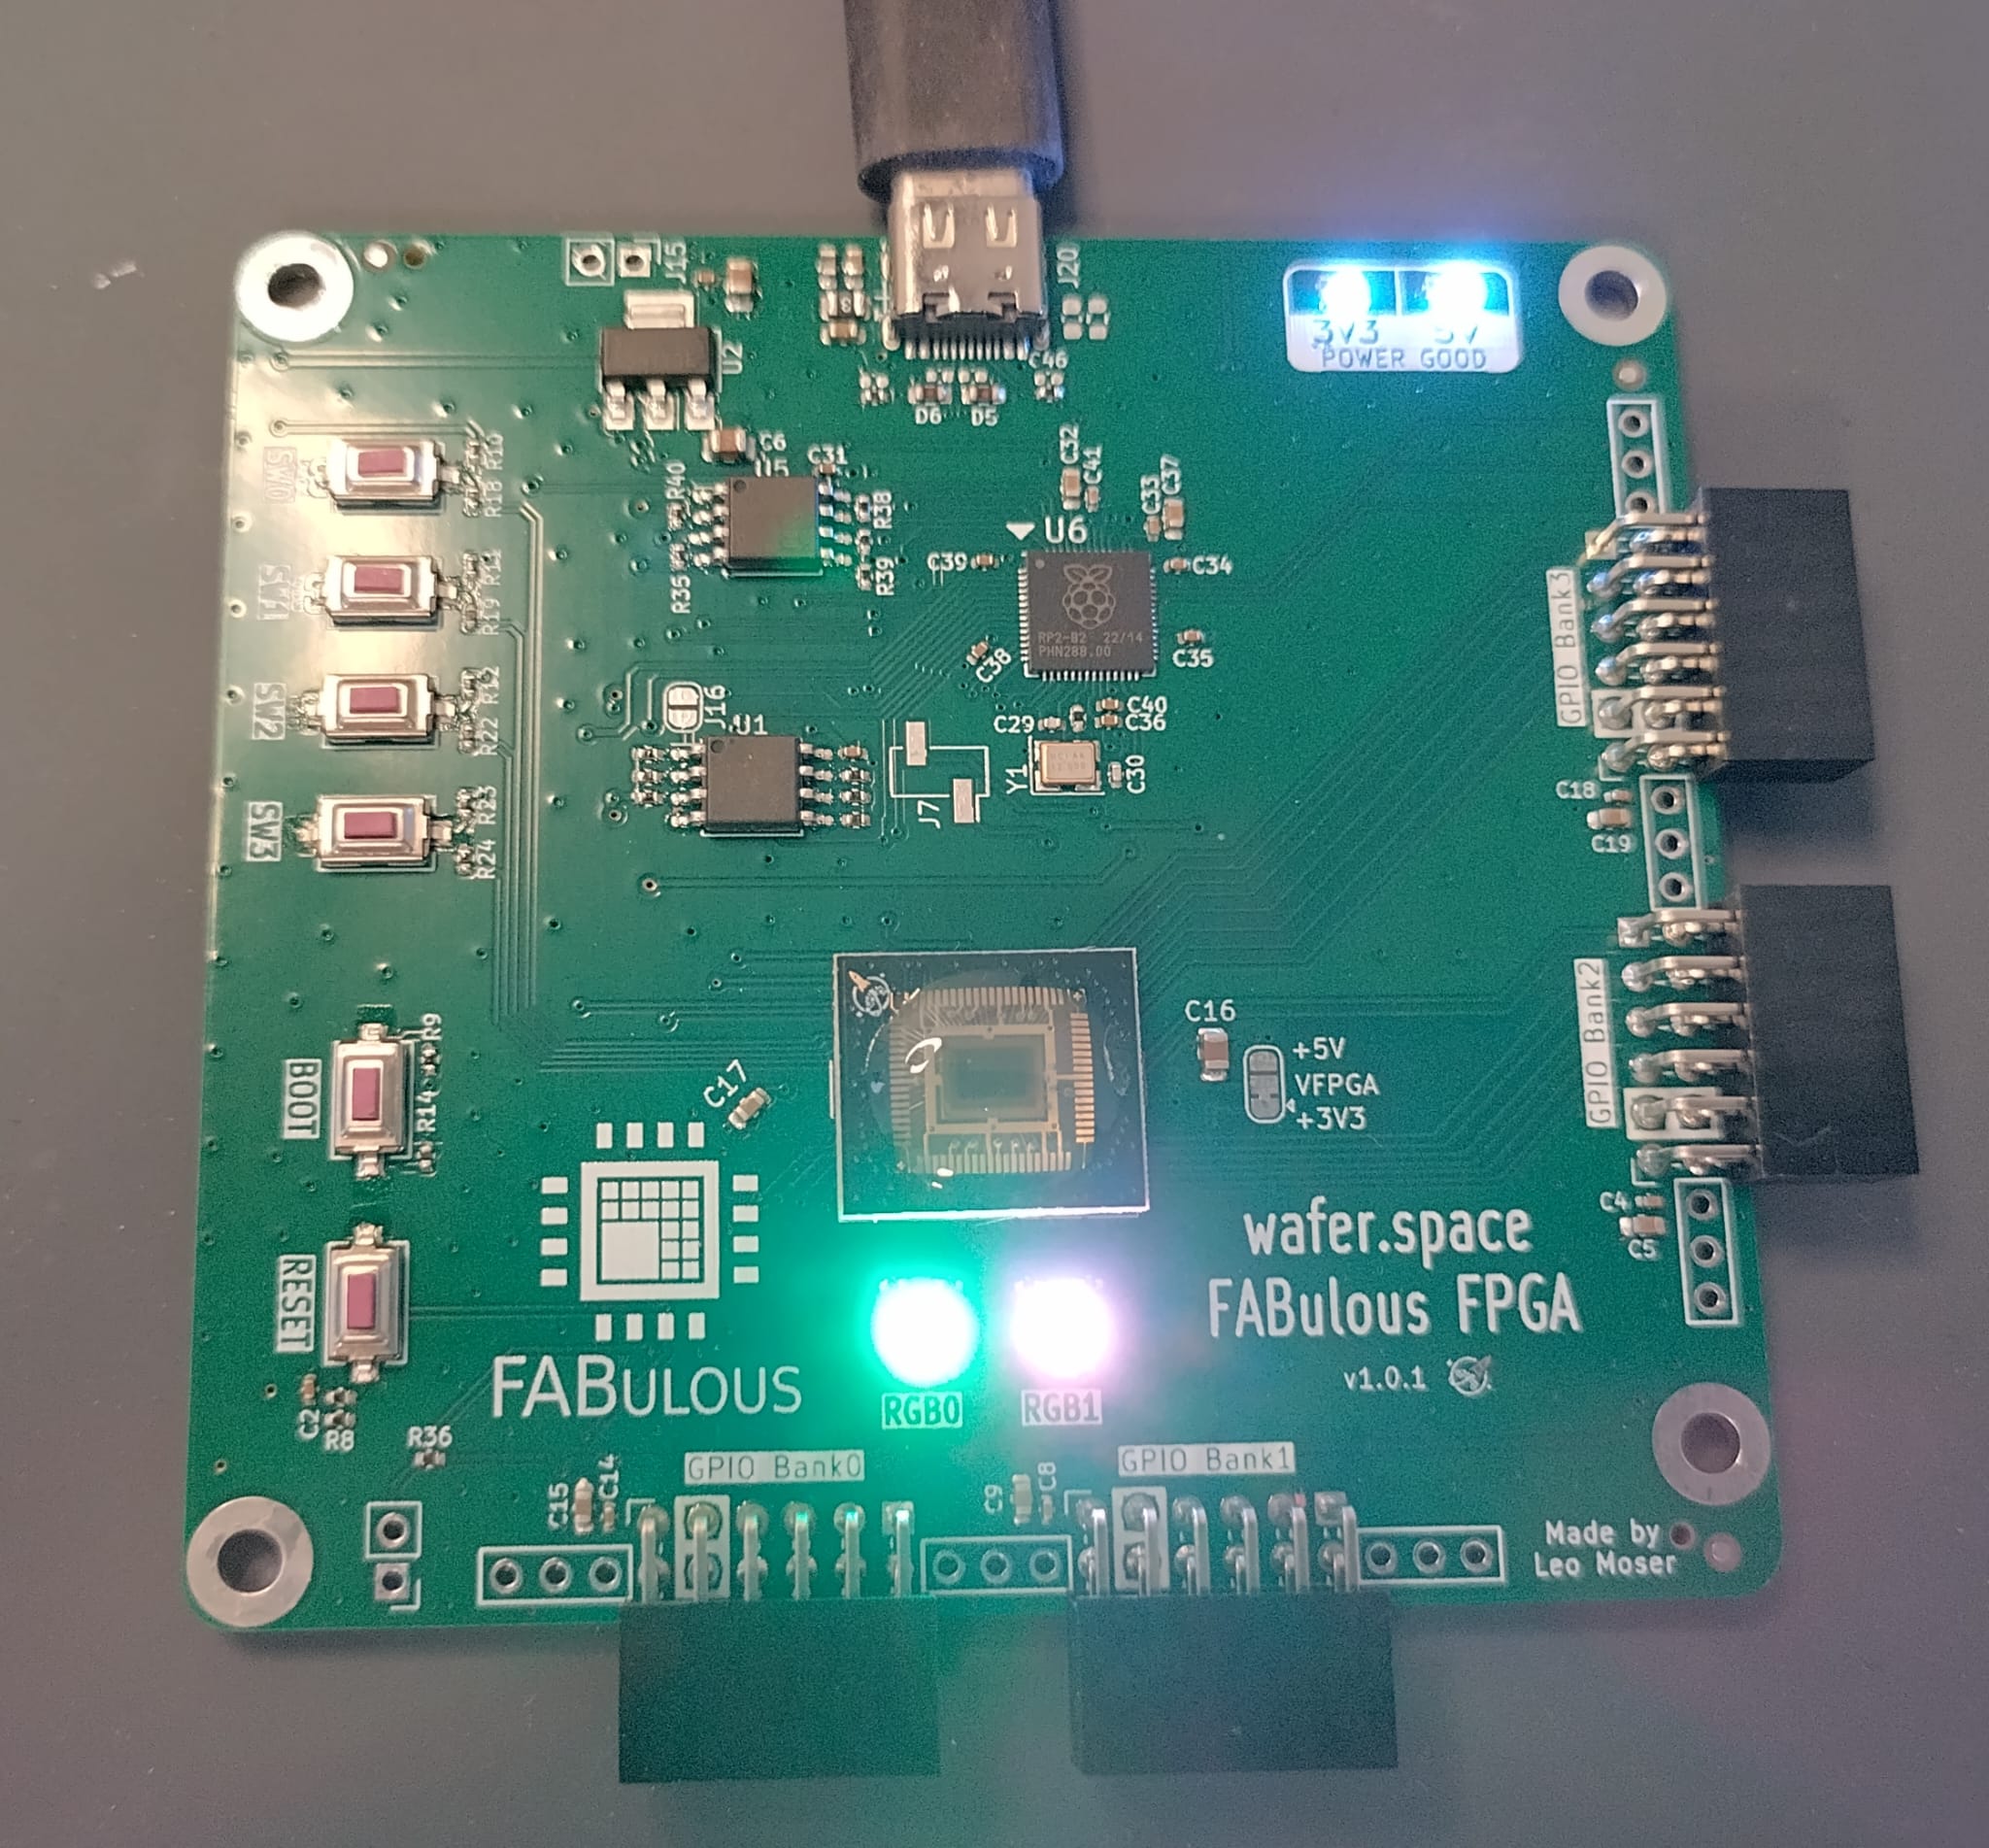
拿走我的钱!
你的硅片完成键合后,你现在拥有的东西就可以正式称为芯片了!🥳
wafer.space 所出售的是:让任何人以一次昂贵假期的价格完成自己的完整原型芯片流片,说实话,这是革命性的。
DARPA 和 google 给了我们工具,Tiny Tapeout 给了我们磨练技能的机会,wafer.space 给了我们直接接触制造的机会。
再次说明,出于透明原则,我受邀免费登上 shuttle,但这种感受来自真实的信念,以至于下一轮制造批次销售一开放,我就说到做到,直接买下了我的名额。
不知怎么,
构建网络交换机 ASIC 芯片
就网络芯片项目而言,真正的改变在于能够控制引脚架构,这意味着我现在可以决定引脚的数量和类型。
因为我使用 RMII 接口与 PHY 芯片通信,所以非常关心引脚,因为每个以太网端口接口需要 7 个引脚。这也是网络交换机最初版本只有 3 个端口的原因:我只有 24 个引脚。
你可以参考之前的文章《Designing an Ethernet Switch ASIC》,了解为什么每个端口需要 7 个引脚,以及每个引脚用于什么。
所以现在最多有高达 46 个引脚可供我使用,我们可以开干了!
从结构上看,引脚是模拟模块,一端带有用于引线键合导线的焊盘。它们作为 GlobalFoundries 开源代工厂提供的 IO cell 库的一部分被包含进来,尽管所有引脚具有相同的高度、宽度和焊盘尺寸,但每个引脚根据其功能具有不同的模拟布局。
本设计中最重要的引脚类型是输入引脚、双向引脚和供电引脚。来玩玩找不同吧。
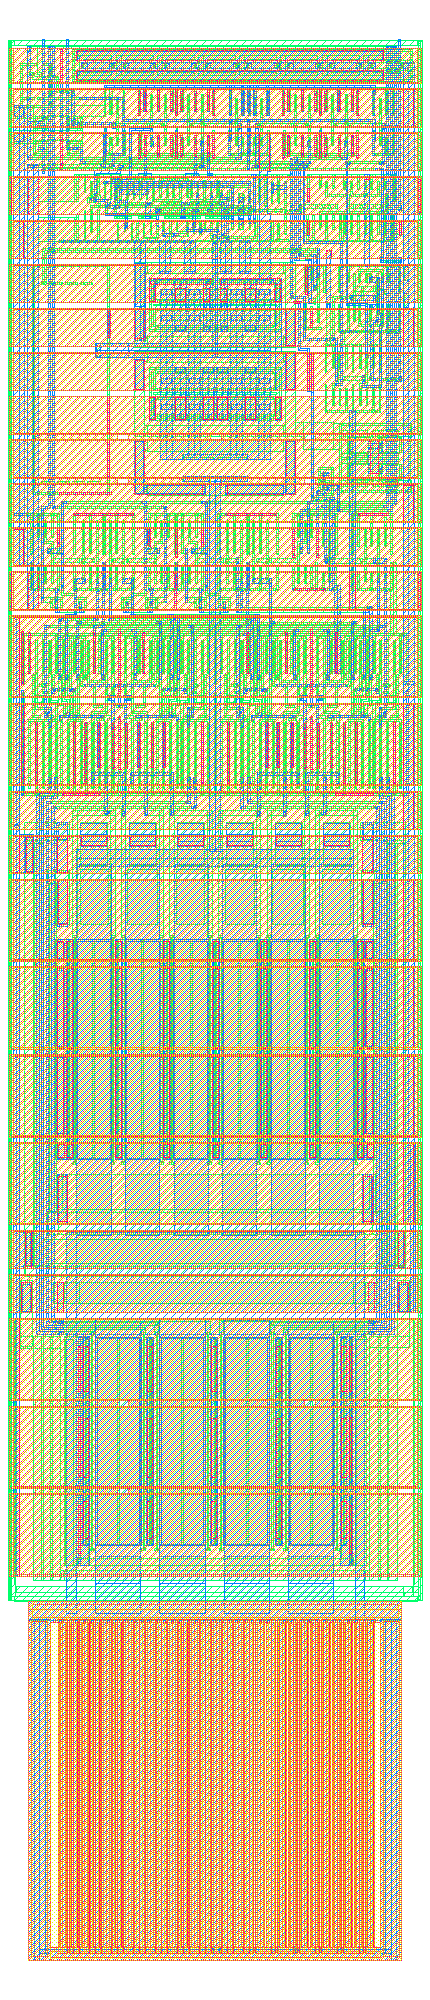
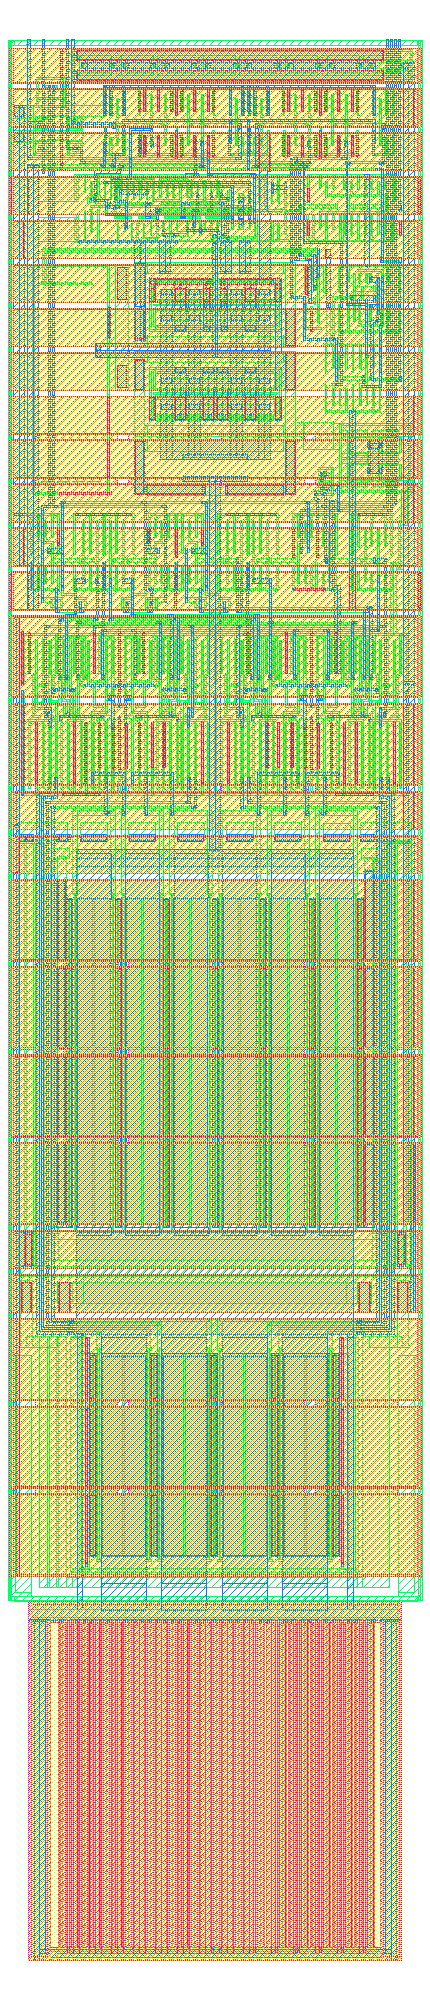
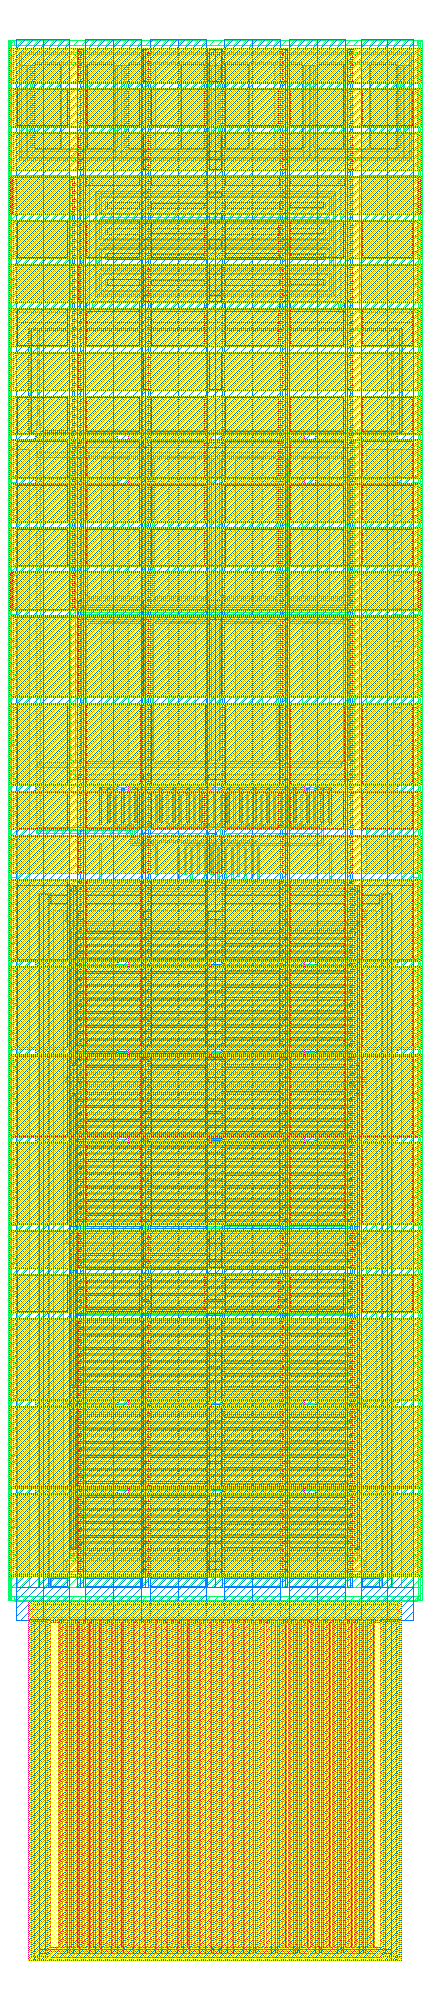
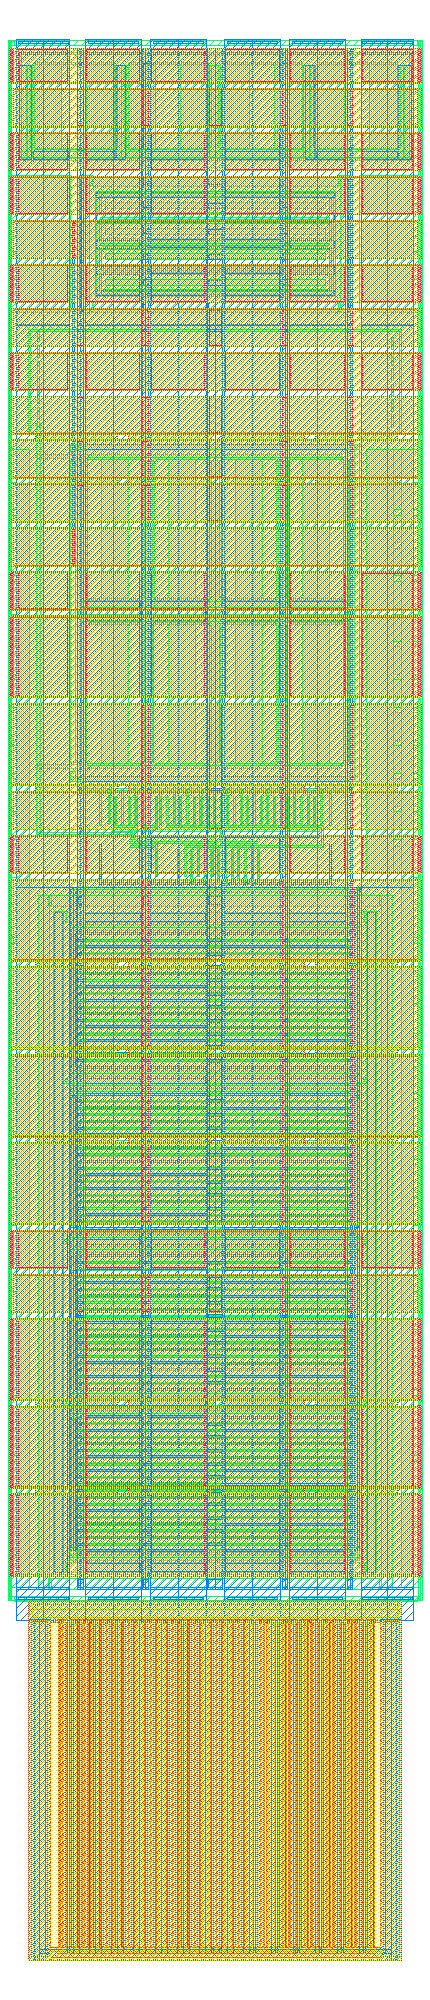
有趣的是,标准库不提供任何纯输出引脚,因此输出由静态配置为输出模式的双向引脚处理。
查看上面提供的布局图,你可能会注意到这些引脚在焊盘正下方没有模拟元件,这被称为“circuit under pad”设计,使它们稍微不那么紧凑,但结构上更具韧性。
这是因为这些引脚最初设计为兼容只有 3 层金属化层的 GlobalFoundary 180nm 工艺版本,但在焊盘所在的顶层金属与下方的模拟电路之间必须存在多层金属结构,以帮助将其与楔形键合时施加到焊盘上的力隔离。在楔形键合过程中,键合点被物理压到位,需要对硅施加很大的力;如果没有足够的结构支撑柱,可能会导致下方电路断裂。
Padring
如前所述,芯片封装有不同的系列,导致不同类型的 I/O 设计:倒装芯片和引线键合。像我的芯片这样的引线键合芯片,其引脚朝向芯片外部,组织在称为 pad ring 的结构中。这是一个围绕芯片核心区域的环,将所有不同的 I/O 焊盘连接在一起。这个环既用于噪声隔离,也用于在所有不同引脚之间共享电源。因为 padring 是一圈连续不断的引脚,引脚之间的空间由非常简单的结构填充,称为 filler cells,用于闭合环内的电源连接。
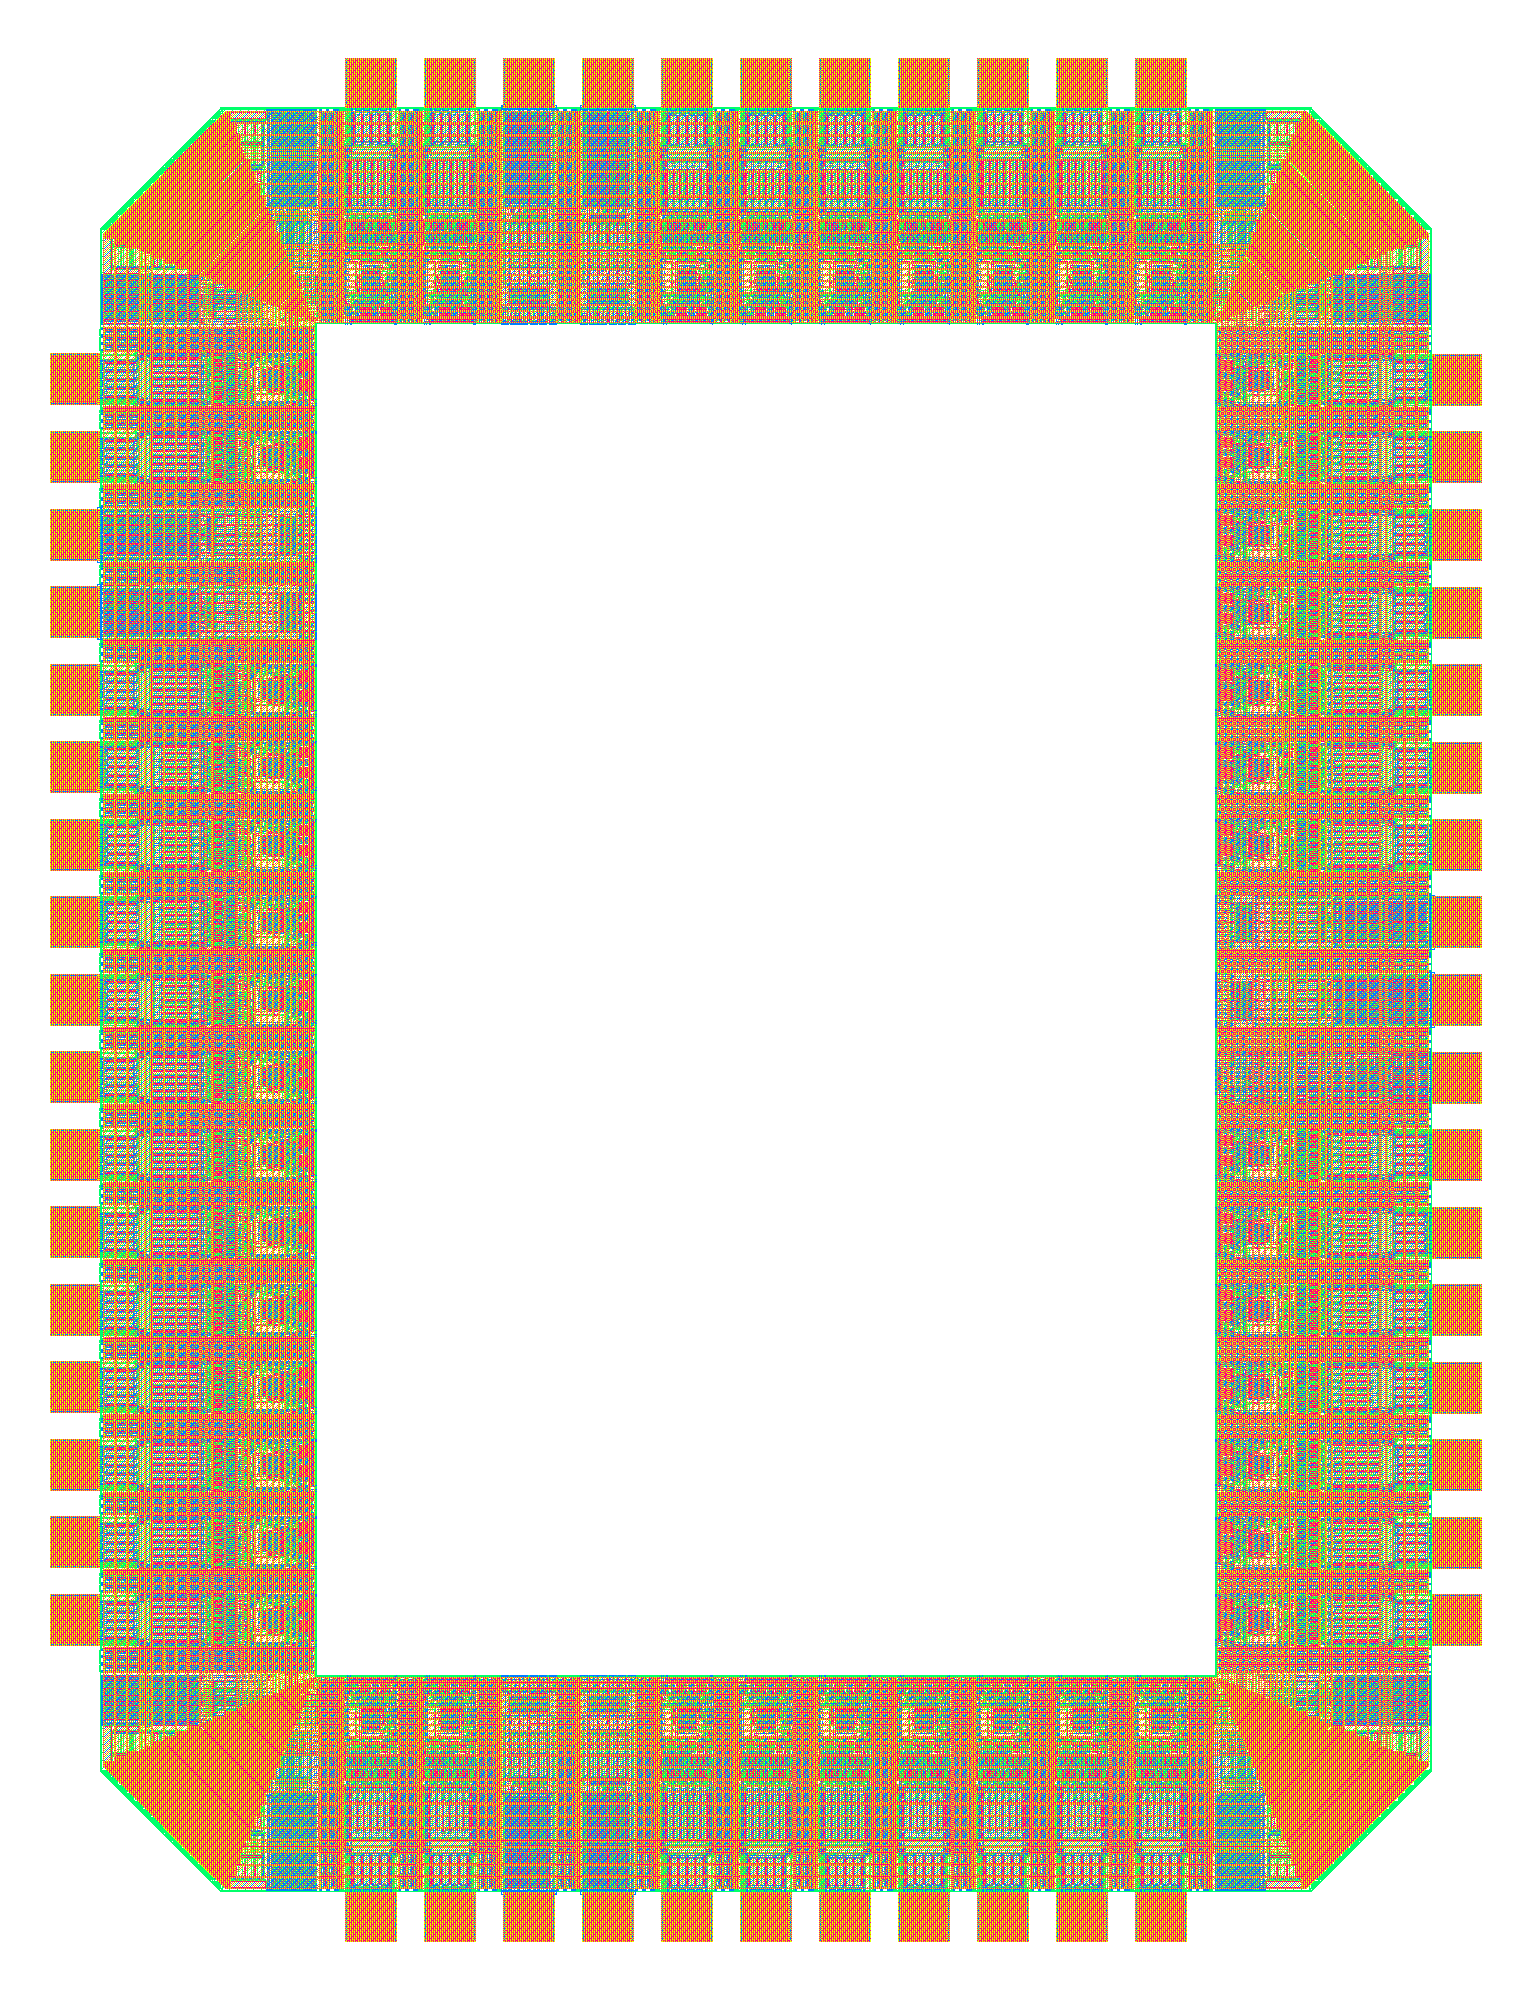
IO 在应对静电放电方面也起着关键作用。(许多电子设备都死于它之手,包括我妹妹的笔记本电脑——我 15 岁时在给她升级 ram 时可能或可能没有把它弄死。🪦)
每个引脚都包含这样的结构:在
因此,可以让 I/O 和内部设计运行在不同电压下。使用不同电源的区域称为电源域。例如,I/O 可以运行在 5V,接收 5V 输入信号并驱动 5V 输出,而芯片核心内部则以 3.3V 运行逻辑。在这种情况下,我们会为 I/O 供电和为内部核心供电使用不同的引脚。但在这颗网络芯片中,核心电源与 IO 电源短接,二者处于同一电源域。
这种方案之所以可行,只是因为说得委婉些,代工厂提供的 7 track 标准单元库很皮实。该单元的目标工作范围是 1.62 至 5.5V 电压,以及 -40 至 125C。
因此,将 IO 和核心电压短接,并决定让整个器件运行在 5V,不过是再平常不过的星期二。
        ┏━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━┳━━━━━━━━━━┳━━━━━━━━━━┳━━━━━━━━━━┳━━━━━━━━━━┳━━━━━━━━━━━┳━━━━━━━━━━┳━━━━━━━━━━━┳━━━━━━━━━━┳━━━━━━━━━━━┳━━━━━━━━━━┳━━━━━━━━━━━┓
┃                      ┃ 保持     ┃ 寄存器到 ┃          ┃          ┃ 其中     ┃ 建立     ┃ 寄存器到 ┃           ┃ 建立     ┃ 其中      ┃          ┃           ┃
┃                      ┃ 最差     ┃ 寄存器   ┃          ┃ 保持违规 ┃ 寄存器到 ┃ 最差     ┃ 寄存器   ┃           ┃ 违规     ┃ 寄存器到  ┃ 最大电容 ┃ 最大转换  ┃
┃ 角落/分组            ┃ 裕量     ┃ 路径     ┃ 保持 TNS ┃ 计数     ┃ 寄存器   ┃ 裕量     ┃ 路径     ┃ 建立 TNS  ┃ 计数     ┃ 寄存器    ┃ 违规…    ┃ 违规…     ┃
┡━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━╇━━━━━━━━━━╇━━━━━━━━━━╇━━━━━━━━━━╇━━━━━━━━━━╇━━━━━━━━━━━╇━━━━━━━━━━╇━━━━━━━━━━━╇━━━━━━━━━━╇━━━━━━━━━━━╇━━━━━━━━━━╇━━━━━━━━━━━┩
│ Overall              │ 0.1951   │ 0.2897   │ 0.0000   │ 0        │ 0        │ -5.5684   │ -5.5684  │ -1272.41… │ 1065     │ 1060      │ 145      │ 2601      │
│ nom_tt_025C_3v30     │ 1.0471   │ 1.0471   │ 0.0000   │ 0        │ 0        │ 3.7457    │ 7.6040   │ 0.0000    │ 0        │ 0         │ 136      │ 1204      │
│ nom_ss_125C_3v00     │ 2.3477   │ 2.3477   │ 0.0000   │ 0        │ 0        │ -4.5534   │ -4.5534  │ -973.8862 │ 353      │ 352       │ 137      │ 2410      │
│ nom_ff_n40C_3v60     │ 0.4488   │ 0.4878   │ 0.0000   │ 0        │ 0        │ 4.6815    │ 12.7768  │ 0.0000    │ 0        │ 0         │ 136      │ 532       │
│ min_tt_025C_3v30     │ 1.0388   │ 1.0388   │ 0.0000   │ 0        │ 0        │ 3.7448    │ 8.0005   │ 0.0000    │ 0        │ 0         │ 130      │ 1149      │
│ min_ss_125C_3v00     │ 2.3336   │ 2.3336   │ 0.0000   │ 0        │ 0        │ -3.7267   │ -3.7267  │ -764.3782 │ 296      │ 295       │ 131      │ 2304      │
│ min_ff_n40C_3v60     │ 0.4466   │ 0.4826   │ 0.0000   │ 0        │ 0        │ 4.6844    │ 12.9664  │ 0.0000    │ 0        │ 0         │ 130      │ 481       │
│ max_tt_025C_3v30     │ 1.0579   │ 1.0579   │ 0.0000   │ 0        │ 0        │ 3.7465    │ 7.0758   │ 0.0000    │ 0        │ 0         │ 141      │ 1320      │
│ max_ss_125C_3v00     │ 2.3651   │ 2.3651   │ 0.0000   │ 0        │ 0        │ -5.5684   │ -5.5684  │ -1272.41… │ 416      │ 413       │ 142      │ 2601      │
│ max_ff_n40C_3v60     │ 0.4527   │ 0.4945   │ 0.0000   │ 0        │ 0        │ 4.6771    │ 12.4714  │ 0.0000    │ 0        │ 0         │ 140      │ 641       │
│ nom_tt_025C_5v00     │ 0.5200   │ 0.6317   │ 0.0000   │ 0        │ 0        │ 4.5785    │ 11.4278  │ 0.0000    │ 0        │ 0         │ 139      │ 673       │
│ nom_ss_125C_4v50     │ 1.1099   │ 1.3887   │ 0.0000   │ 0        │ 0        │ 3.5360    │ 4.4721   │ 0.0000    │ 0        │ 0         │ 139      │ 1444      │
│ nom_ff_n40C_5v50     │ 0.1981   │ 0.2942   │ 0.0000   │ 0        │ 0        │ 5.0271    │ 14.5140  │ 0.0000    │ 0        │ 0         │ 139      │ 249       │
│ min_tt_025C_5v00     │ 0.5113   │ 0.6248   │ 0.0000   │ 0        │ 0        │ 4.5846    │ 11.6500  │ 0.0000    │ 0        │ 0         │ 133      │ 648       │
│ min_ss_125C_4v50     │ 1.0892   │ 1.3768   │ 0.0000   │ 0        │ 0        │ 3.5474    │ 4.8628   │ 0.0000    │ 0        │ 0         │ 134      │ 1365      │
│ min_ff_n40C_5v50     │ 0.1951   │ 0.2897   │ 0.0000   │ 0        │ 0        │ 5.0285    │ 14.6577  │ 0.0000    │ 0        │ 0         │ 132      │ 223       │
│ max_tt_025C_5v00     │ 0.5316   │ 0.6407   │ 0.0000   │ 0        │ 0        │ 4.5719    │ 11.1135  │ 0.0000    │ 0        │ 0         │ 143      │ 784       │
│ max_ss_125C_4v50     │ 1.1382   │ 1.4034   │ 0.0000   │ 0        │ 0        │ 3.5178    │ 3.8667   │ 0.0000    │ 0        │ 0         │ 145      │ 1518      │
│ max_ff_n40C_5v50     │ 0.2026   │ 0.3003   │ 0.0000   │ 0        │ 0        │ 5.0257    │ 14.3356  │ 0.0000    │ 0        │ 0         │ 143      │ 449       │
└──────────────────────┴──────────┴──────────┴──────────┴──────────┴──────────┴───────────┴──────────┴───────────┴──────────┴───────
构建网络交换机 ASIC 芯片
────┴──────────┴───────────┘
另一块我正在设计的芯片的随机时序报告示例,涵盖 3 到 5.5V 和 -40 到 125C 的工艺角。再说一次,这仍然只是所有工艺角中的一个子集:还有更多来自这里!

供参考,这稍微有点不寻常。

大多数设计都有独立的电源域,因为现代工艺节点的单元库为低得多的的工作电压而设计,以帮助降低面积功率密度,使散热更容易,并帮助优化功耗。在先进节点的情况下,内部逻辑的目标工作电压低至 0.7 到 0.8 V。这迫使至少要有独立的 IO 和核心电源域,因为你的 IO 通常从 1.8V 及以上开始。

然而,有时即使工作电压相同也需要独立电源域,例如你想将敏感的模拟模块与快速翻转的数字部分引起的电源噪声隔离。你甚至可能将这种模拟和数字电源域的分离延伸到 IO,在这种情况下,不是让一个完全连接的焊盘环在同一电源域内工作,而是将焊盘环拆分为模拟 IO 电源和数字 IO 电源。

还记得我之前谈到的填充单元吗?嗯,存在一种特殊类型的填充单元,称为分离器,专门用于在这种情况下拆分焊盘环。但是,由于 ESD 问题,这个分离器并不像断开电源线那么简单,但那是改天再讨论的话题。

## 时钟与复位#

该芯片的时钟通过一个施密特触发输入引脚提供,并被

在 RTL 中,我们有一个称为参数的概念,它存在于模块的实例中,并允许你在例化时定义某些值。这些值随后可用于调整总线位宽,或作为类似宏的条件来定义哪些代码段应包含在最终硬件中。
module add#( parameter W = 8 )( input wire [W-1:0] a_i, input wire [W-1:0] b_i, output wire [W-1:0] res_o, output wire carry_o ); assign {carry_o, res_o} = a_i + b_i; endmodule
这些通用值随后可以沿设计层次结构向下继承,使依赖模块能够相应地调整规模。
## 复杂度#
最初的交换机实现是部分通用的:它包含了不少通用值,但这些值大多是出于习惯而添加的,用于帮助清理设计并保持更好的可读性,而不是真正让设计维度完全可配置。
不把设计做成完全通用,是出于一个经过权衡的决定:尽可能避开不必要的复杂性。最初的设计面临 Tiny Tapeout 引脚数这一硬性物理约束,因此把它做成完全通用以支持任意数量的端口,会是一次不必要的过早优化,而且最重要的是会付出复杂性代价。
我对复杂性的厌恶来自两个经过权衡的取舍。
首先,我发现增加复杂性比移除复杂性要便宜几个数量级。
其次,复杂性对硬件设计尤其昂贵,因为硬件中必须没有任何 bug。达到这种无 bug 状态的唯一方法,是通过思维验证在所有可能场景下的运行情况。随着我们增加复杂性,我们会增加硬件状态,以至于需要探索的状态空间大小呈指数增长。
现在我知道指数增长听起来可能像夸张,毕竟指数增长如此之快,以至于我们的大脑很难想象,但我向你保证我不是在夸张。
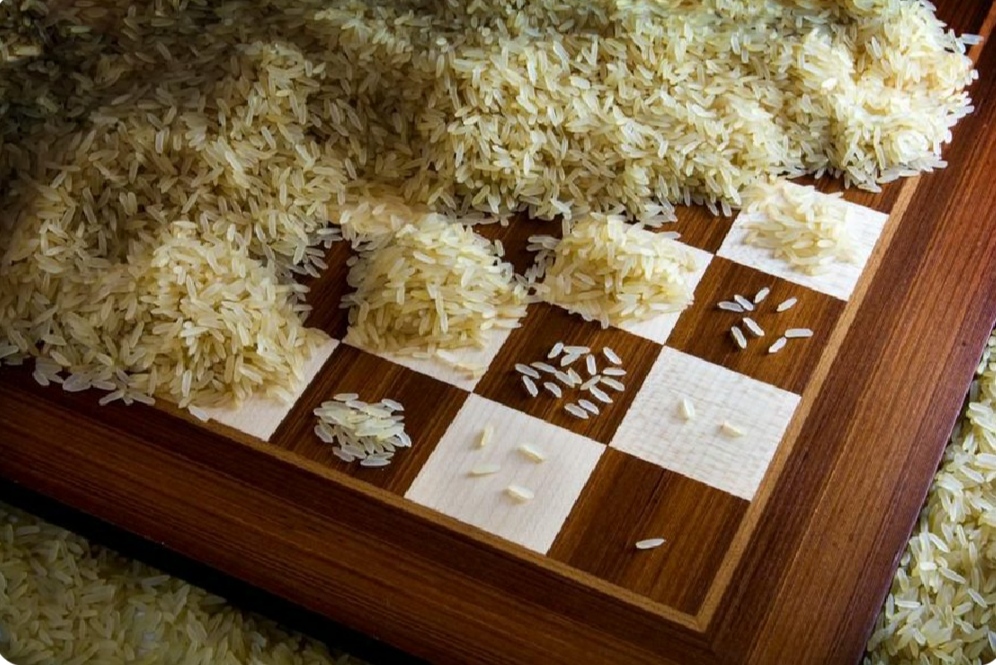
这个问题更正式的名称是“状态爆炸问题”。
## 扩大规模#
因此,交换机最大的变化是将支持的端口数从固定的三个改为通用数量。
即使 RTL 可以扩展,理论上我可以用 48 个端口运行仿真,逻辑本身仍然有扩展限制。毕竟,在代码抽象的背后,我们设计的是硬件逻辑,物理约束仍然适用。
随着结构变宽,路径上的逻辑元件数量增加,路径在物理上变长,时序随之恶化。因此,在可用核心面积为 \(1.73mm^2\) 的情况下,时序是我首先撞上的墙。
鉴于交换机的时序已经相当紧张,把它扩展得太远会将其推出现有设计的限制,从而需要重新思考架构。而重新思考是我在如此短的时间内无法承担的。
最后,我说过我在扩展端口数量,但由于交换机查找表的时序已经非常紧张,它并没有被扩展。而且因为它仍然只有四个表项,扩展到超过四个端口会导致表上争用过多、命中不足,所以目前超过 4 个端口没有任何意义。
因此,我最终确定交换机使用四个端口。
## 引脚对应关系#
既然我现在控制完整的 ASIC 布局,我也能精确控制哪个信号映射到焊盘环上的哪个引脚。
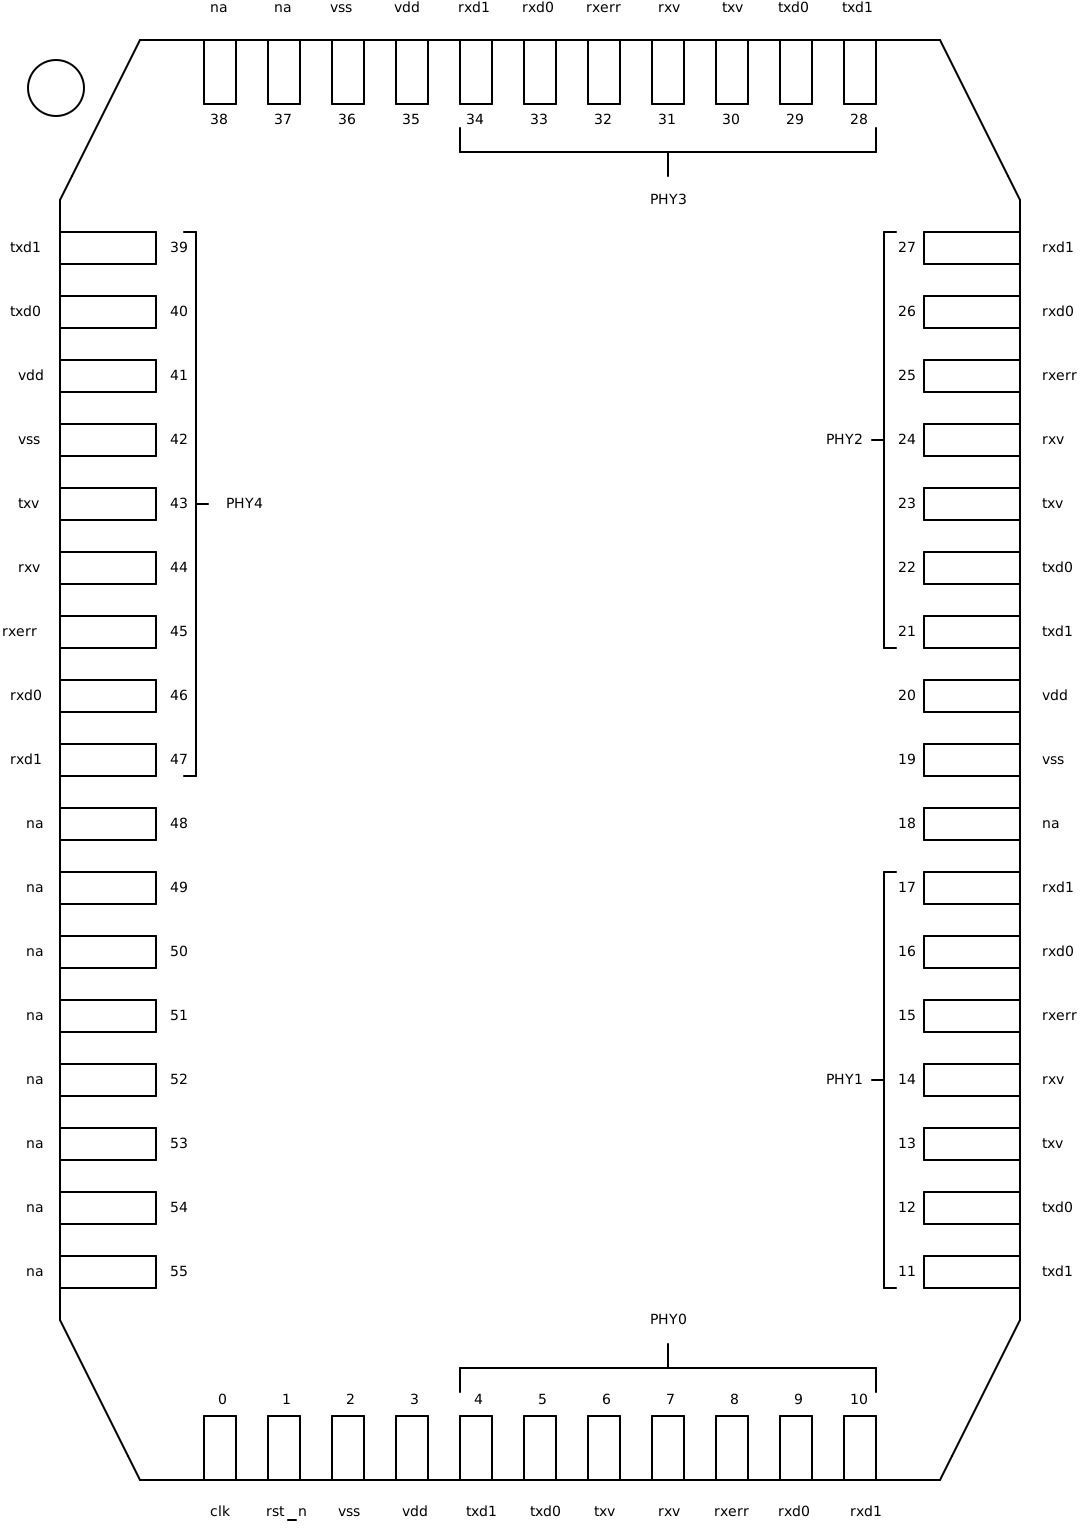
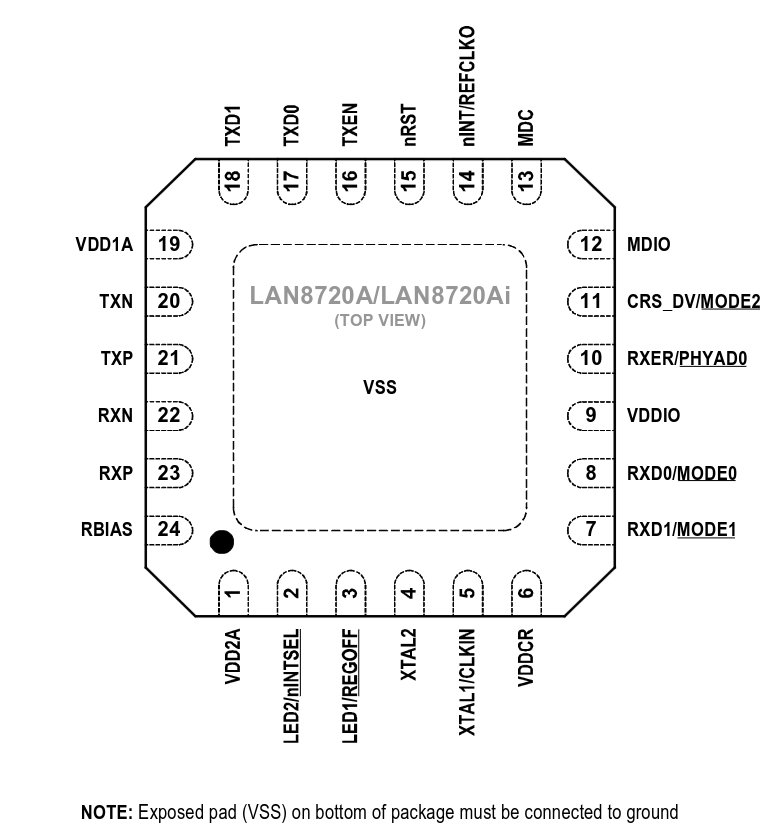
由于该交换机原本打算与 Microchip 某个特定系列的外部物理层芯片配合工作,而这些芯片具有已知的引脚定义,我决定根据在 PCB 上绘制连接线能有多直接来选择引脚顺序。
## Beacon#
交换机规模限制最好的“缺点”之一,是我只剩下几个引脚,以及一大片可以折腾的面积。
而不同于 Tiny Tapeout 中多个项目共享同一套公共基础设施、同一时间只能启用一个项目,这一次我可以让多个设计并行工作。而我正好有一个完美的项目可以并行加入。
几个月前,我做了整个互联网都知道不该做的两件事:第一,我去 Reddit 征求建议;第二,我照做了。
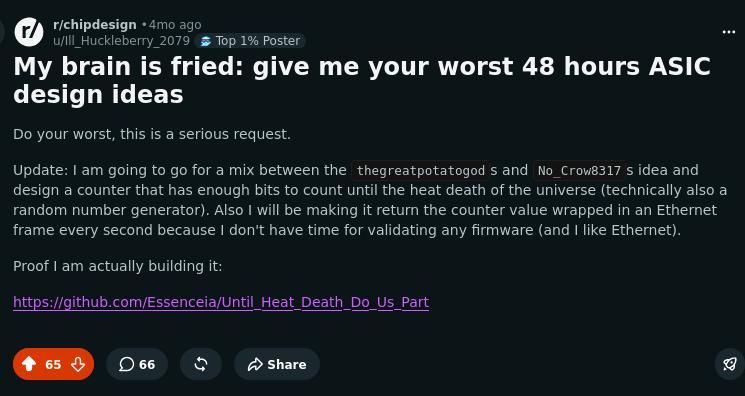
这个项目叫“Until Heat Death Do Us Part”,是一个非常严肃的实现:一个通过以太网连接的信标,用 100 Mbit 以太网广播当前时间,并且能够在接下来的 \(10^{100}\) 年里不溢出地做到这一点。也被认为大致相当于宇宙热寂的估计时间,上下差个 10 的若干次方年。
一直计数到宇宙热寂,并每秒通过 100Mbps 以太网广播这个计数器。
关于这个 ASIC 的完整文章我放在这里,给那些想了解完整故事的人:Until Heat Death Do Us Part。
## 完整芯片#
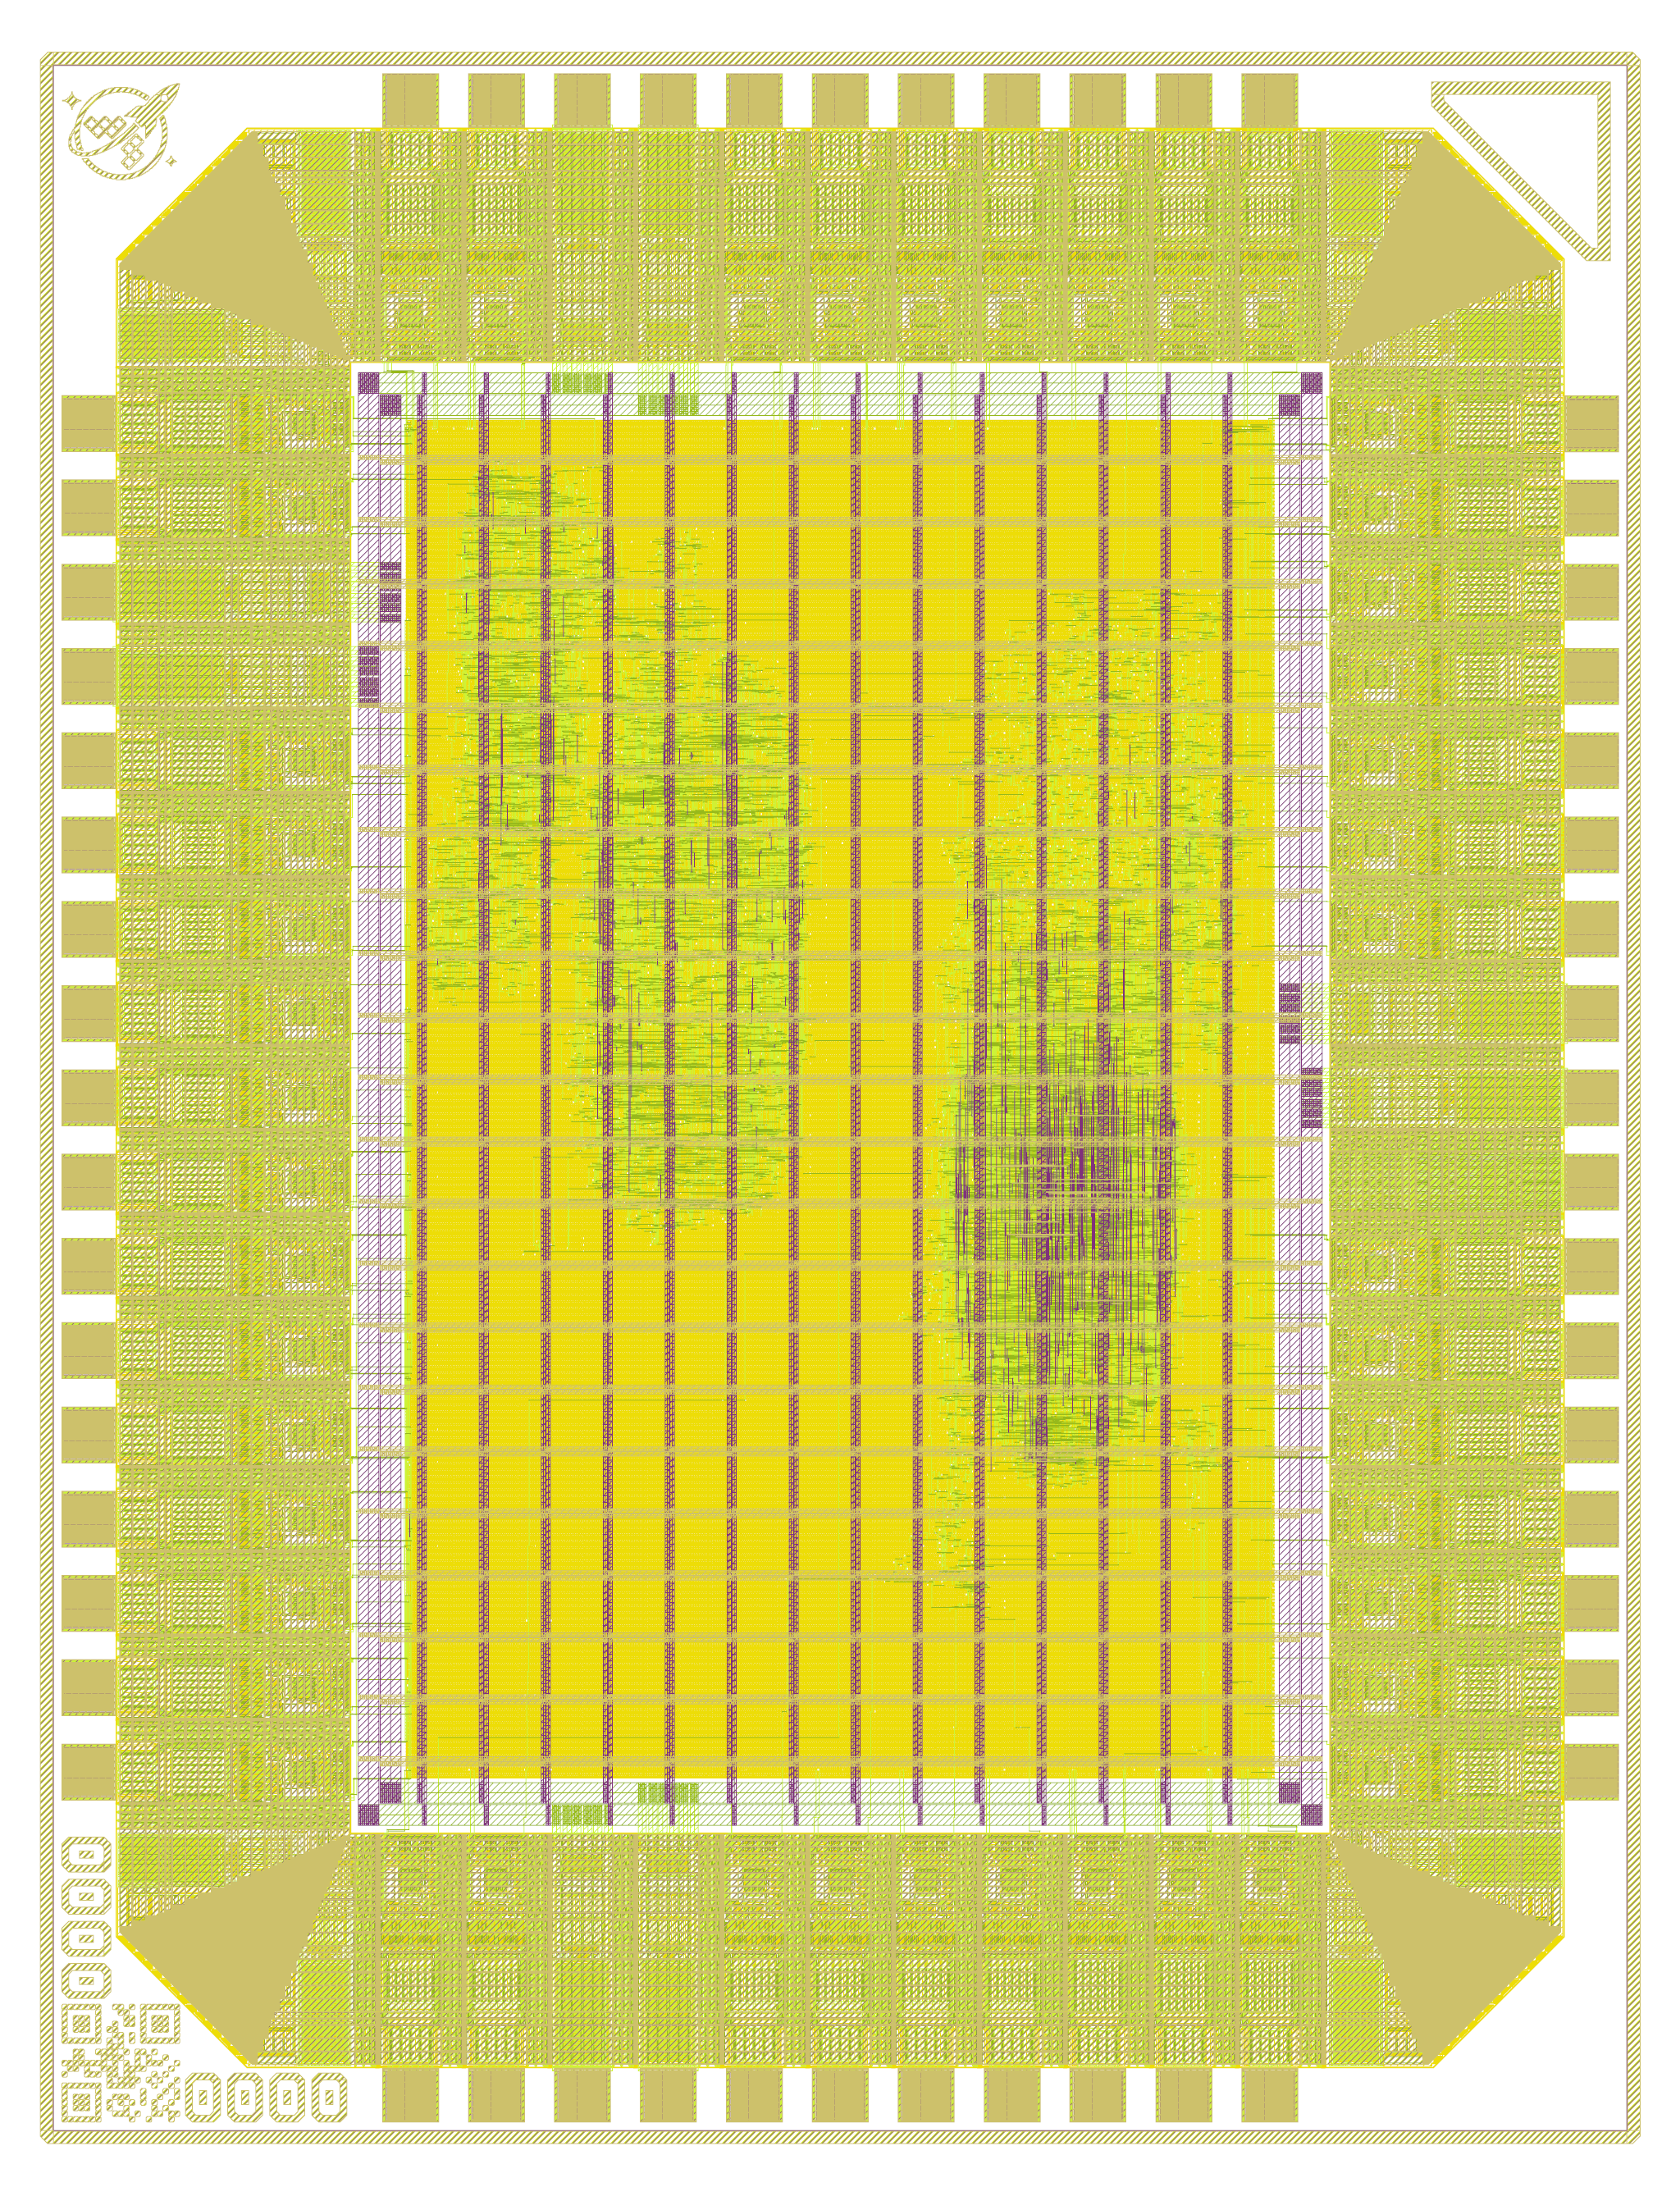
把它们整合在一起:这个芯片包含两个设计,4 端口 100Mbps 网络交换机和以太网广播信标。网络交换机是布局图右侧更密集的设计,信标在左侧,每个设计都放置在各自对应的端口引脚旁边
构建网络交换机 ASIC 芯片
至于选择哪种 CPU 架构的问题,尽管 RISC-V 很流行,但我发现,由于 RISC-V 的架构选择,对于像我这样的系统来说,它在面积方面的实现成本实在太高了。
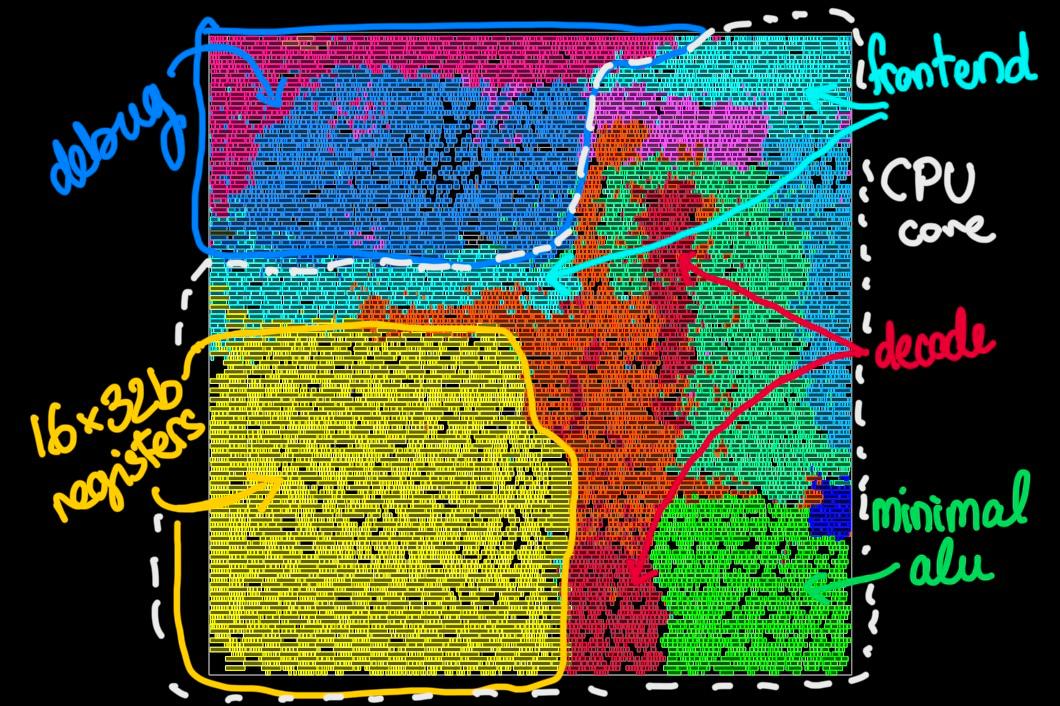
选择要使用的 CPU 架构时,我的需求是:
- 硬件实现成本低
- 有现成的软件生态,也就是有 C 编译器和调试器支持
- 不会让我被起诉
要是 gcc 能维护一份类似 https://gcc.gnu.org/backends.html 上“Status of Supported Architectures from Maintainers’ Point of View”的东西,那么也许我就能知道我的选项有哪些。
Architecture characteristic key
H A hardware implementation does not exist. M A hardware implementation is not currently being manufactured. S A Free simulator does not exist. L Integer registers are narrower than 32 bits. Q Integer registers are at least 64 bits wide. N Memory is not byte addressable, and/or bytes are not eight bits. F Floating point arithmetic is not included in the instruction set I Architecture does not use IEEE format floating point numbers C Architecture does not have a single condition code register. B Architecture has delay slots. D Architecture has a stack that grows upward.
l Port cannot use ILP32 mode integer arithmetic. q Port can use LP64 mode integer arithmetic. r Port can switch between ILP32 and LP64 at runtime. (Not necessarily supported by all subtargets.) p Port uses define_peephole (as opposed to define_peephole2). b Port uses '"* ..."' notation for output template code. f Port does not define prologue and/or epilogue RTL expanders. m Port does not use define_constants. g Port does not define TARGET_ASM_FUNCTION_(PRO|EPI)LOGUE. i Port generates multiple inheritance thunks using TARGET_ASM_OUTPUT_MI(_VCALL)_THUNK. a Port uses LRA (by default, i.e. unless overridden by a switch). t All insns either produce exactly one assembly instruction, or trigger a define_split. e <arch>-elf is not a supported target. s <arch>-elf is the correct target to use with the simulator in /cvs/src.
文章标题:构建一个网络交换机ASIC芯片

正文:
|      特性
目标     | HMSLQNFICBD lqrpbfmgiates
-----------+--------------------------
aarch64    |     Q        q  b  gia  s
alpha      |  ?  Q   C    q    mgi  e
arc        |          B      b  gia
arm        |                 b   ia  s
avr        |    L  FI    l  p   g a
bfin       |       F            gi
bpf        | HM  Q FIC   lq  b    a
c6x        |   S     CB         gi
cris       |       F  B         gia  s
csky       |                 b   ia
epiphany   |         C          gia  s
fr30       | ??    FI B     pb mg    s
frv        | ??       B      b   i   s
gcn        |   S     C D  q       a e
h8300      |       FI B         g a  s
i386       |     Q        q  b   ia
ia64       |   ? Q   C    qr b m i
iq2000     | ???   FICB      b  g at
lm32       |       F            g
m32c       |    L  FI    l   b  g    s
m32r       |       FI        b    a  s
m68k       |                pb   i
mcore      |  ?    FI       pb mg    s
mep        |       F C       b  g  t s
microblaze |         CB          ia  s
mips       |     Q   CB   qr     ia  s
mmix       | HM  Q   C    q      ia e
mn10300    | ??                 gi   s
moxie      |       F            g  t s
msp430     |    L  FI    l   b  g    s
nds32      |       F C           ia  s
nios2      |         C           ia
nvptx      |   S Q   C    q    mg   e
pa         |     Q   CBD  qr b   i  e
pdp11      |    L   IC    qr b      e
pru        |    L  F              a  s
riscv      |     Q   C    qr    gia
rl78       |    L  F     l      g    s
rs6000     |     Q   C    qrpb   ia
rx         |                         s
s390       |     Q        qr    gia e
sh         |     Q   CB   qrp    i
sparc      |     Q   CB   qr b   ia
stormy16   | ???L  FIC D l   b   ia
v850       |                    g a  s
vax        |  M     I        b   i  e
visium     |          B         g  t s
xtensa     |         C
看哪:支持如此多美丽的选项,大多数人甚至从未听说过它们!
而在这份列表中,有一个 16 位架构吸引了我的目光,它处于一个生产周期最长的系统核心,并且与计算机历史深度交织,因为它见证了第一个用 C 语言编写的 Unix 版本。
还有什么比 PDP-11 更好的选择呢?
结语
一年前,我踏上了一段旅程,从一名纯粹的硬件设计师,转变为在没有任何机构支持的情况下从零构建一整块 ASIC。
这是一条漫长的道路,其间经历了多次较小的 macro tapeout,每一次都让我更深入地了解制造 ASIC 需要什么。这块芯片是我的第 10 次单人 tapeout,这个数字恰如其分,终于让我毕业进入构建完整芯片的阶段。
站在这座山上,我可以告诉你,前方的路仍然很长。
而随着我的第一批全定制 ASIC 在几周后寄到我的邮箱,一个新的风险浮现了出来,促使我宣布一个新目标:不创办一家无晶圆厂半导体公司。
当前的人生目标
- 与所爱之人共度时光
- 搞到一台引线键合机
- 不找工作
- 不创办无晶圆厂半导体公司 🆕
再次感谢 wafer.space 给我加入 shuttle 的机会,感谢 Tiny Tapeout 让之前的 9 次 tapeout 成为可能,也感谢开源硅社区构建了让这一切成为可能的工具。
如果你喜欢这些,我将在 11 月 10 日至 12 日期间,在硅谷某个社区咖啡馆里喝咖啡,所以如果你想就着咖啡因一起畅聊技术,给我发封邮件吧。