 Newshot
文章标题:深入解析 GitHub 全新的 Git 存储架构
正文: 上周在 GitHub Universe 大会上,我们发布了全新的 Git 存储架构,能够每秒处理数千次写入,读取能力可按需扩展。通过内部测试,我们已证明该架构能够支持 5,000 个并发 agent 在同一个仓库上工作,每秒向一个仓库发送 7,200 次 push,同时以持续低延迟处理读取流量。这一新架构是 GitHub 支持数亿开发者进行 agentic 开发的基础,我们一直在 GitHub 运行的同时在其底层构建这一架构。
过去一年里,agent 改变了 GitHub 上繁忙仓库的面貌。在本系列的第一篇文章中,我们阐述了下一代 Git 存储架构背后的两项原则:最小化协调,以及将存储与计算解耦。在上一篇文章中,我们介绍了过渡方案:将 99.99999% 的仓库迁移到 Azure,将写入法定人数限定到单个引用,以及搭建由 Azure Blob Storage 支持的虚拟副本。
我们还留下了一个观察:写入中只有很少一部分需要排序。Git 对象是不可变的,并以其内容命名,这意味着两个写入者可以同时存储它们而无需就任何事情达成一致。push 中需要达成一致的部分是引用更新,而引用更新相比之下非常小。虚拟副本是围绕这一点进行构建的第一步,也是我们将仓库接入新架构的手段。
架构的其余部分建立在这一观察之上。只有引用更新需要达成一致。这使得 Git 基础设施中过去紧密耦合的部分(存储数据、处理请求和维护仓库)能够独立扩展。对开发者而言,Git 依然是 Git:他们以相同的方式 push、fetch 和创建分支,相同的保护机制依然到位。下面,我们将梳理设计背后的需求,跟踪一个请求在整个系统中的流转,并深入探讨其中的两个组件。
为 agent 规模而构建
我们从两个维度来思考 GitHub 平台的规模:
- 水平规模是指有多少开发者和 agent 能够在众多仓库上工作。GitHub 当前在这一维度上的许多方法已经过多年的实战检验,并被延续到新架构中:跨基础设施的租户分区、租户流量的隔离和/或公平性保障,以及负载感知路由,等等。
- 垂直规模是指有多少开发者和 agent 能够在单个仓库上工作。随着 agent 编写更多代码,我们预计单个仓库会变得更大、更繁忙,因此我们的大部分需求来自垂直维度。
如今,GitHub.com 上最繁忙的仓库每秒最多收到几十次写入,通常以短时突发形式出现。随着更多工作转向并行、全天候运行的 agent,我们预计这些突发将在未来一年内变成持续速率。每次 push 都会带来更多读取:CI 运行、部署系统拉取新提交,以及其他 agent 获取它以了解上下文。这种读取扇出会对整体流量产生巨大的放大效应,并随写入量扩展。
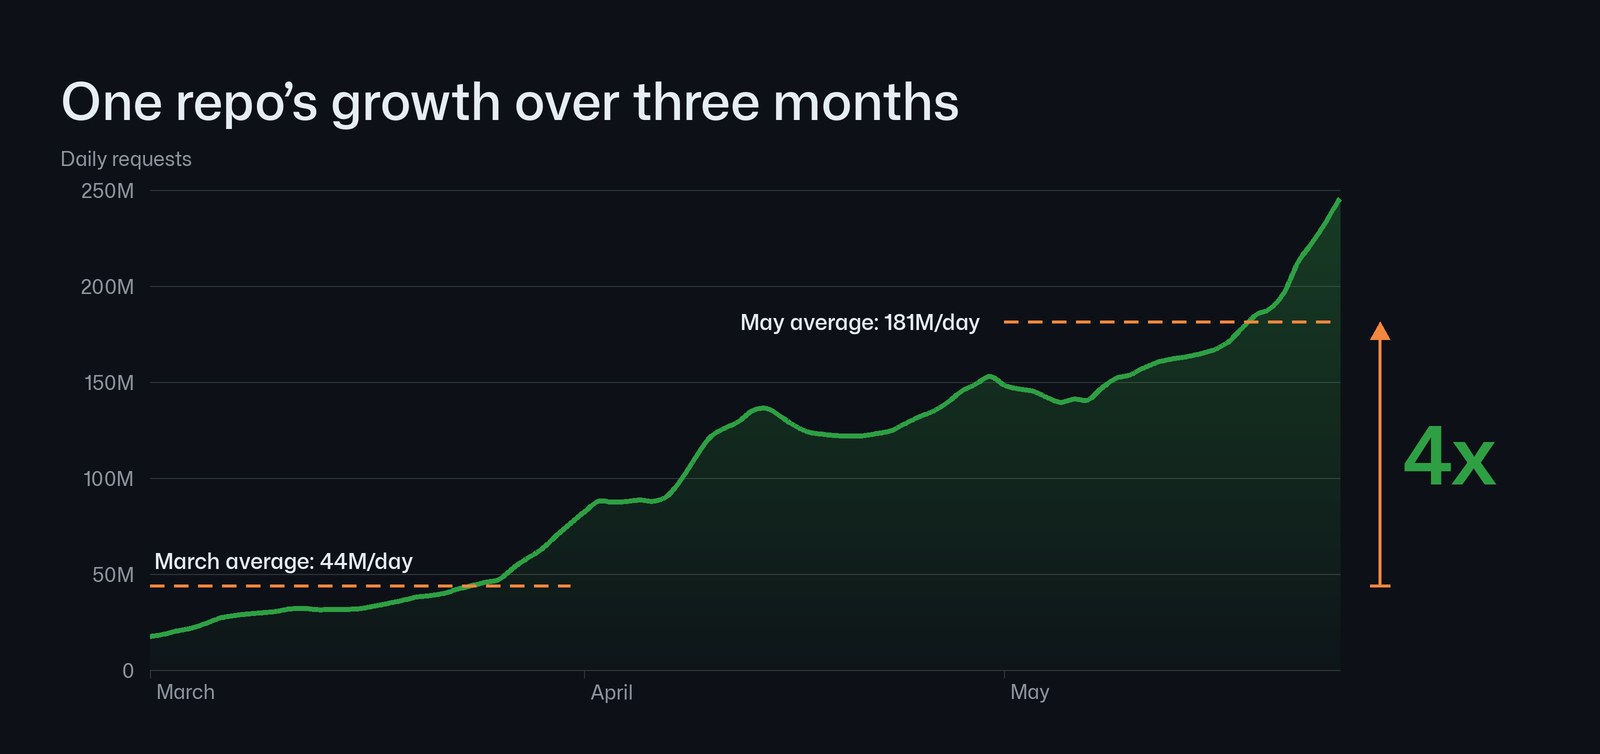
我们已经在曲线顶端的仓库上看到了这一趋势的演变。下图展示了一个 GitHub 仓库从 3 月到 5 月的每日请求量,其流量增长了约 4 倍。自那以后,其增长一直保持指数级轨迹。
我们必须为一个 agent 驱动的开发持续以这一速度加速的世界做好规划。我们没有按下一个增量来规划,而是设定了至少两个数量级以上的规模目标。对于单个仓库而言,这意味着新架构需要:
- 每秒接受数千次写入。
- 支持多个写入节点。这有两个原因:经验告诉我们,对传入的 pack 进行索引以及检查对象连通性是写入过程中最消耗 CPU 的部分,而且这一开销会随写入大小而扩展,因此单个节点很快就会达到计算瓶颈。将这项工作分散到多个节点上可以提高容错能力,并在节点故障时缩短恢复时间。
- 经验告诉我们,对传入的 pack 进行索引以及检查对象连通性是写入过程中最消耗 CPU 的部分,而且这一开销会随写入大小而扩展,因此单个节点很快就会达到计算瓶颈。
- 将这项工作分散到多个节点上可以提高容错能力,并在节点故障时缩短恢复时间。
- 最小化提交延迟。代理会在每次推送时等待,然后才进入下一步。
- 按顺序记录每个引用的变更,并具备跨引用快速线性化的能力。落后的虚拟副本需要仅下载其服务传入请求所需的数据来追赶进度。
- 在没有任何变化时保持读取开销低廉,考虑到读写比例,这是常见情况。
- 让每个组件独立扩展。
在此基础上,系统还必须能够在全球范围内提升整体可靠性和扩展能力。
推出 “Project Rubicon”
2026 年 5 月,紧接在最初的 Azure 迁移之后,我们开始设计一个能够满足这些需求的方案。我们尝试了几种方法。在所有这些方法中,pack 数据都存放在 Azure Blob Storage 中,其中一些方法我们还尝试将引用状态也存放在那里。我们将在下文介绍发现的一些权衡,但最终确定了一个我们认为能最大化吞吐量、同时保持 GitHub 这样的平台所需的正确性、持久性、可用性和延迟保证的设计。我们将其称为 “Rubicon”,以此致敬行业在智能体开发上跨过的不可回头的临界点。
让我们自上而下地了解 Rubicon。许多东西保持不变:来自 Git 客户端、API 和 Web UI 的请求到达 Spokes,Spokes 仍然负责路由和负载均衡,并提供 GitHub 其余部分用于读写仓库数据的内部 API。Spokes 还保持其作为放置和均衡服务的角色,维护水平扩展所需的分区、隔离和租户公平性。相比之下,Spokes 下方的数据平面是全新的。
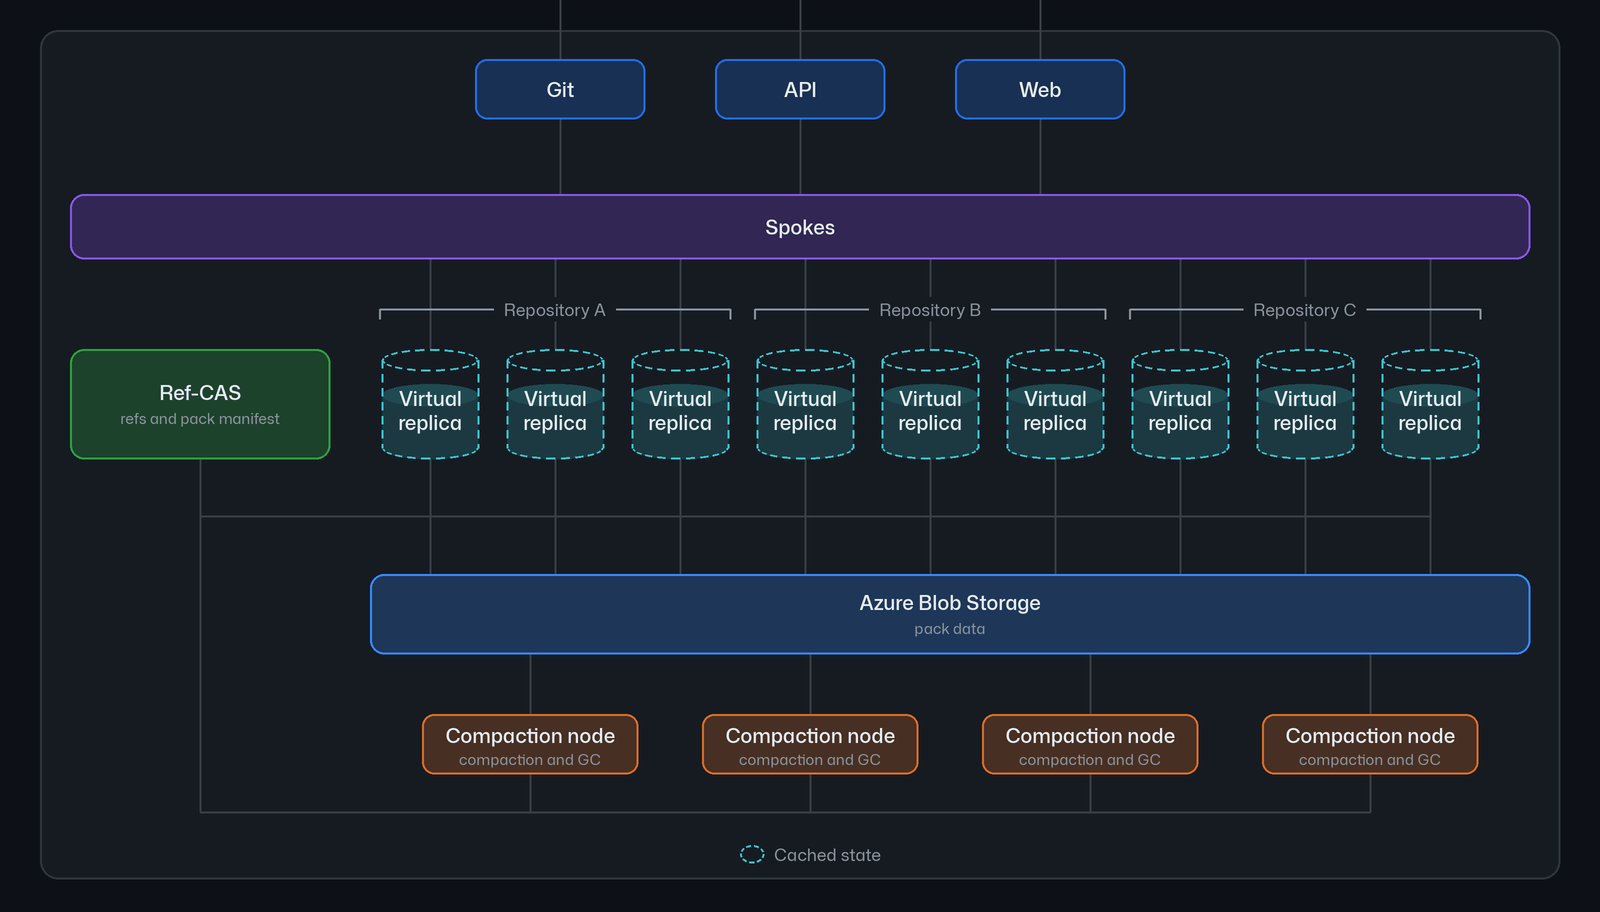
Spokes 将每个请求路由到分配给该仓库的一小组虚拟副本之一。虚拟副本是一组一次性计算资源,可同时服务读取、写入或两者兼有。虚拟副本的本地磁盘是一个可以随时重建的缓存。
Spokes 会尽可能将仓库的流量路由到相同的虚拟副本,以保持其缓存热度并降低延迟,但正确性并不依赖于请求落在任何特定的虚拟副本上。当某个虚拟副本消失时,该仓库的其他虚拟副本会继续提供服务,而替代者会随着流量的到来填充其缓存。
当仓库变得繁忙时,我们会增加更多虚拟副本。另外,一组压缩节点在后台直接针对 Blob Storage 和 Ref-CAS 工作,合并每个仓库的 pack 并移除不可达对象。这项工作从不在虚拟副本上运行,这意味着它们的 CPU 和内存几乎可以完全专用于服务请求。
持久状态存放在两个地方:
深入解析 GitHub 全新 Git 存储架构
- Git 对象以 pack 和辅助读取加速数据的形式,存放在 Azure Blob Storage 中。
- 引用和构成仓库的 pack 列表(pack 清单)存放在一个独立的复制日志服务中,我们称之为 Ref-CAS(意为“Reference Compare-and-Swap”)。
让我们从写入和读取的角度来了解这一架构:
- 写入:虚拟副本对传入的 pack 建立索引并上传至 Blob Storage,然后向 Ref-CAS 提交一个事务,在清单中列出该 pack 并更新引用。随后,一个 compaction 节点将该 pack 与其他 pack 合并,以保持读取速度。
- 读取:虚拟副本向 Ref-CAS 查询其引用版本,从 Blob Storage 拉取所需的 pack 到其缓存中,并从那里提供读取服务。
在新架构中,我们采用了许多不同的方法,从虚拟副本上的软件栈,到针对不同用例(例如大量小型仓库 vs. 单个大型仓库)调整流量路由和工作负载调度。让我们深入探讨架构中的两个组件,围绕两条设计原则讲述它们的故事。
最小化协调:以高吞吐量变更引用状态
像 Azure Blob Storage 这样的对象存储服务在其擅长的领域表现出色,天然适合许多数据密集型应用,例如源代码存储。它们持久且可复制,容量可按需扩展,每字节成本相对较低,并且只要流量分散在大量键上,就能提供极高的聚合吞吐量。因此,新 Git 存储架构中几乎所有持久化数据都存放在 Azure Blob Storage 中,包括:
- 由推送、compaction 和垃圾回收写入的 pack 和索引。
- 我们的维护流程从这些 pack 构建的各种读取加速器(如 multi-pack 索引、可达性位图以及一些自定义格式)。
- 让 compaction 和垃圾回收能够恢复或审计其工作的记录,以及 compaction 节点用于认领工作的租约。
- 频繁重复 fetch 的缓存响应。
- 仓库引用状态的检查点,尽管并非用于服务请求的权威状态。
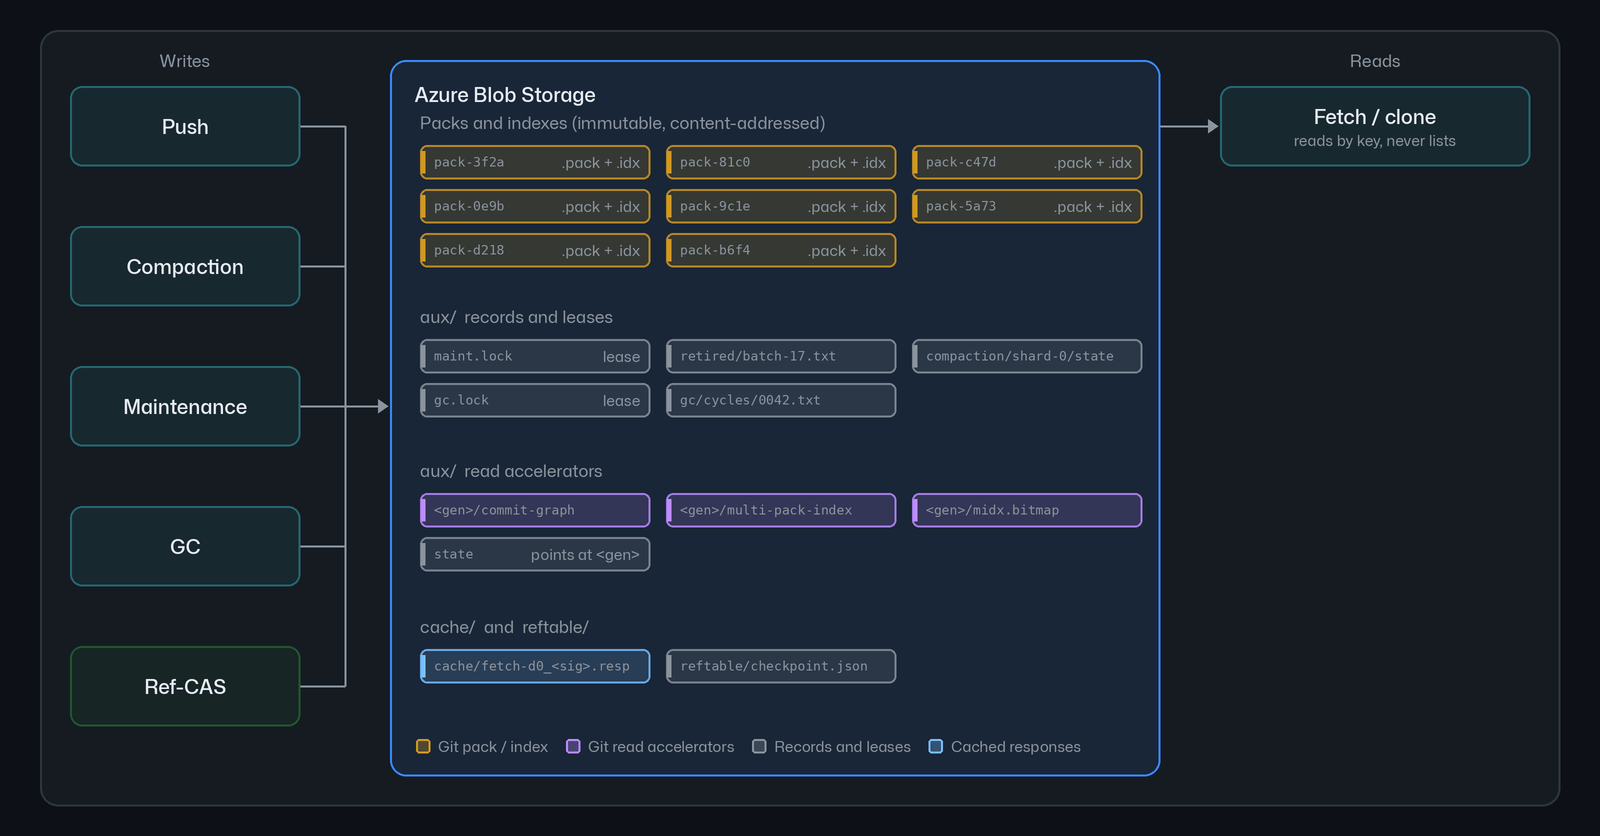
大部分数据一次写入一个独立的键,之后不再更改,这正是其非常适合 Blob Storage 的原因。
引用则恰恰相反。繁忙仓库的引用是一块相对较小的状态,许多写入会同时竞争更新它。这种访问模式更难由 Blob Storage 来服务,我们最初的几个原型向我们展示了原因。对于这类工作负载,对象存储是一种直观的选择,并且在一定规模范围内效果良好:条件写入免费提供了 compare-and-swap,而且数据已经是持久且可复制的。然而,我们遇到了一组艰难的选择,下面通过我们尝试的两种方法来加以说明。
我们的第一种方法是为仓库的所有引用建立一个 write-ahead log,由单个 blob 建立索引。每次更新都是针对该 blob 的条件写入。这是正确的,而且读取成本很低:虚拟副本询问该 blob 是否已更改,如果没有更改,就完成了。问题出在写入方面。同一时间只能有一个针对 blob 的条件写入在途,因此即使我们将写入期间到达的每次推送批量合并到下一次写入中,仓库的写入上限仍然是每次到单个 blob 的往返一次写入。在实践中,这给我们带来的写入吞吐量在每秒几百次左右。
我们的第二种方法将引用分散到多个分段 blob 中,每个引用通过哈希分配到其中一个。对不同分段中引用的写入不再相互等待,从而提高了上限。但读取现在必须检查每个分段才能知道是否有任何变化,而且其速度只取决于最慢的分段。我们用写延迟换取了读延迟,而读操作数量比写操作高出几个数量级。我们可以通过并排展示多个写入和一个读取来可视化这一点:
两种方案都没有满足所有要求,所以我们构建了别的东西:一个专用于引用的复制日志服务,即 Ref-CAS 服务。这就是我们在上一篇文章结尾所说的、仍然位于堆栈某处的(小型)共识组。下面是它的工作方式。
Ref-CAS 中的每次引用更新都是一次由多数派提交的比较并交换。事务只锁定它涉及的引用,检查每个引用是否仍具有写入者期望的值,并在日志的大多数副本记录后变为可见。代理大多推送到自己的分支,因此大多数更新不会争用,并且会并行复制。当两次推送确实更新同一个引用时,只有一次会追加到日志。
对 Ref-CAS 的每次提交都会获得一个日志序列号(LSN),仓库的版本是其最新提交的 LSN。读取首先针对该版本进行版本检查。虚拟副本发送它已持有的引用状态版本。如果该版本仍是最新,回复完全不携带引用,未变更的仓库只需一次比较。如果虚拟副本落后,它会取回当前引用和版本,以及指向 pack 数据的指针和其他需要知道的内容,例如上一次垃圾回收周期发生的时间。
与我们的旧架构中的共识组不同,Ref-CAS 从不持有或验证对象数据。它只存储指向它的指针。虚拟副本在提交引用事务之前,将一次推送的 pack 上传到 Blob Storage。引用只会指向已经持久化的对象。
这些方法让我们能够仅对引用状态进行事务处理,达到每秒数万次操作,并为复制日志上的附加注释提供基线,这些注释帮助读取决定针对给定请求下载什么。
但支持单个仓库每秒数千次写入会产生二阶问题:维持读写性能。为此,我们需要一种不同的压缩方法。
将存储与计算解耦:每秒数千次写入下的压缩
每次推送都会向 Blob Storage 添加一个 pack。Git 可以通过许多 pack 提供仓库服务,但每增加一个 pack 都会让查找稍微更昂贵,因此 pack 数量不能无限制增长。在我们的旧架构中,压缩运行在服务流量的同一批副本上,并且必须在每个副本上运行。在新架构中,它完全在后台的独立节点上运行,直接针对持久化存储,并使用 Ref-CAS 服务将演进中的状态通知虚拟副本。
压缩节点各自通过租约声明对仓库数据某个子集的所有权,这让我们能够横向扩展压缩。下面是一个压缩节点如何处理仓库 pack 的单个分片:
文章标题:深入解析 GitHub 全新的 Git 存储架构
正文: 节点首先会在 Blob Storage 中对分片获取租约,因此同一时间只有一个节点对某个分片执行 compaction。与此同时,虚拟副本会持续上传 pack,并把它们登记到 pack 清单中。节点读取清单以发现新的 pack,并将它们收集到一个开放段中;这个开放段实际上是待 compaction 数据的暂存区。当该段达到基于 pack 数量、大小或存续时间设定的阈值时,节点会封存该段,使其不再接受新的 pack,然后将其中的 pack 合并为数量更少、体积更大的 pack。在 compaction 进行期间,该分片的下一个段可以开始接收其输入 pack。在发布任何内容之前,节点会检查新的 pack 是否包含与输入完全相同的对象。随后它上传新的 pack 并将它们加入清单。第二个事务会从清单中移除输入,之后的清理过程会将它们删除。
为了横向扩展,这一过程会同时针对许多分片独立运行。每个 pack 的哈希映射到一个分片,因此增加分片和节点就能提升 compaction 吞吐量。一个经过 compaction 后仍低于大小限制的 pack,会按照自身的哈希回到某个分片中并再次合并,因此 pack 会逐级增长,直到达到限制。最终结果是:在 push 量攀升的同时,pack 数量基本保持平稳:
Compaction 会合并 pack,但会保留每一个对象。垃圾回收则是移除不再被任何内容引用的对象的步骤,例如已删除分支和 force-push 留下的对象。在我们的新架构中,垃圾回收的工作方式与 compaction 非常相似,使用专用 worker 来处理计算密集型部分。它还有一些用于安全删除数据的特殊行为,值得单独讨论。
借助这些方法,我们能够持续证明:随着写入量攀升,延迟曲线保持平稳;此外我们还有其他计划中的优化,可以让 compaction 和垃圾回收过程本身更加高效。
下一步
我们最初确立的两条原则,让这一架构的每个部分都能独立扩展。我们通过增加虚拟副本来扩展读和写。Ref-CAS 对每个引用独立排序,而不是对整个仓库排序。我们通过增加 compaction 节点来扩展维护能力。我们的目标是让每个仓库——从某个开发者的副业项目到最繁忙的 monorepo——都运行在同一套架构上,而不需要对繁忙的仓库做特殊处理。仓库不会一直很小。一个副业项目可能一夜之间就迎来大量 agent,它不应该需要我们做迁移或特殊处理才能跟上。单一架构也意味着我们做出的每一项改进都会同时惠及每个仓库。
这一基础让我们能做更多事情。接下来我们聚焦三个方向:让架构的扩展能力超出我们今天所能预测的需求,让 agent 在 GitHub 上执行工作时更高效,以及为 agentic 开发演进 Git 本身。
改进架构
我们计划进一步推进这一架构。下面每一项改进都能让仓库处理更多活动,同时减少每个请求背后的工作量:
- 只读取所需内容。从 Blob Storage 中获取单个对象,而不是包含它的整个 pack。
- 按类型组织 pack。将 commit、tree 和 blob 分别归入各自的 pack。这样许多请求触及的数据就更少。
- 部分副本。无需本地磁盘上的每个 pack 即可处理请求。
- 物化视图。以开箱即用的形式保存仓库数据,例如预打包的归档、默认分支的近实时浅拷贝,以及与每个 commit 一同存储的 agent 会话上下文。
- 全局副本。将副本放置在任意区域,靠近使用它们的工作负载。读取与最新写入之间保持在有界陈旧度之内。
- 缩容到零。让节点集群随实际活跃的仓库一起增长和收缩。
在 GitHub 上高效的 agent 操作
扩展基础设施是支持智能体的一方面。另一方面是让每个智能体操作更便宜:更少的获取字节、更少的往返次数,以及更少等待变更。这些快速跟进项中的每一项都建立在本博文的存储工作之上:
- 无需克隆即可工作。许多智能体任务从不需要完整的工作树。它们只需要少量文件和足够的上下文来进行更改。这两者都可以直接从服务器读取。
- 原子提交 API。在一次操作中提交多文件更改。整个更改要么提交,要么在冲突时被干净地拒绝。
- 事件流。智能体及其周围的系统在实时信息下工作效果最好。通用事件流让它们可以订阅变更并在变更发生时做出反应。
为智能体改进 Git
我们在 Git 本身也有工作要做。GitHub 长期以来一直是 Git 项目的贡献者,我们现在也不会停下。以下是我们乐于继续推进的一些工作示例:
- 轻量克隆。部分克隆、浅克隆和稀疏检出各自都能让智能体获取更少内容。每一种都有缺口。它们也并不总能很好地协同工作。我们希望改进每一部分并让它们相互适配。
- 消除隐藏的扩展成本。Git 仍有一些代码路径的变慢速度远快于仓库增长。最近的版本修复了其中若干项,但我们预计会发现更多。
- 更快的历史遍历。像 commit-graph 这样的元数据可以在不遍历每个提交的情况下回答 merge-base 和可达性问题。当智能体的 API 调用在服务器上转化为 Git 工作时,这一点最为重要。
- 避免常见陷阱。智能体会犯和开发者相同的错误。Git 可以捕获更多常见错误并在它们造成损害之前发出警告。
智能体已经改变了软件的构建方式。GitHub 和 Git 也随之改变。我们很高兴让这一新架构跨过起跑线。它目前处于有限私密预览阶段,并将在明年初更广泛地推出。我们迫不及待想看到,当在一个仓库上工作的智能体数量只受限于团队的想法时,团队会构建出什么。我们将与客户和 Git 社区一起持续演进 Git 和 GitHub。
标签:
- 基础设施
- 技术深度解析
作者
杰出工程师
Brian 是一名首席软件工程师,负责为 GitHub 上所有仓库交互提供支持的存储和核心服务。